



O Netdata é uma plataforma de monitoramento open-source bem conhecida, com uma arquitetura distribuída e edge-first única que habilita métricas em tempo real com granularidade de segundos. Embora essa abordagem seja poderosa para certos casos de uso, ela vem com tradeoffs: maior uso de recursos em cada nó e complexidade ao escalar para centenas de servidores.
Se você está procurando algo mais simples, a Simple Observability oferece uma alternativa leve. É construída em torno de um agente open-source que usa recursos mínimos e leva literalmente um comando para instalar. Todo o resto é configurado pela UI, então você pode pular a briga com YAML.
Neste artigo, vamos percorrer as melhores alternativas ao Netdata em 2026. Começaremos com uma visão geral do que o Netdata faz bem (e onde luta), depois cobriremos os critérios-chave que você deve considerar ao avaliar ferramentas de monitoramento. Por fim, compararemos cada opção para ajudar você a encontrar o ajuste certo para sua equipe. Se você também está avaliando outras ferramentas, confira nossos guias de alternativas ao Zabbix e alternativa ao Nagios.
Resumo rápido
| Ferramenta | Melhor para | Modelo de preço |
|---|---|---|
| Simple Observability | Simplicidade e unificação | $3 / mês / servidor |
| Prometheus & Grafana | Cloud Native / K8s | Grátis (OSS) / Gerenciado pago |
| Checkmk | TI complexa / Híbrido | ~$6 / host / mês |
| Datadog | Enterprise / Cloud | $15+ / host / mês |
| New Relic | Performance de app (APM) | Baseado em uso ($0,30/GB) |
| Icinga | Configuração flexível | Grátis (OSS) |
| Zabbix | Rede / On-prem | $50 / mês (Cloud) |
| Nagios | Estabilidade legada | $2.495+ (Licença XI) |
Visão geral do Netdata
Conhecido por
O Netdata é mais conhecido por seus dados em tempo real e alta resolução. A plataforma coleta métricas do sistema a cada segundo e mantém aproximadamente 1 segundo de latência da coleta à visualização. É feito para troubleshooting imediato quando você precisa desse nível de granularidade.
Principais recursos
- Métricas em tempo real: Granularidade de segundos para feedback imediato.
- ML não supervisionado: Detecção de anomalias embutida que sinaliza outliers sem thresholds manuais.
- Auto-discovery: Detecta automaticamente serviços e apps rodando no host.
- Arquitetura distribuída: Os dados são tipicamente armazenados no edge (no próprio nó), o que reduz custos de armazenamento central, mas aumenta o uso de recursos locais.
Por que procurar uma alternativa ao Netdata?
Embora o Netdata excel em monitoramento em tempo real de nó único, sua arquitetura cria alguns desafios práticos.
1. Escalabilidade em ambientes dinâmicos
A natureza distribuída do Netdata funciona bem para eficiência de armazenamento, mas gerenciá-la entre centenas de containers efêmeros ou microsserviços fica complicado rápido. Agregar dados de milhares de nós tipicamente exige configuração significativa, ou você acaba dependendo do Netdata Cloud, que traz seus próprios custos e complexidade.
2. Sobrecarga de recursos
Como o Netdata processa dados de alta resolução e roda detecção de anomalias diretamente em cada agente, ele usa mais CPU e RAM que forwarders leves como Telegraf ou o agente da Simple Observability. Em ambientes com recursos restritos, esse efeito observador pode ser um problema real.
3. Pilares de observabilidade ausentes
O Netdata é principalmente uma ferramenta de métricas. Recentemente adicionou tratamento de logs (indexando logs no edge), mas ainda não tem suporte nativo a tracing distribuído. Isso está no roadmap para 2026, mas se você precisa de observabilidade full-stack (métricas, logs e traces) hoje, vai precisar juntar várias ferramentas.
Como escolher uma alternativa?
Ao avaliar alternativas, considere estes critérios centrais:
- Eficiência do agente: Procure agentes leves escritos em linguagens eficientes (Go, Rust, C++) que não impactem suas workloads de produção.
- Observabilidade unificada: A ferramenta suporta métricas, logs e alertas num único painel?
- Facilidade de uso: Você consegue configurar em minutos (tempo até valor), ou exige semanas de configuração?
- Preço: O modelo de preço é previsível? Evite ferramentas com cobrança complexa baseada em uso se você tem um orçamento restrito.
8 melhores alternativas ao Netdata
1. Simple Observability
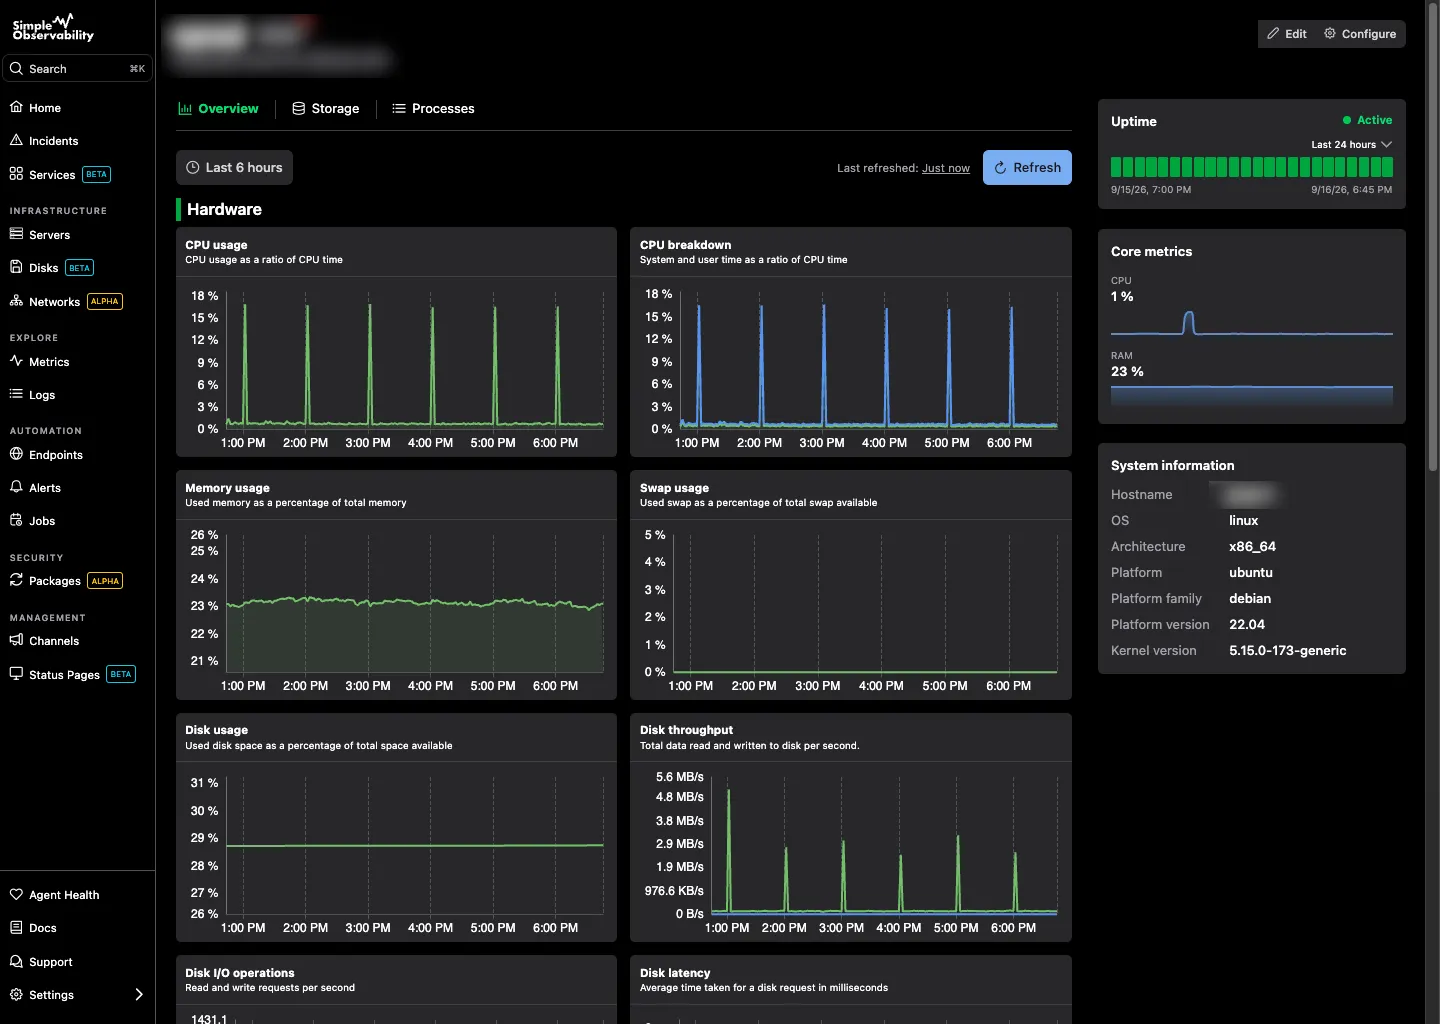
A Simple Observability é uma plataforma de monitoramento de servidores feita para ser a alternativa mais direta para equipes que querem resultados sem complicação. Combina métricas e logs numa interface unificada, substituindo indiscutivelmente três ferramentas separadas (métricas, logs, uptime) por uma só.
Principais recursos
- Dashboard unificado: Veja picos de CPU/memória junto com logs de aplicação na mesma visão.
- Alarmes sem configuração: Vem com defaults sensatos para que você esteja protegido desde o primeiro dia.
- Agente leve: Agente open-source altamente otimizado que respeita os recursos do seu servidor.
- Conveniência SaaS: Sem necessidade de hospedar seu próprio banco de métricas ou stack de retenção.
Simple Observability vs Netdata Diferente do Netdata, que pode ser esmagador com milhares de métricas out-of-the-box, a Simple Observability foca em sinal sobre ruído. Ela fornece as métricas críticas que você realmente precisa para rodar sistemas em produção, armazenadas centralmente para que você não perca dados se um nó morrer (um risco com o armazenamento local padrão do Netdata).
Prós
- Extremamente fácil de usar: Instalação com um comando, sem configuração necessária.
- Preço previsível: Taxa fixa por servidor. Sem surpresas de “por milhão de métricas customizadas” ou “por GB de log”.
- Dados históricos completos: Retenção de longo prazo incluída por padrão.
Contras
- Menos granular: Enquanto o Netdata oferece resolução de 1 segundo, a Simple Observability usa intervalos padrão de 60s para manter custos e bandwidth razoáveis.
Melhor para: Startups, agências e equipes DevOps que querem uma solução de monitoramento “set and forget” que simplesmente funciona.
Preço
- Grátis: $0 por 1 servidor.
- Pago: $3/mês por servidor para servidores ilimitados.
- Personalizado: Descontos por volume para grandes frotas.
2. Prometheus & Grafana
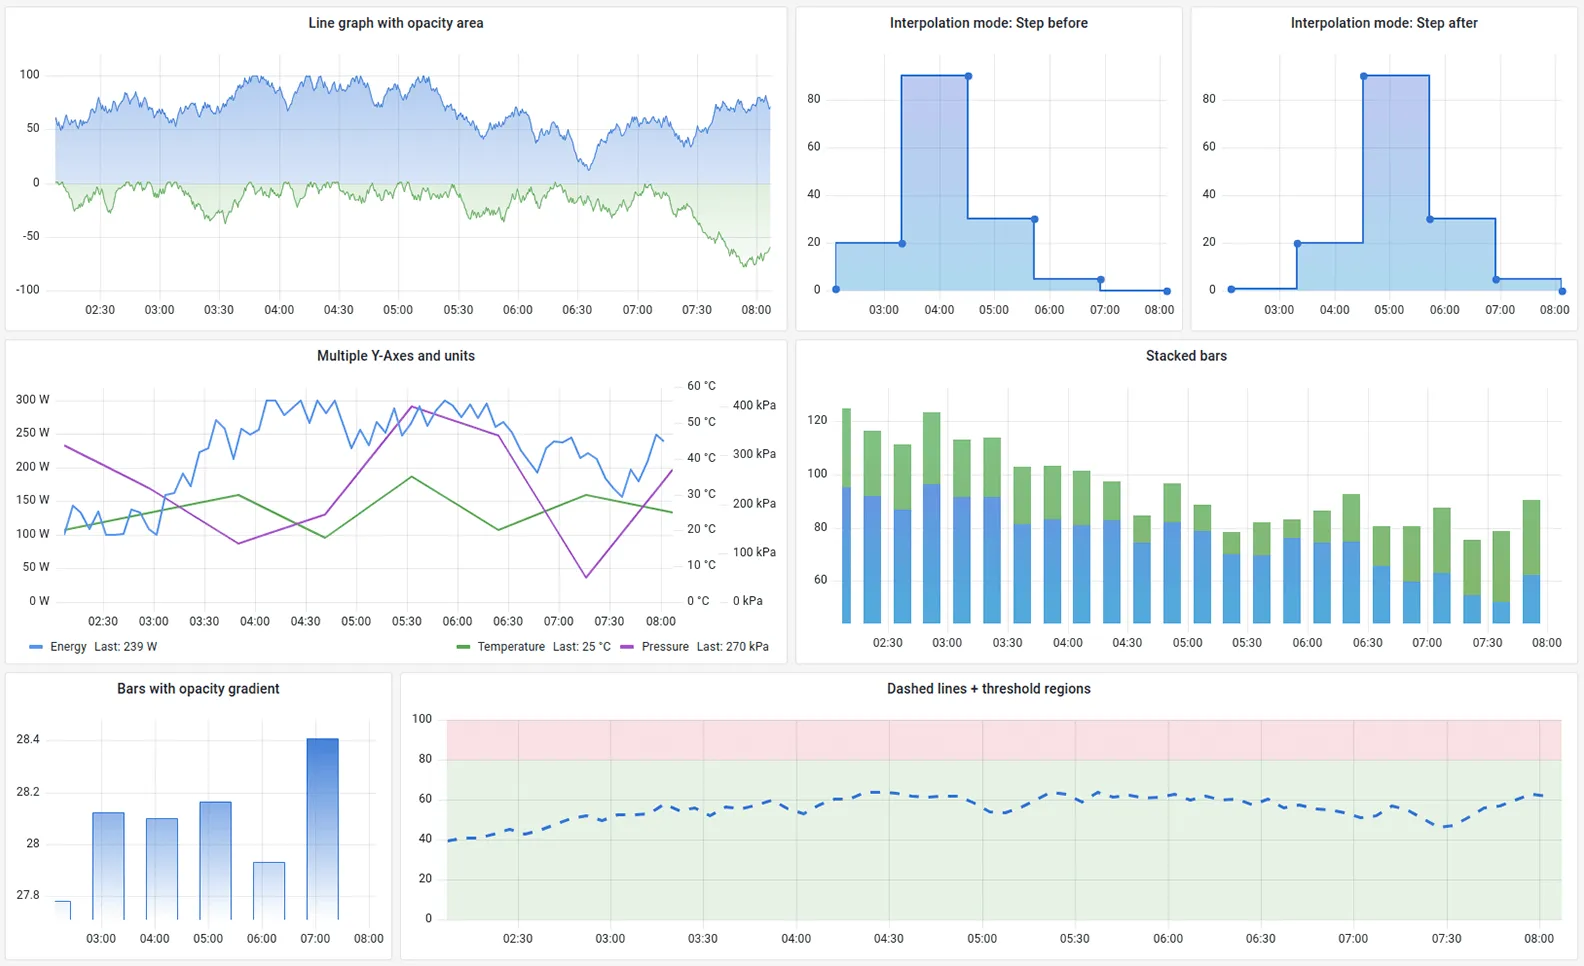
Prometheus combinado com Grafana é o padrão da indústria para monitoramento cloud-native. É uma combinação open-source poderosa onde o Prometheus coleta as métricas e o Grafana as visualiza.
Principais recursos
- Modelo de dados multidimensional: Queries poderosas usando PromQL.
- Ecossistema enorme: Exporters disponíveis para quase qualquer software existente (Redis, Postgres, Nginx, etc.).
- Alertmanager: Lida com alertas com roteamento e agrupamento sofisticados.
Prós
- Padrão da indústria: A escolha de fato para monitoramento de Kubernetes.
- Open source: Completamente gratuito para usar se self-hosted.
- Flexibilidade: Você constrói qualquer dashboard imaginável no Grafana.
Contras
- Complexidade: Exige configurar e manter duas peças de software separadas (Prometheus + Grafana).
- Armazenamento: Você é responsável por gerenciar armazenamento de longo prazo e backups (frequentemente exige adicionar Thanos ou Cortex para escalabilidade).
- Curva de aprendizado íngreme: PromQL é poderoso, mas leva tempo para dominar comparado a interfaces point-and-click.
Melhor para: Ambientes Kubernetes, equipes de platform engineering e organizações com recursos SRE dedicados.
Preço Grátis (open source). No entanto, rodar em escala geralmente exige extensões de armazenamento pagas (Thanos) ou serviços gerenciados como Grafana Cloud ou Amazon Managed Prometheus, que são baseados em uso.
3. Checkmk
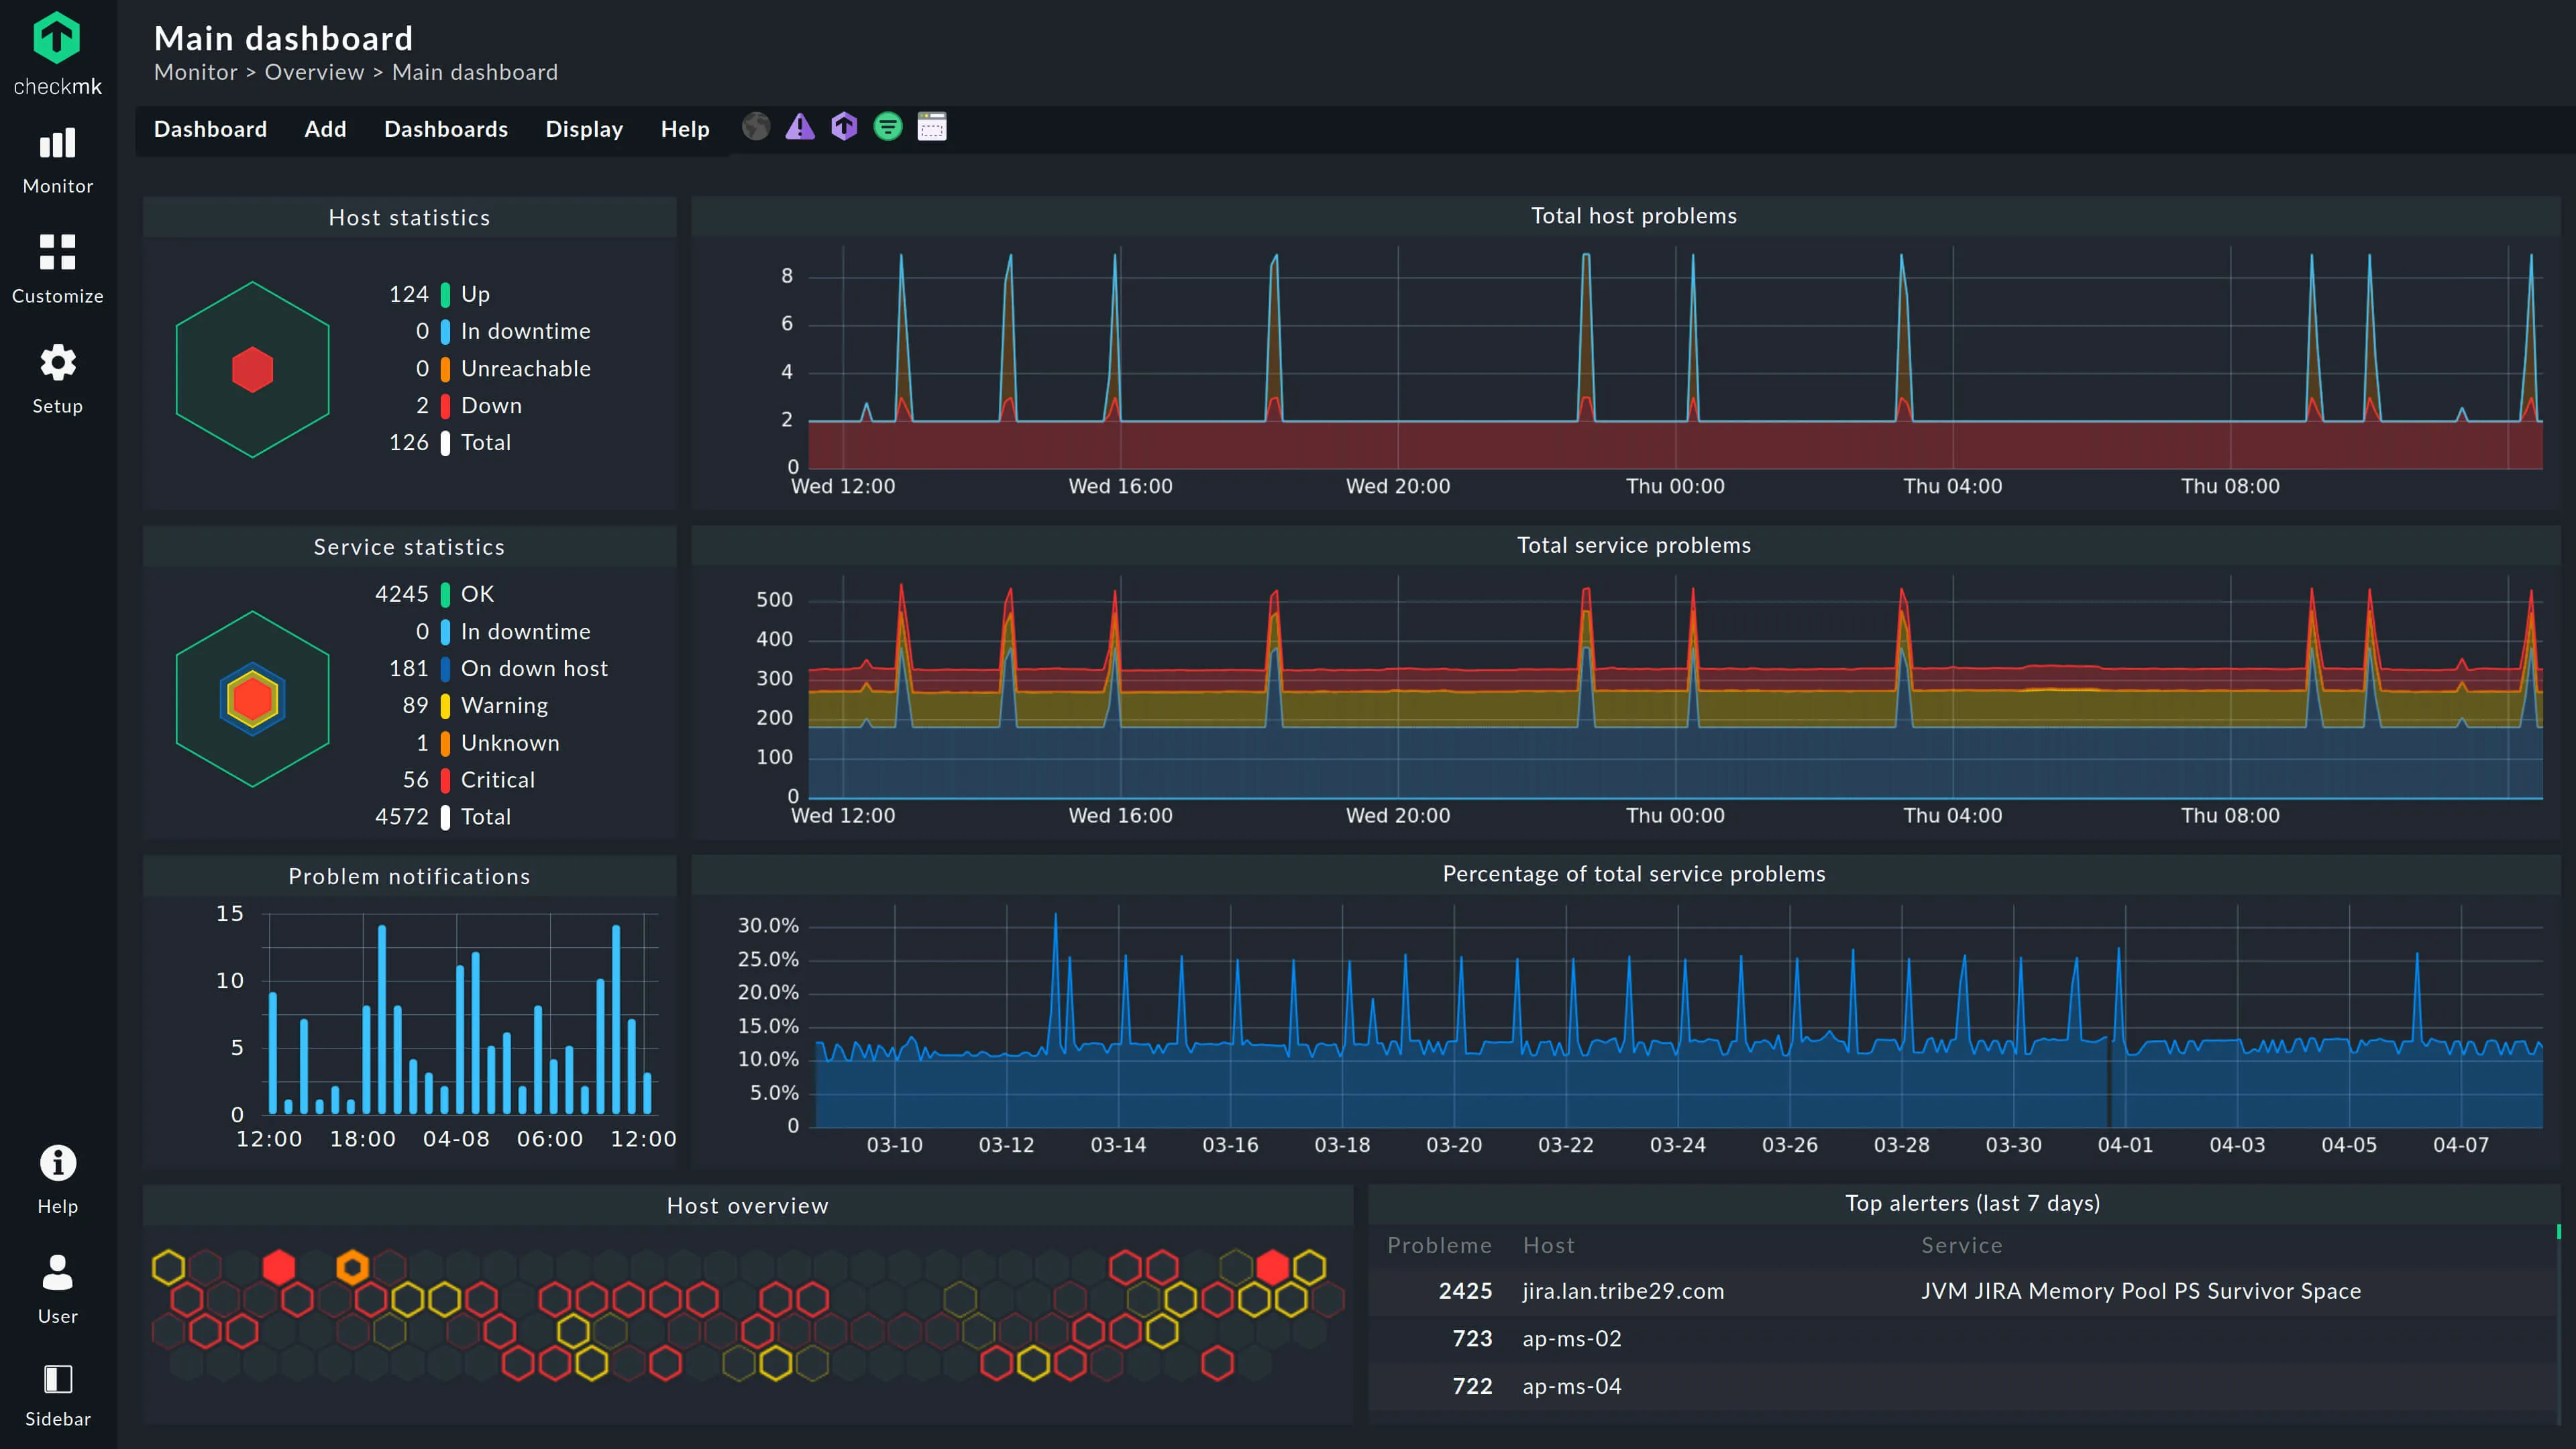
O Checkmk é uma ferramenta de monitoramento abrangente que se destaca em ambientes de TI complexos e híbridos. Faz a ponte entre checks ao estilo Nagios antigo e coleta de métricas moderna.
Principais recursos
- Monitoramento híbrido: Igualmente bom em monitorar bare metal, switches e containers Docker.
- Descoberta automática de serviços: Escaneia hosts para encontrar serviços em execução e configurar checks automaticamente.
- 2.000+ plugins: Biblioteca gigante de integrações.
Prós
- All-in-one: Lida bem tanto com monitoramento baseado em estado (Up/Down) quanto em performance de métricas.
- Escalável: Lida com milhares de serviços num único servidor graças ao seu núcleo eficiente.
Contras
- UI/UX: A interface, embora funcional, pode parecer congestionada e datada comparada a ferramentas SaaS modernas.
- Configuração: Extremamente poderosa, mas tem uma curva de aprendizado íngreme para recursos avançados.
Melhor para: Sysadmins e departamentos de TI que gerenciam um mix de hardware legado, servidores on-prem e instâncias cloud.
Preço A edição Open Source é gratuita. Enterprise começa em ~$2.100/ano para 3.000 serviços (aprox. 100 hosts). Edições SaaS começam em ~$6 por host/mês (cobrado por serviço).
4. Datadog
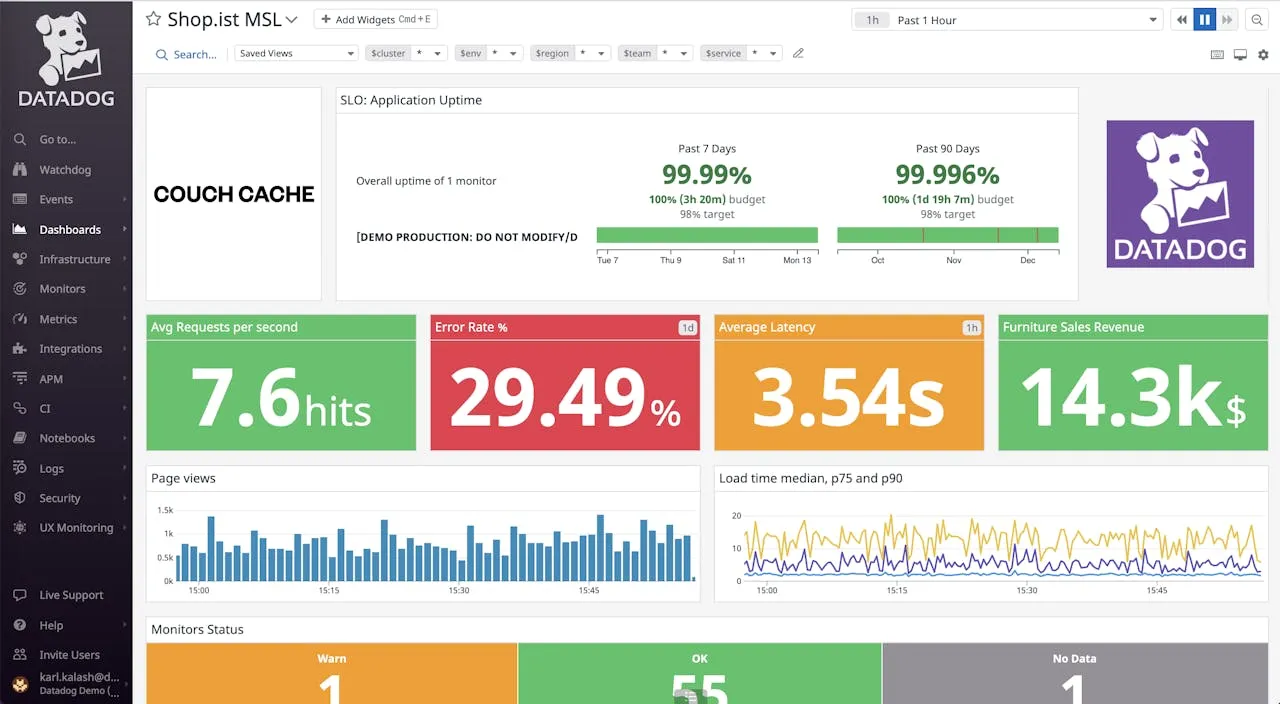
A Datadog é o gorila de 800 quilos do espaço de observabilidade. Oferece uma plataforma massiva e unificada cobrindo todos os ângulos possíveis de monitoramento: Infraestrutura, APM, Logs, Segurança, Rede e RUM.
Principais recursos
- Observabilidade full-stack: Correlação de dados verdadeiramente unificada entre traces, logs e métricas.
- Watchdog AI: Detecção de anomalias automatizada que frequentemente identifica problemas antes de você.
- 400+ integrações: Integrações point-and-click para AWS, Azure, Google Cloud e ferramentas SaaS.
Prós
- UI polida: Intuitiva, rápida e genuinamente agradável de usar.
- Visibilidade profunda: O nível de insight para APM e tracing é inigualável.
Contras
- Custo: Infamemente cara. O preço “por host” é só o ingresso de entrada; métricas customizadas, ingestão de logs e retenção somam rápido.
- Vendor lock-in: O agente proprietário e o formato de dados tornam difícil sair uma vez que você está profundamente integrado.
Melhor para: Grandes empresas e tech companies de alto crescimento onde a velocidade de engenharia vale mais do que otimizar a conta de monitoramento.
Preço Infraestrutura começa em $15/host/mês. No entanto, esse raramente é o preço final. APM, Logs ($0,10/GB indexados) e Custom Metrics são todos cobrados separadamente, frequentemente dobrando ou triplicando o custo base em produção.
5. New Relic
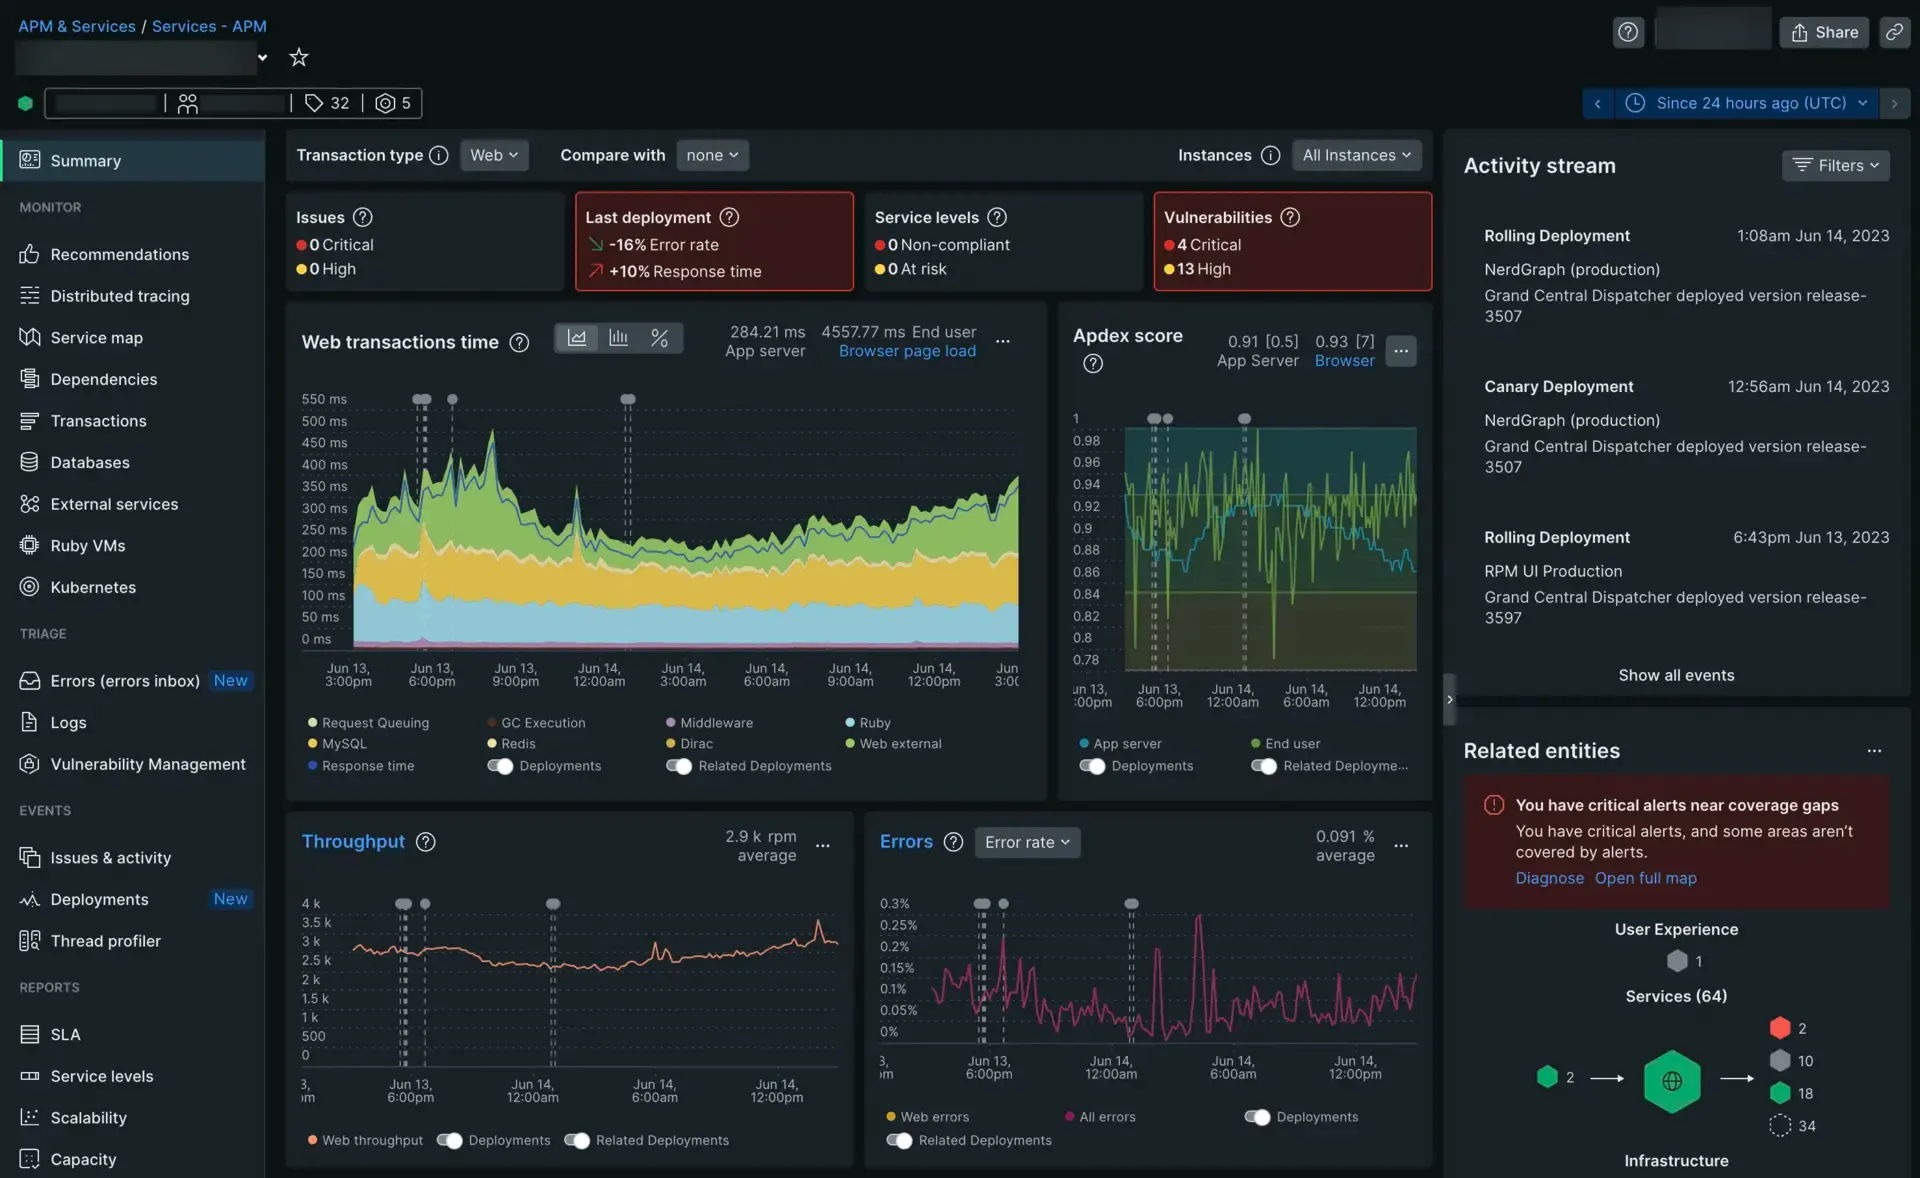
A New Relic é uma veterana no espaço de APM que evoluiu para uma plataforma de observabilidade full-stack. É particularmente forte para desenvolvedores que precisam de visibilidade profunda em nível de código para debugar problemas de performance de aplicação.
Principais recursos
- APM profundo: Tracing em nível de código para identificar queries de banco lentas ou funções ineficientes.
- Browser e mobile: Suporte nativo para rastrear a experiência do usuário final (RUM) em apps web e mobile.
- Inteligência aplicada: Insights orientados por IA para detectar anomalias e correlacionar eventos.
Prós
- Plataforma de dados unificada: Toda a telemetria (métricas, logs, traces) é armazenada num só lugar.
- Free tier: Free tier generoso (100 GB/mês) para equipes pequenas.
Contras
- Complexidade: A plataforma é vasta, e navegar na UI pode ser esmagador para necessidades simples.
- Modelo de preço: Embora o free tier seja bom, o preço por usuário para acesso completo pode ficar caro para equipes maiores.
Melhor para: Equipes de desenvolvimento focadas em monitoramento de performance de aplicações (APM) e debugging full-stack.
Preço Baseado em uso: grátis para 100 GB/mês. Planos pagos começam em $0,30/GB ingeridos + taxas de assento por usuário ($99/mês para Core, $549/mês para Plus).
6. Icinga
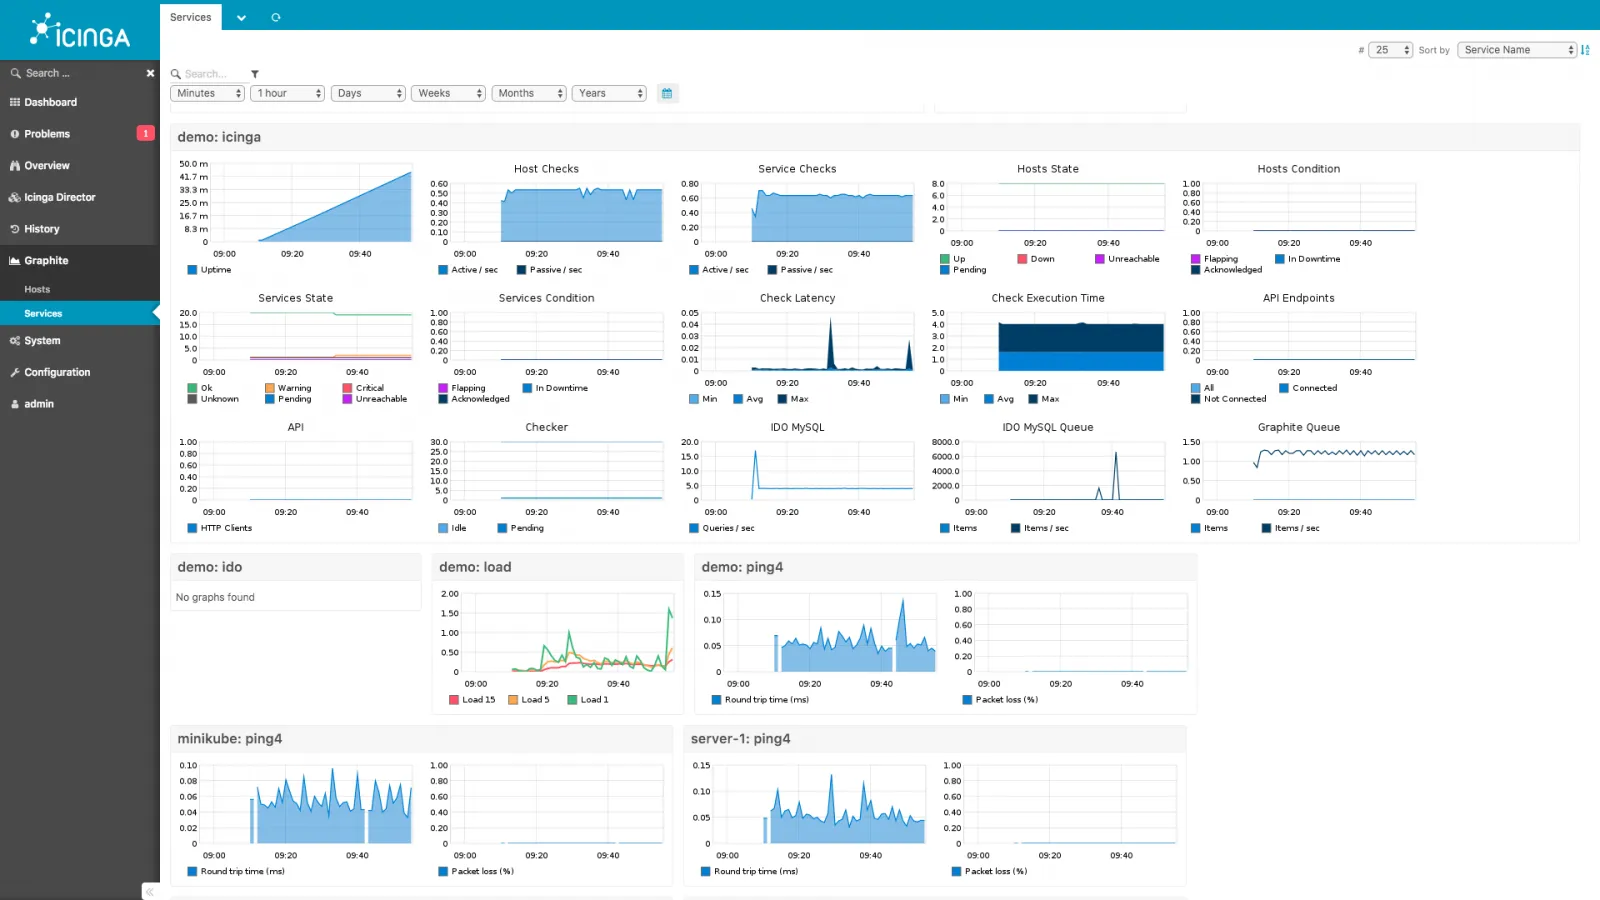
Nascido como um fork do Nagios, o Icinga modernizou a abordagem clássica de monitoramento. Mantém a compatibilidade com plugins do Nagios, mas adiciona uma interface web moderna, uma API de configuração robusta e recursos de escalabilidade.
Principais recursos
- Icinga Director: Uma ferramenta web para gerenciar configuração, tornando mais fácil que editar arquivos de config.
- Monitoramento distribuído: Suporte embutido para setups distribuídos e alta disponibilidade.
- Compatibilidade de plugins: Compatível com milhares de plugins existentes do Nagios.
Prós
- Clássico modernizado: Tenha a confiabilidade do Nagios com uma UI e API muito melhores.
- Suporte comercial: Disponível para implantações enterprise onde “gratuito” não é suficiente.
Contras
- Esforço de setup: Ainda exige configuração e setup significativos comparado a ferramentas SaaS.
- Curva de aprendizado: Entender a linguagem de configuração e o modelo de objetos leva tempo.
Melhor para: Sysadmins que amam a flexibilidade do Nagios, mas querem uma ferramenta mais moderna, orientada por API e escalável.
Preço Grátis (open source). Suporte comercial está disponível.
7. Zabbix
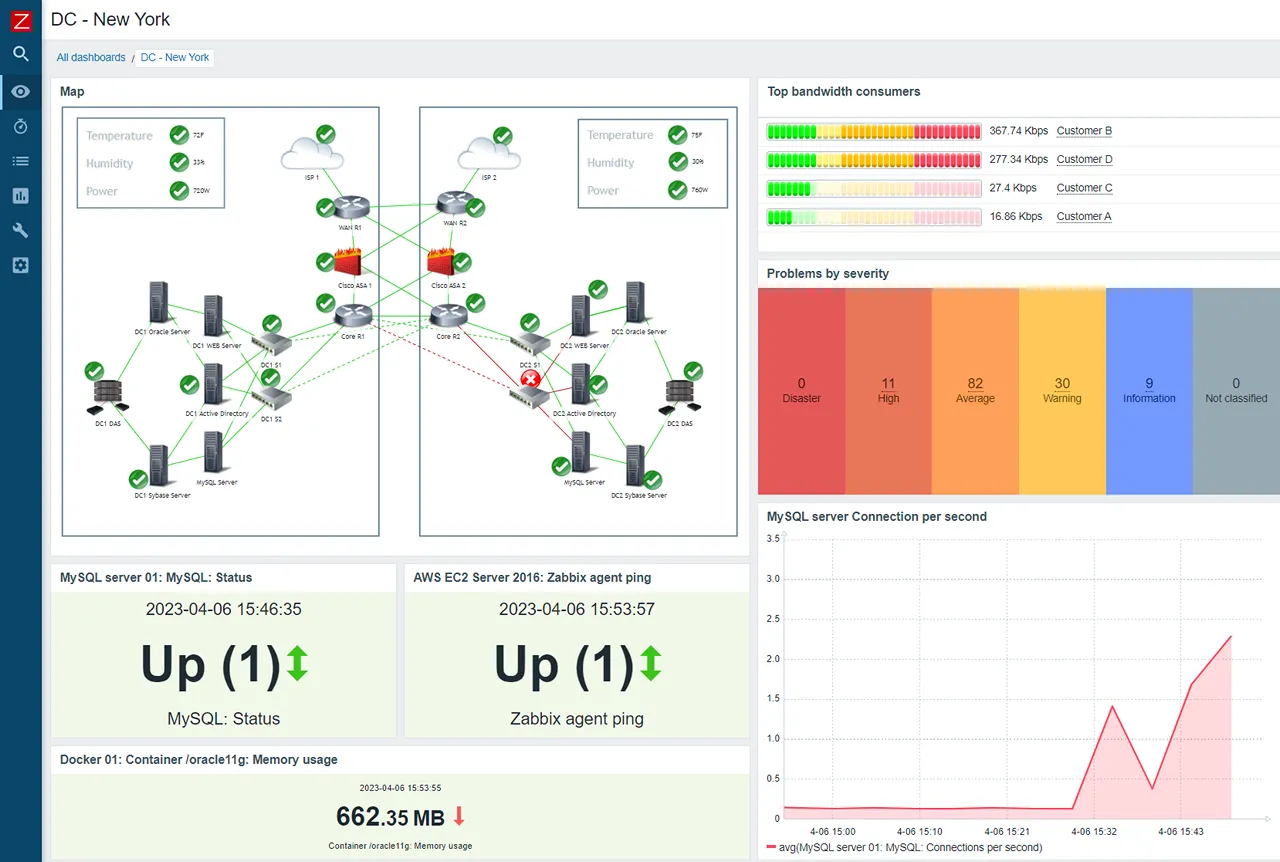
O Zabbix é uma plataforma open-source madura e de nível enterprise. É um tradicional peso-pesado do monitoramento, favorecido por engenheiros de rede e grandes empresas tradicionais.
Principais recursos
- Com e sem agente: Pode monitorar via SNMP, JMX, IPMI e seu próprio agente.
- Push e pull: Suporta tanto polling quanto trapping como métodos de coleta de dados.
- Permissões granulares: Excelente multi-tenancy e controles de permissão de usuário.
Prós
- Disponibilidade SaaS: O Zabbix Cloud oferece um caminho gerenciado para equipes que não querem a sobrecarga de self-hosting.
- Comprovado: Testado em batalha em ambientes enormes por décadas.
Contras
- Complexidade: A configuração pode ser muito verbosa (XML/Templates) e consumir tempo.
- Modernidade: Carece das integrações cloud-native fluidas e da sensação fluida de ferramentas modernas de observabilidade.
Melhor para: Centros de operações de rede (NOCs), MSPs e organizações com infraestrutura on-prem pesada que exigem suporte dedicado ou um ambiente de monitoramento gerenciado.
Preço Embora o software seja open source, o uso profissional frequentemente gravita em torno do Zabbix Cloud, que começa em $50/mês. Suporte e treinamento de nível enterprise também são serviços pagos.
8. Nagios
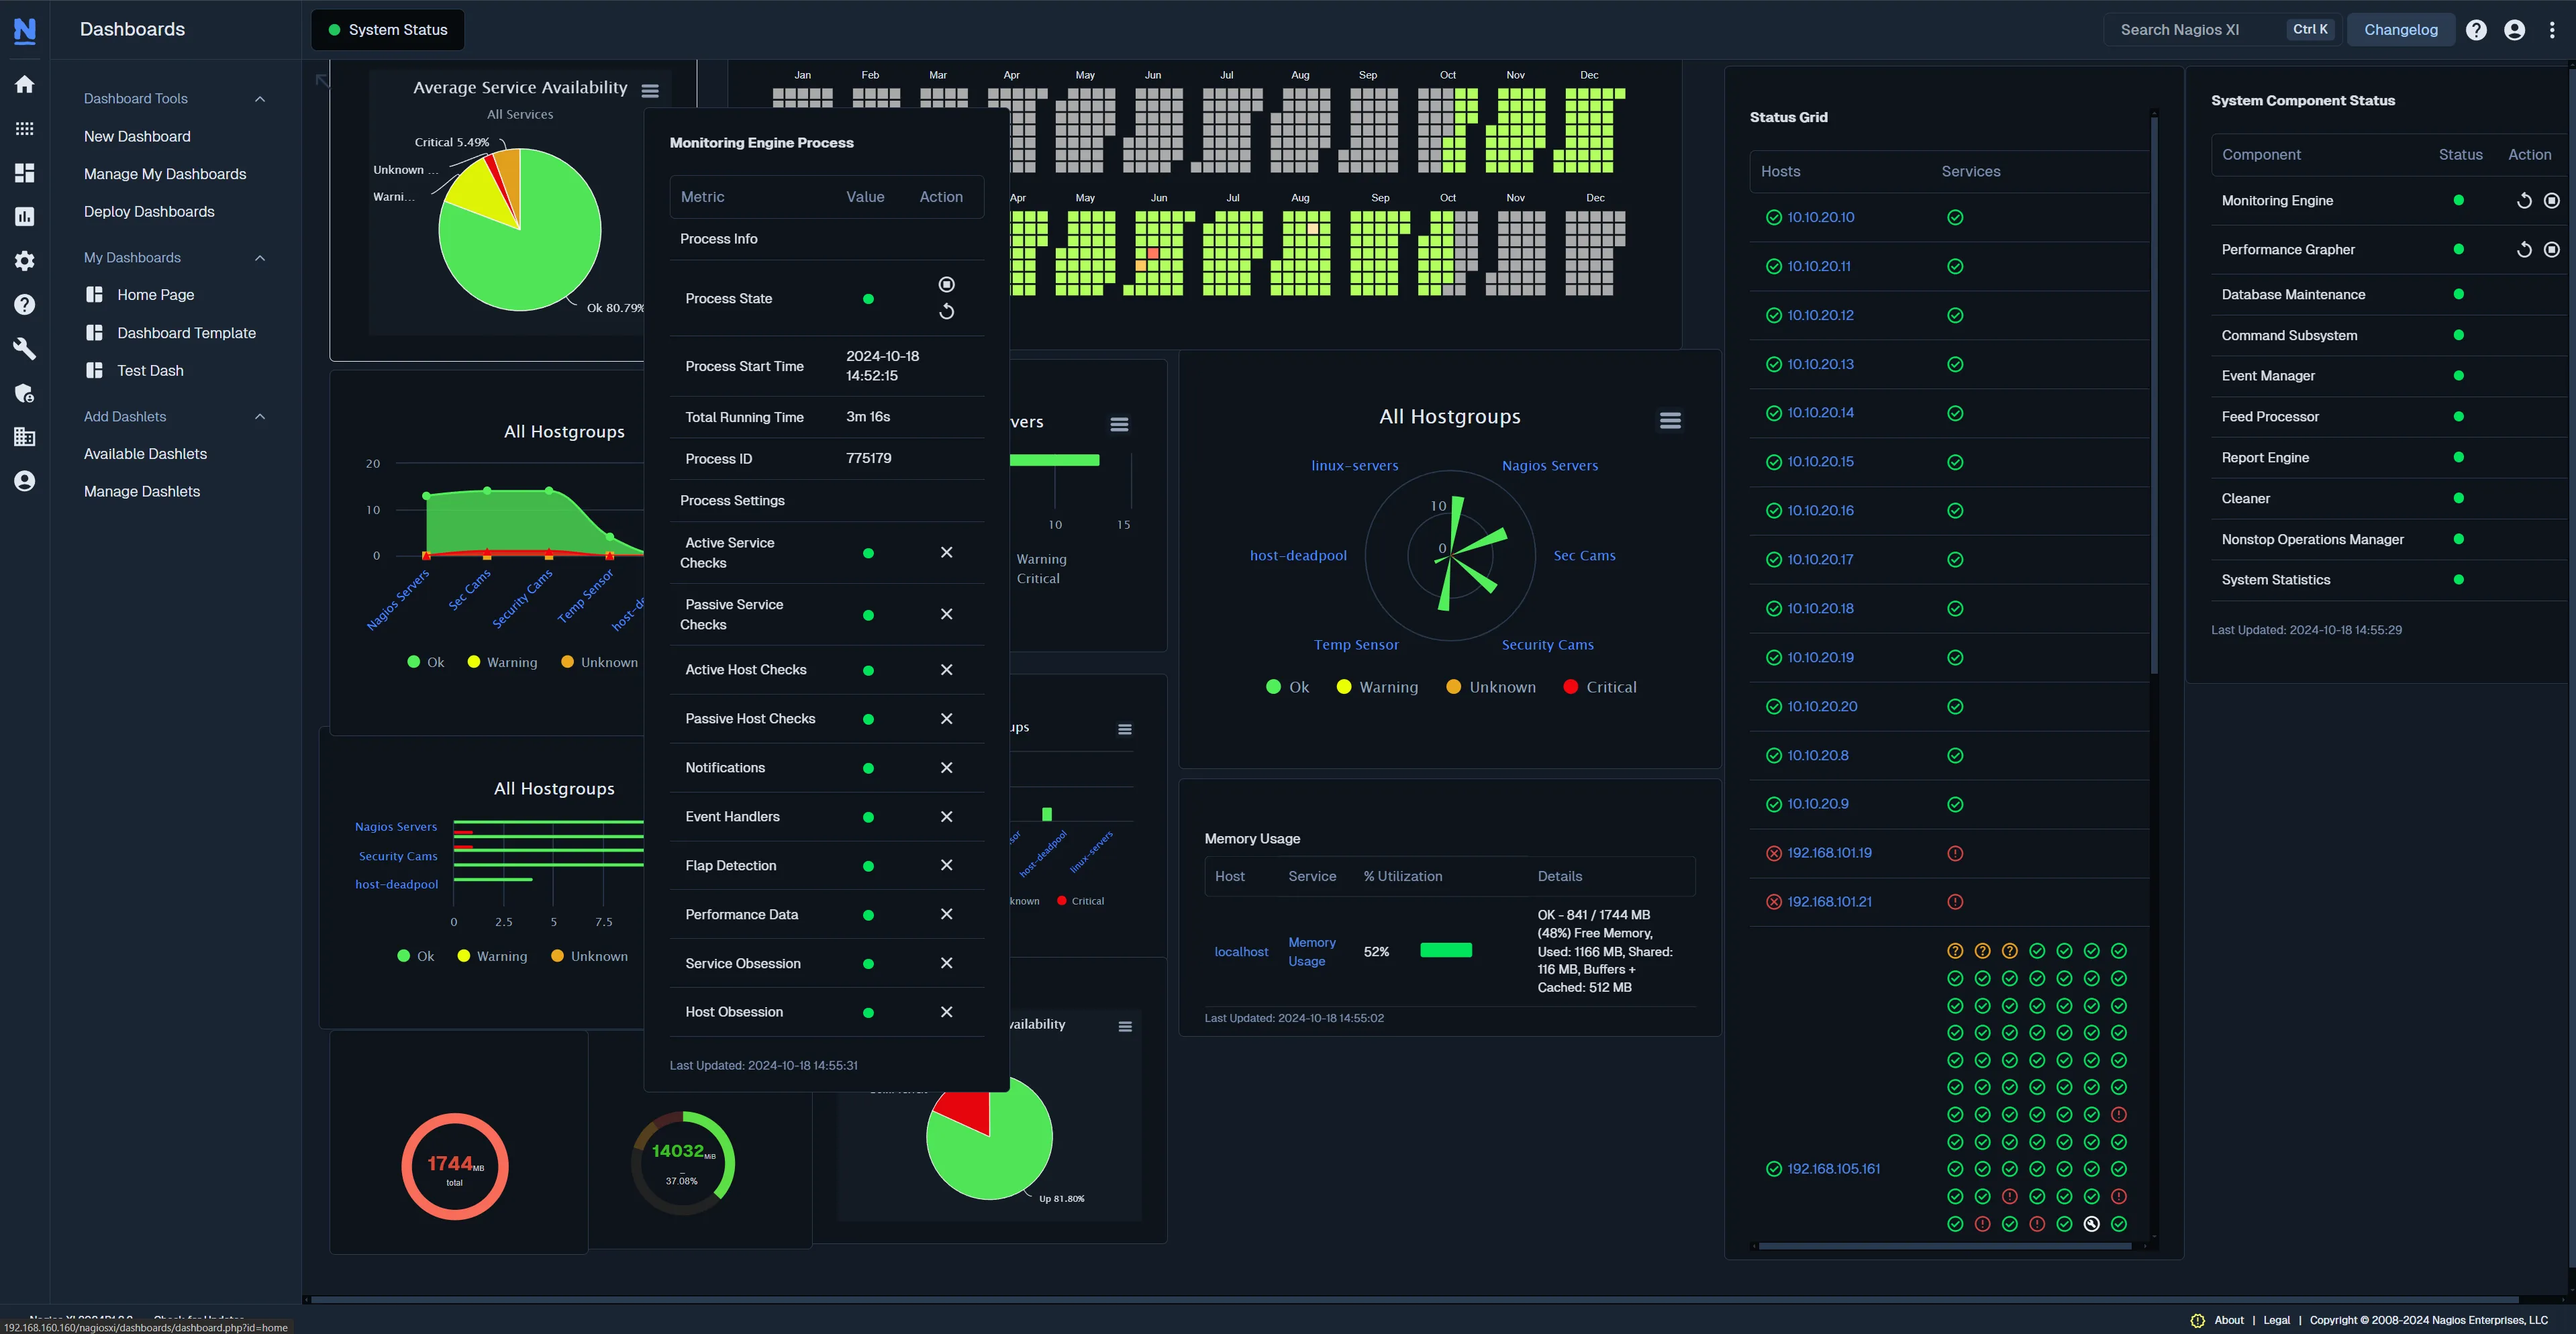
O Nagios é o “avô” do monitoramento. Embora efetivamente considerado tecnologia legado pelos padrões modernos, ainda é amplamente implantado devido à sua estabilidade e vasto ecossistema de scripts de check.
Principais recursos
- Ecossistema de plugins: Se um dispositivo existe, provavelmente há um script Perl ou Bash para monitorá-lo no Nagios.
- Foco em estado binário: Excelente em alertas definitivos de “OK/CRITICAL”.
Prós
- Confiabilidade: Extremamente estável e simples em sua lógica.
- Universal: Quase todo sysadmin sabe ler um alerta do Nagios.
Contras
- Defasado: A configuração é baseada em arquivos e frágil. A UI é de outra era.
- Métricas: É fundamentalmente uma ferramenta de checagem de status, não uma ferramenta de métricas/gráficos. Você geralmente precisa emparelhá-lo com outra coisa para gráficos.
Melhor para: Ambientes legados onde “em time que está ganhando não se mexe” se aplica, ou para checks de hardware muito específicos que apenas plugins do Nagios suportam.
Preço O Nagios Core (open source) é gratuito. Nagios XI (comercial) começa em $2.495 para uma licença padrão (até 100 nós).
Conclusão
O Netdata é uma ferramenta fantástica para o que faz: dar a você um olhar de altíssima resolução sobre um único servidor, efetivamente de graça. Mas para muitas equipes, a complexidade de escalá-lo e a falta de logs integrados e histórico de alertas o tornam um degrau em vez de um destino final.
- Para o melhor equilíbrio entre simplicidade e poder: Experimente a Simple Observability. Ela simplifica o caos num dashboard limpo e acionável.
- Para Kubernetes/cloud-native: Vá de Prometheus + Grafana.
- Para orçamentos enterprise robustos: Datadog é a escolha de luxo.
Escolha a ferramenta que se encaixa nas habilidades da sua equipe e no orçamento da sua organização. Para comparações diretas, confira nossas análises de Netdata vs Zabbix e Netdata vs Prometheus.