


Netdata 是知名的开源监控平台,采用独特的边优先(edge-first)分布式架构,能够以秒级粒度提供实时指标。这种方式在某些场景下表现出色,但也有代价:每个节点资源占用更高,扩展到数百台服务器时复杂度也会上升。
如果你想要更简单的方案,Simple Observability 是一个轻量级替代选择。它基于开源 agent 构建,资源占用极低,一条命令即可完成安装。其余配置全部在 UI 中完成,无需折腾 YAML。
本文将盘点 2026 年最值得关注的 Netdata 替代方案。我们会先概述 Netdata 的优势与短板,再梳理评估监控工具时的关键标准,最后逐项对比,帮你为团队选到合适的工具。如果你也在考察其他工具,可以参阅我们的 Zabbix 替代方案 和 Nagios 替代方案 指南。
快速概览
| 工具 | 适用场景 | 计费方式 |
|---|---|---|
| Simple Observability | 简单易用、统一平台 | $3 / 月 / 服务器 |
| Prometheus & Grafana | 云原生 / K8s | 免费(开源)/ 托管版付费 |
| Checkmk | 复杂 IT / 混合环境 | 约 $6 / 主机 / 月 |
| Datadog | 企业级 / 云端 | $15+ / 主机 / 月 |
| New Relic | 应用性能(APM) | 按用量计费($0.30/GB) |
| Icinga | 灵活配置 | 免费(开源) |
| Zabbix | 网络 / 本地部署 | $50 / 月(云端版) |
| Nagios | 老牌稳定 | $2,495+(XI 授权) |
Netdata 概览
优势
Netdata 最突出的特点是实时、高分辨率数据。平台每秒采集一次系统指标,从采集到可视化的延迟大约只有 1 秒。当你需要这种粒度来进行即时排障时,它的设计初衷正是为此。
核心特性
- 实时指标: 秒级粒度,反馈即时。
- 无监督机器学习: 内置异常检测,无需手动设置阈值即可标记异常。
- 自动发现: 自动检测主机上运行的服务和应用。
- 分布式架构: 数据通常存储在边缘(即节点本地),降低中心存储成本,但会增加本地资源占用。
为什么要找 Netdata 替代方案?
Netdata 在实时单节点监控上表现优异,但它的架构也带来一些实际问题。
1. 动态环境下的扩展性
Netdata 的分布式特性在存储效率上表现不错,但要在数百个临时容器或微服务之间管理它,复杂度很快就会上来。从数千个节点聚合数据通常需要大量配置,否则只能依赖 Netdata Cloud,而这又带来额外的成本和复杂度。
2. 资源开销
由于 Netdata 在每个 agent 上直接处理高分辨率数据并运行异常检测,它的 CPU 和内存占用比 Telegraf 或 Simple Observability agent 这类轻量转发器更高。在资源受限的环境中,这种观测者效应可能成为真正的问题。
3. 可观测性支柱缺失
Netdata 本质上还是一个指标工具。它最近加入了日志处理(在边缘对日志建立索引),但仍缺少原生的分布式链路追踪支持。这项能力已列入其 2026 年路线图,但如果你现在就需要全栈可观测性(指标、日志、链路),就得自己拼凑多套工具。
如何选择替代方案?
评估替代方案时,可以重点考察以下几条核心标准:
- Agent 效率: 选择用高效语言(Go、Rust、C++)编写的轻量 agent,避免影响生产负载。
- 统一可观测性: 该工具是否能在同一个界面中同时支持指标、日志和告警?
- 易用性: 几分钟就能上手(Time-to-Value),还是需要几周时间配置?
- 价格: 计费模式是否可预测?如果预算严格,尽量避开计费规则复杂的按量计费工具。
八大最佳 Netdata 替代方案
1. Simple Observability
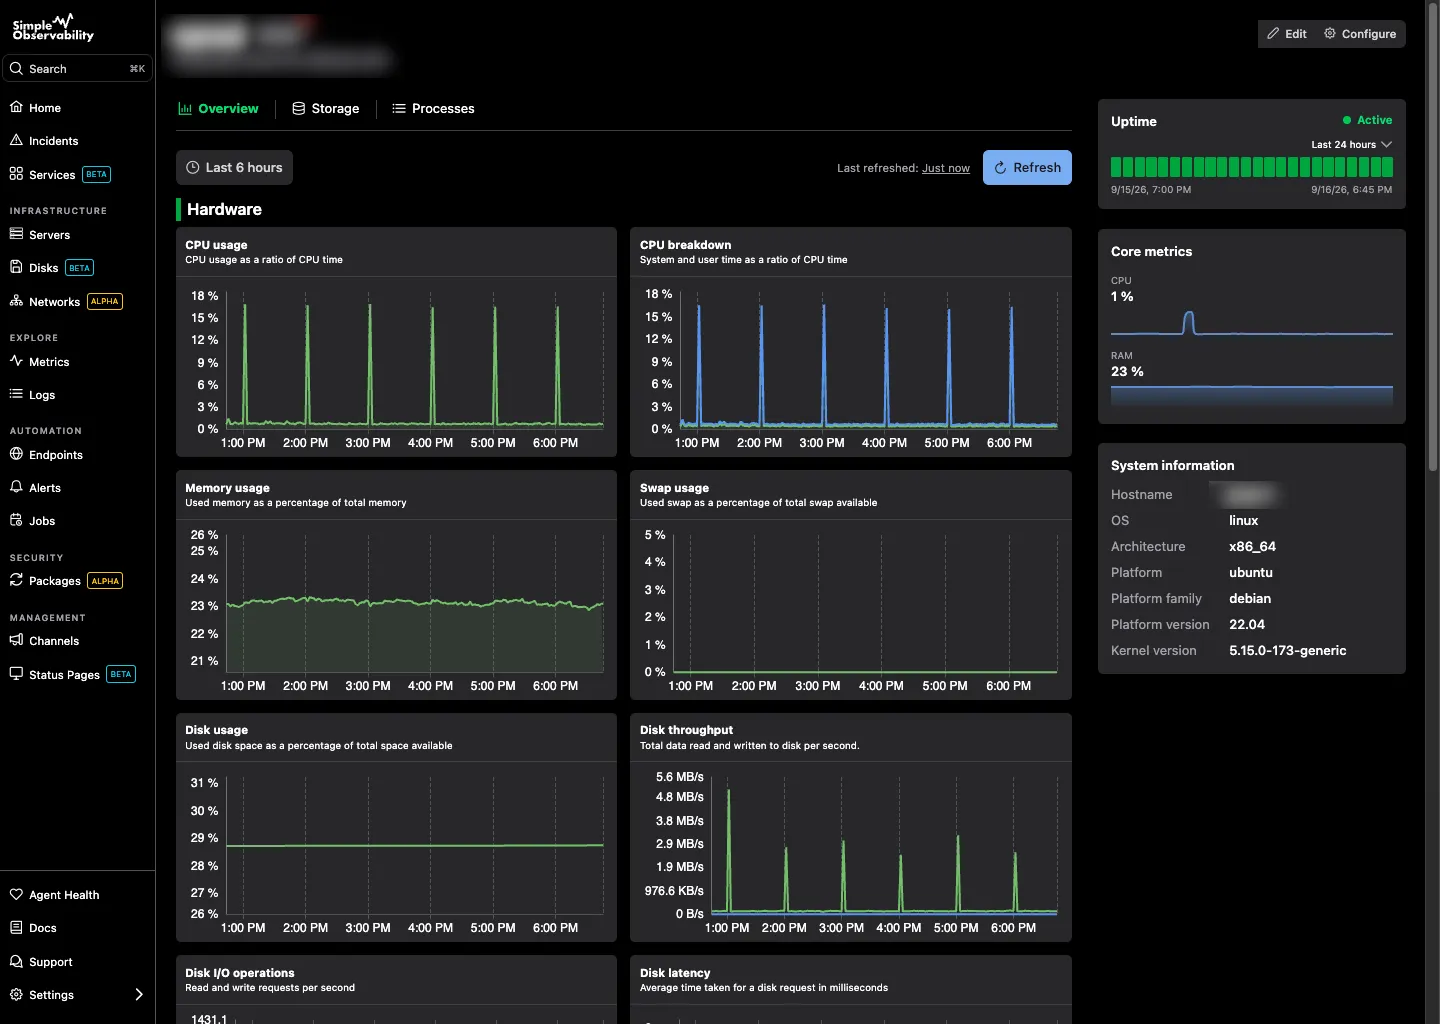
Simple Observability 是一款服务器监控平台,定位是为那些想省心拿结果的团队提供最直接的替代方案。它把指标和日志整合到统一界面中,相当于用一套工具替代了原本的三套(指标、日志、可用性监控)。
核心特性
- 统一仪表盘: 在同一视图中查看 CPU/内存尖峰与应用日志。
- 零配置告警: 内置合理默认值,从第一天起就有保障。
- 轻量 agent: 高度优化的开源 agent,尊重服务器资源。
- SaaS 便利: 无需自建指标数据库或数据保留栈。
Simple Observability 与 Netdata 对比 Netdata 开箱即用就有数千项指标,容易让人无所适从;Simple Observability 则强调信号优先、噪声次之。它只提供你运营生产系统真正需要的关键指标,并集中存储,即便某个节点宕机也不会丢数据(而 Netdata 默认本地存储存在这一风险)。
优点
- 极易上手: 一条命令安装,零配置。
- 价格可预测: 每台服务器固定费用,不会出现”每百万自定义指标”或”每 GB 日志”的意外账单。
- 完整历史数据: 默认包含长期数据保留。
缺点
- 粒度略粗: Netdata 提供 1 秒分辨率,Simple Observability 则采用标准 60 秒间隔,以控制成本和带宽。
适用对象: 希望拥有”装好即忘”的监控方案、开箱即用的初创团队、外包公司和 DevOps 团队。
价格
- 免费版: 1 台服务器 $0。
- 付费版: 每台服务器 $3/月,服务器数量不限。
- 定制版: 大规模集群享批量折扣。
2. Prometheus & Grafana
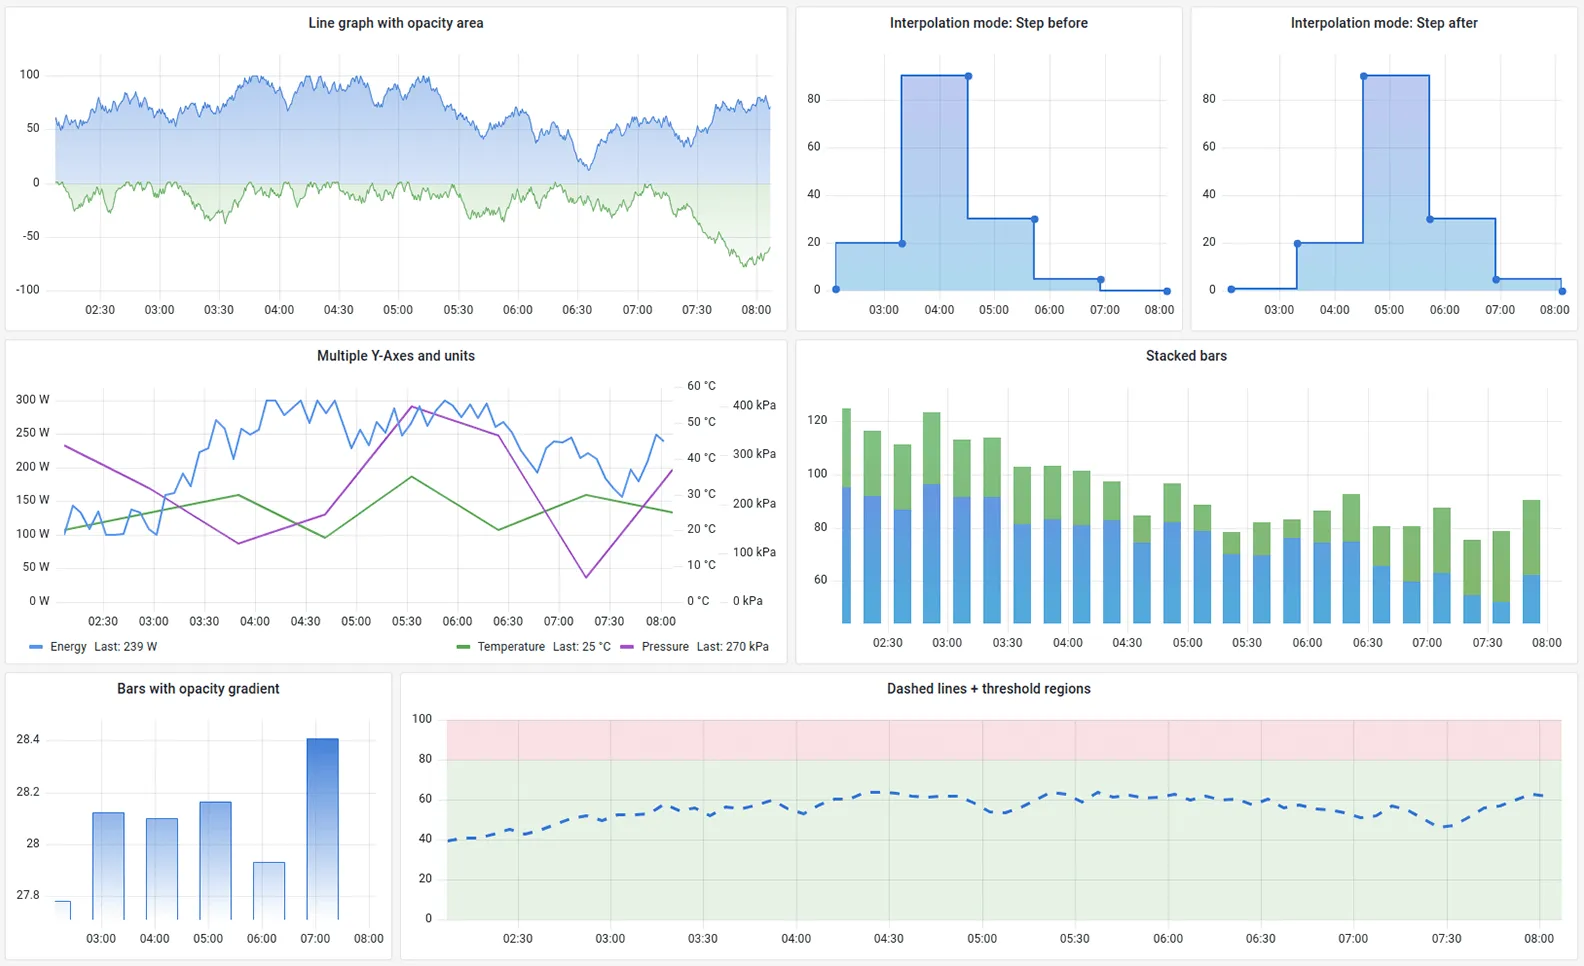
Prometheus 配合 Grafana 是云原生监控的行业标准。这是一套强大的开源组合:Prometheus 负责采集指标,Grafana 负责可视化。
核心特性
- 多维数据模型: 通过 PromQL 进行强大查询。
- 庞大生态: 几乎所有主流软件都有现成的 exporter(Redis、Postgres、Nginx 等)。
- Alertmanager: 通过精细的路由和分组机制处理告警。
优点
- 行业标准: Kubernetes 监控的事实之选。
- 开源: 自托管完全免费。
- 灵活性: 在 Grafana 中几乎能搭建任何你想要的仪表盘。
缺点
- 复杂度: 需要部署并维护两套独立软件(Prometheus + Grafana)。
- 存储: 长期存储和备份需自行管理(扩展时通常还要引入 Thanos 或 Cortex)。
- 学习曲线陡峭: PromQL 功能强大,但相比所见即所得的界面,掌握它需要更多时间。
适用对象: Kubernetes 环境、平台工程团队,以及有专职 SRE 资源的组织。
价格 免费(开源)。但在大规模使用时,通常需要付费的存储扩展(Thanos),或 Grafana Cloud、Amazon Managed Prometheus 这类按用量计费的托管服务。
3. Checkmk
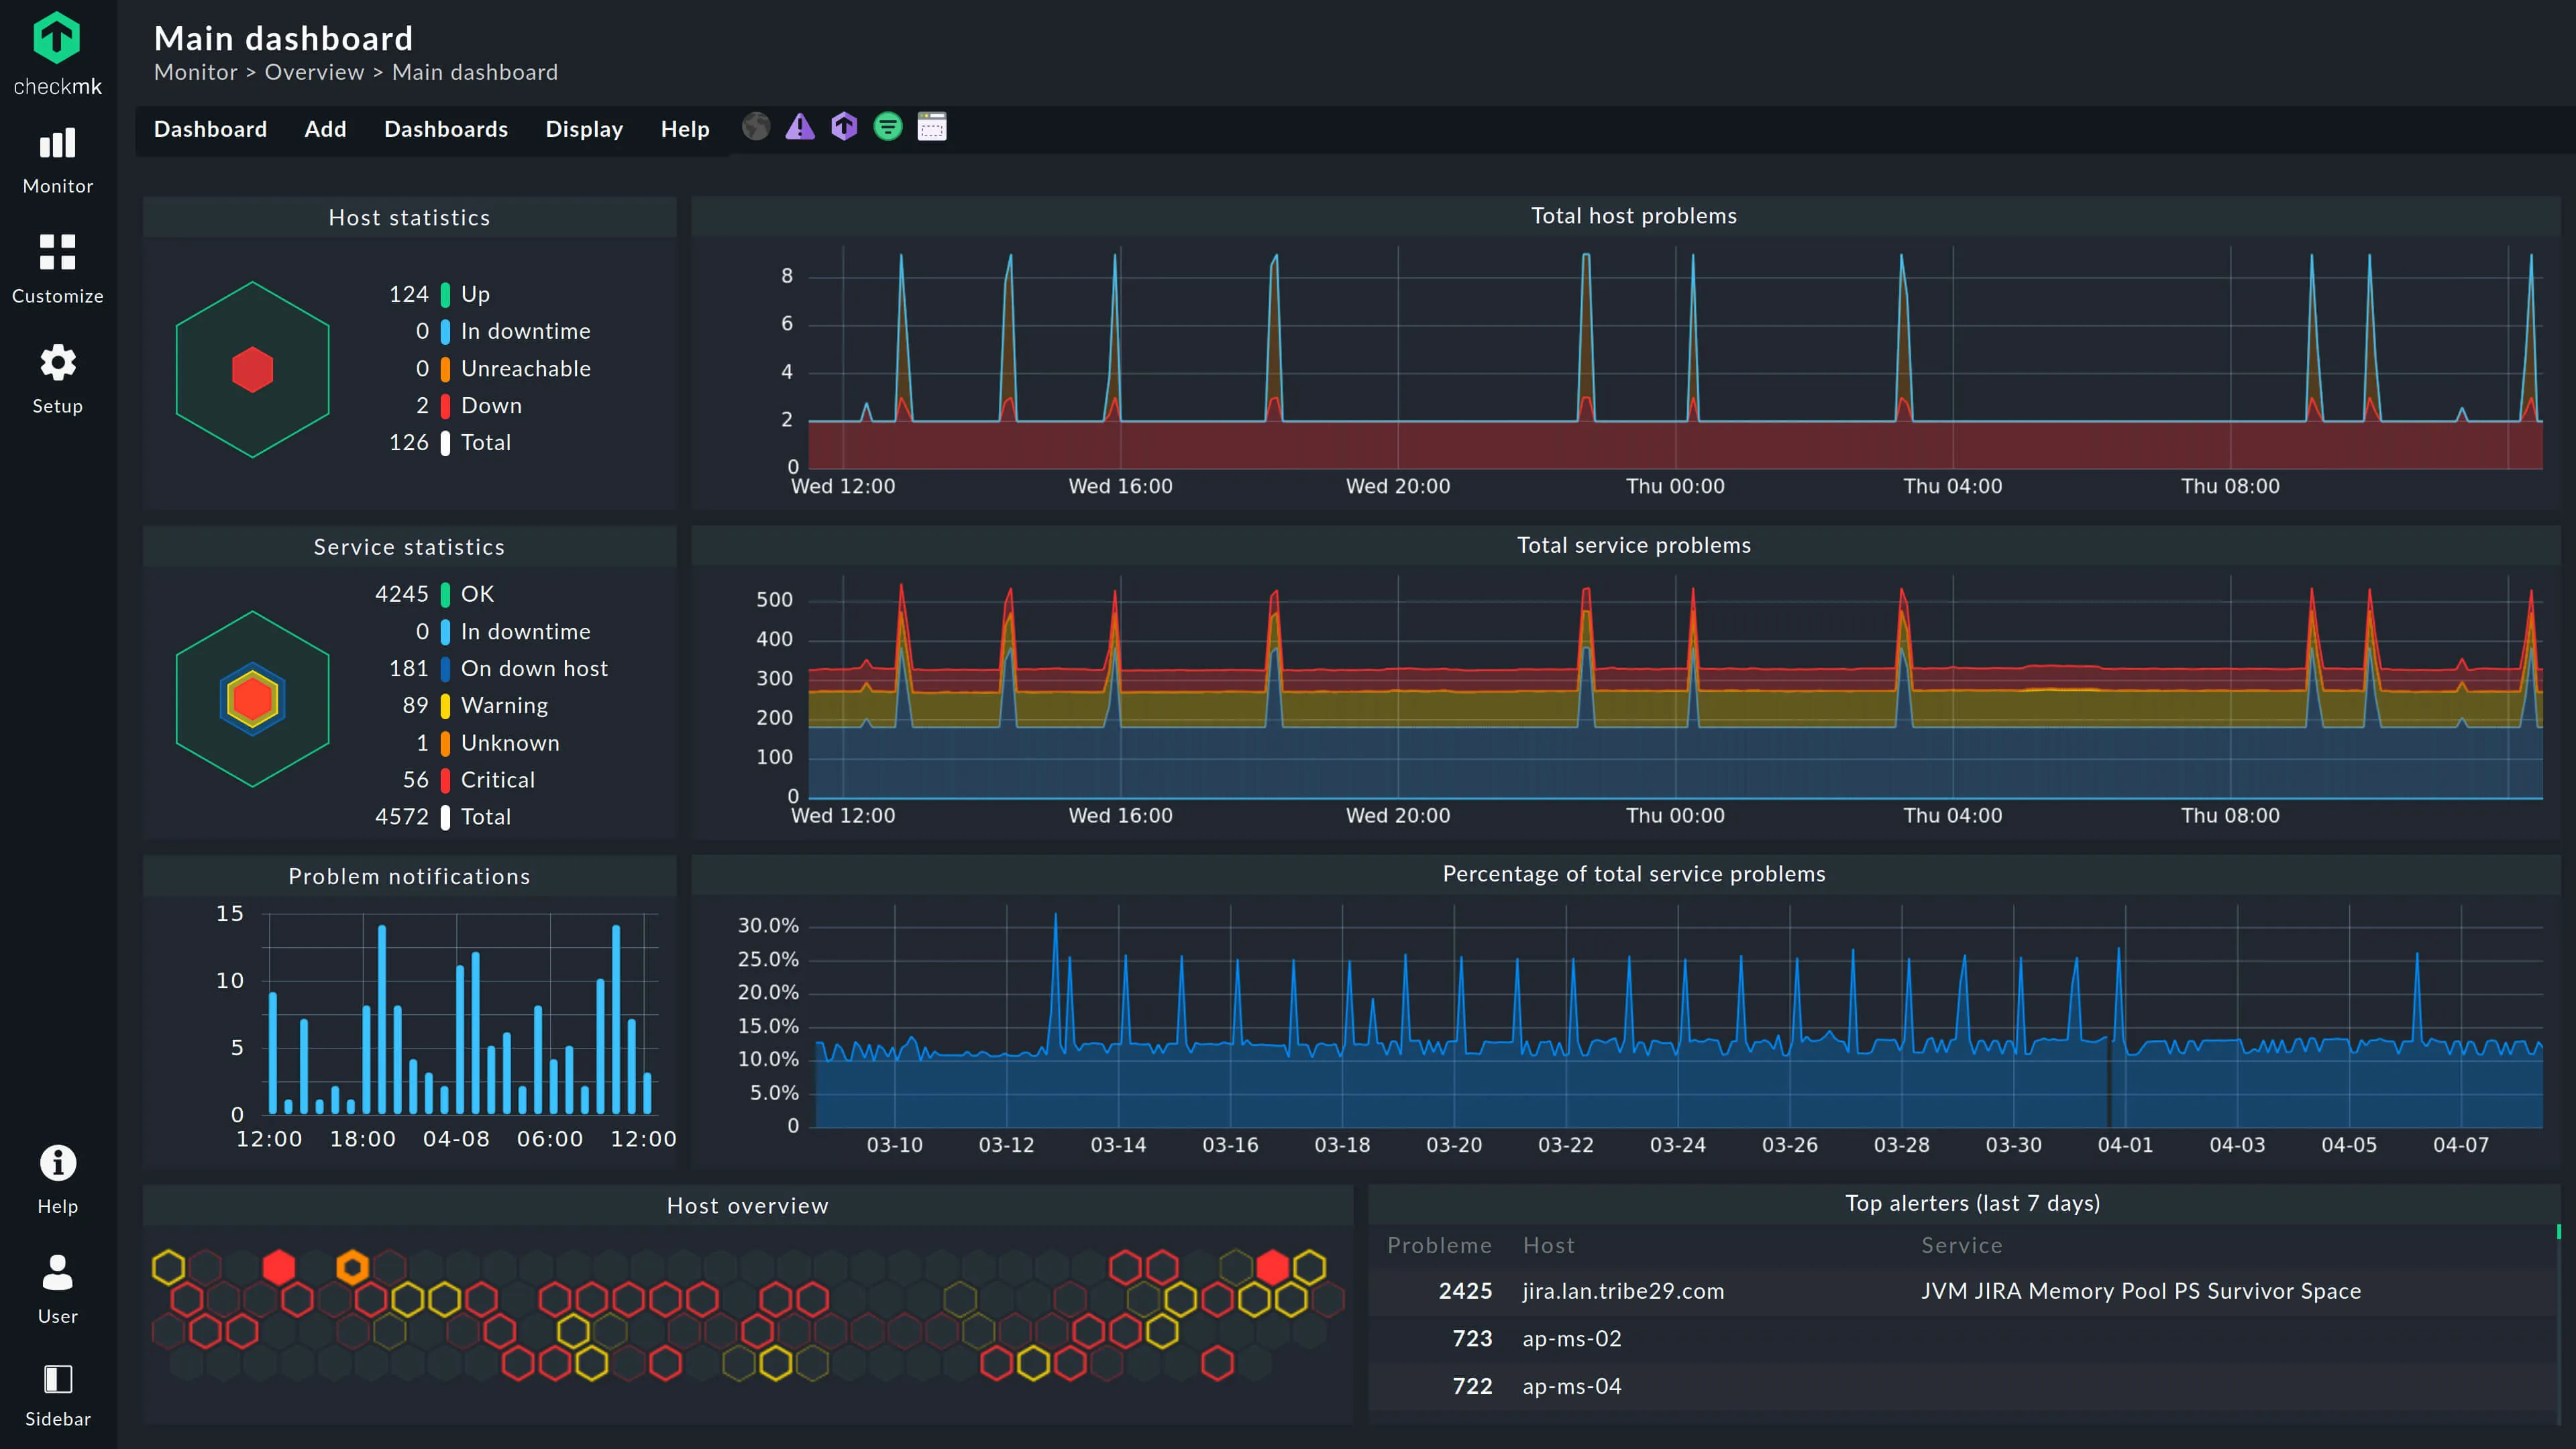
Checkmk 是一款综合性监控工具,在复杂的混合 IT 环境中表现出色。它连接了传统 Nagios 式检查与现代指标采集两种方式。
核心特性
- 混合监控: 对裸机、交换机和 Docker 容器一视同仁,均能胜任。
- 自动服务发现: 扫描主机,自动发现运行中的服务并配置检查。
- 2000+ 插件: 庞大的集成库。
优点
- 一体化: 既能处理基于状态的监控(Up/Down),也能很好地处理指标性能。
- 可扩展: 得益于高效的核心,单台服务器即可承载数千项服务。
缺点
- UI/UX: 界面虽功能完备,但与现代 SaaS 工具相比显得拥挤、过时。
- 配置: 功能极强,但高级特性的学习曲线陡峭。
适用对象: 需要同时管理传统硬件、本地服务器和云实例的系统管理员与 IT 部门。
价格 开源版免费。企业版约 $2,100/年起,覆盖 3,000 项服务(约 100 台主机)。SaaS 版约 $6/主机/月起(按服务计费)。
4. Datadog
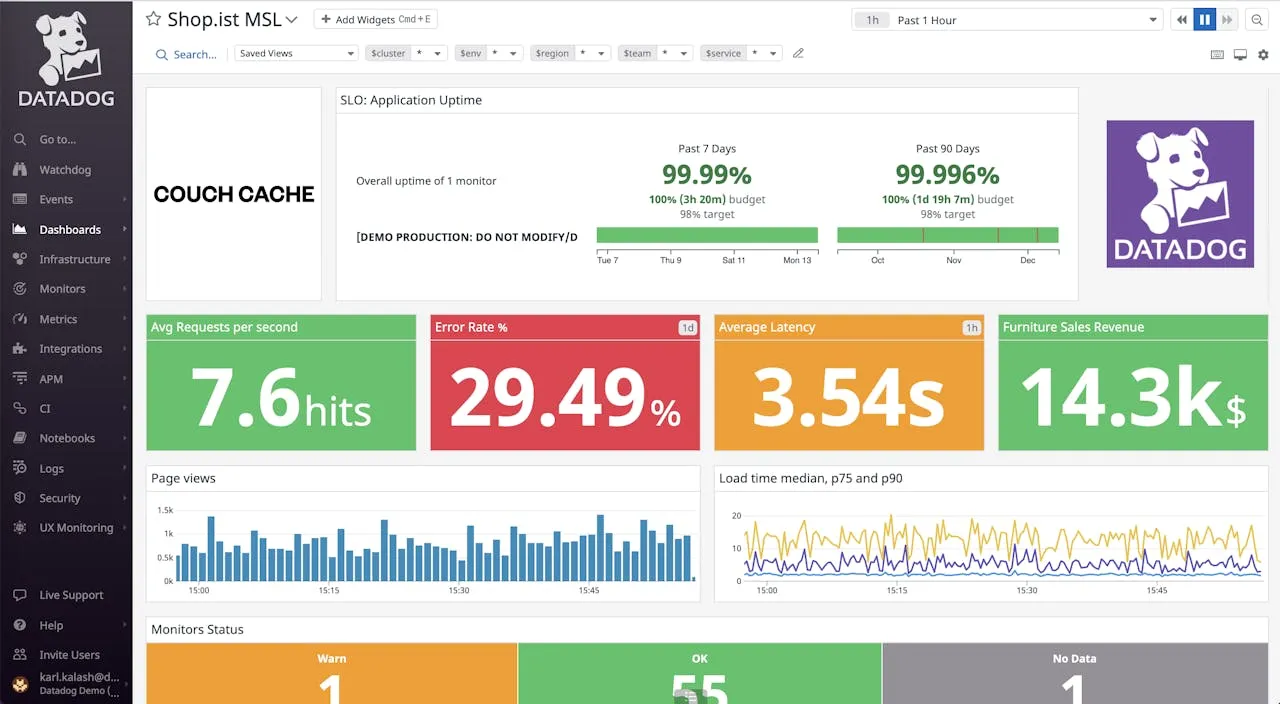
Datadog 是可观测性领域的巨头。它提供了一个庞大的统一平台,覆盖监控的方方面面:基础设施、APM、日志、安全、网络和 RUM。
核心特性
- 全栈可观测性: 真正实现链路、日志和指标间的统一数据关联。
- Watchdog AI: 自动异常检测,常常在你察觉之前就发现问题。
- 400+ 集成: 为 AWS、Azure、Google Cloud 及各类 SaaS 工具提供点选式集成。
优点
- 界面精良: 直观、快速,用起来确实顺手。
- 深度可见性: APM 和链路追踪的洞察深度无出其右。
缺点
- 成本: 贵得出名。“每主机”价格只是入场券,自定义指标、日志摄入和数据保留很快就会把账单推高。
- 厂商锁定: 专有 agent 和数据格式意味着一旦深度集成,就很难抽身。
适用对象: 大型企业和高速增长的科技公司,这类组织更看重工程效率,而非压低监控账单。
价格 基础设施监控 $15/主机/月起。但这很少是最终价格。APM、日志($0.10/GB 索引)和自定义指标均单独计费,在生产环境中常常把基础费用翻倍甚至三倍。
5. New Relic
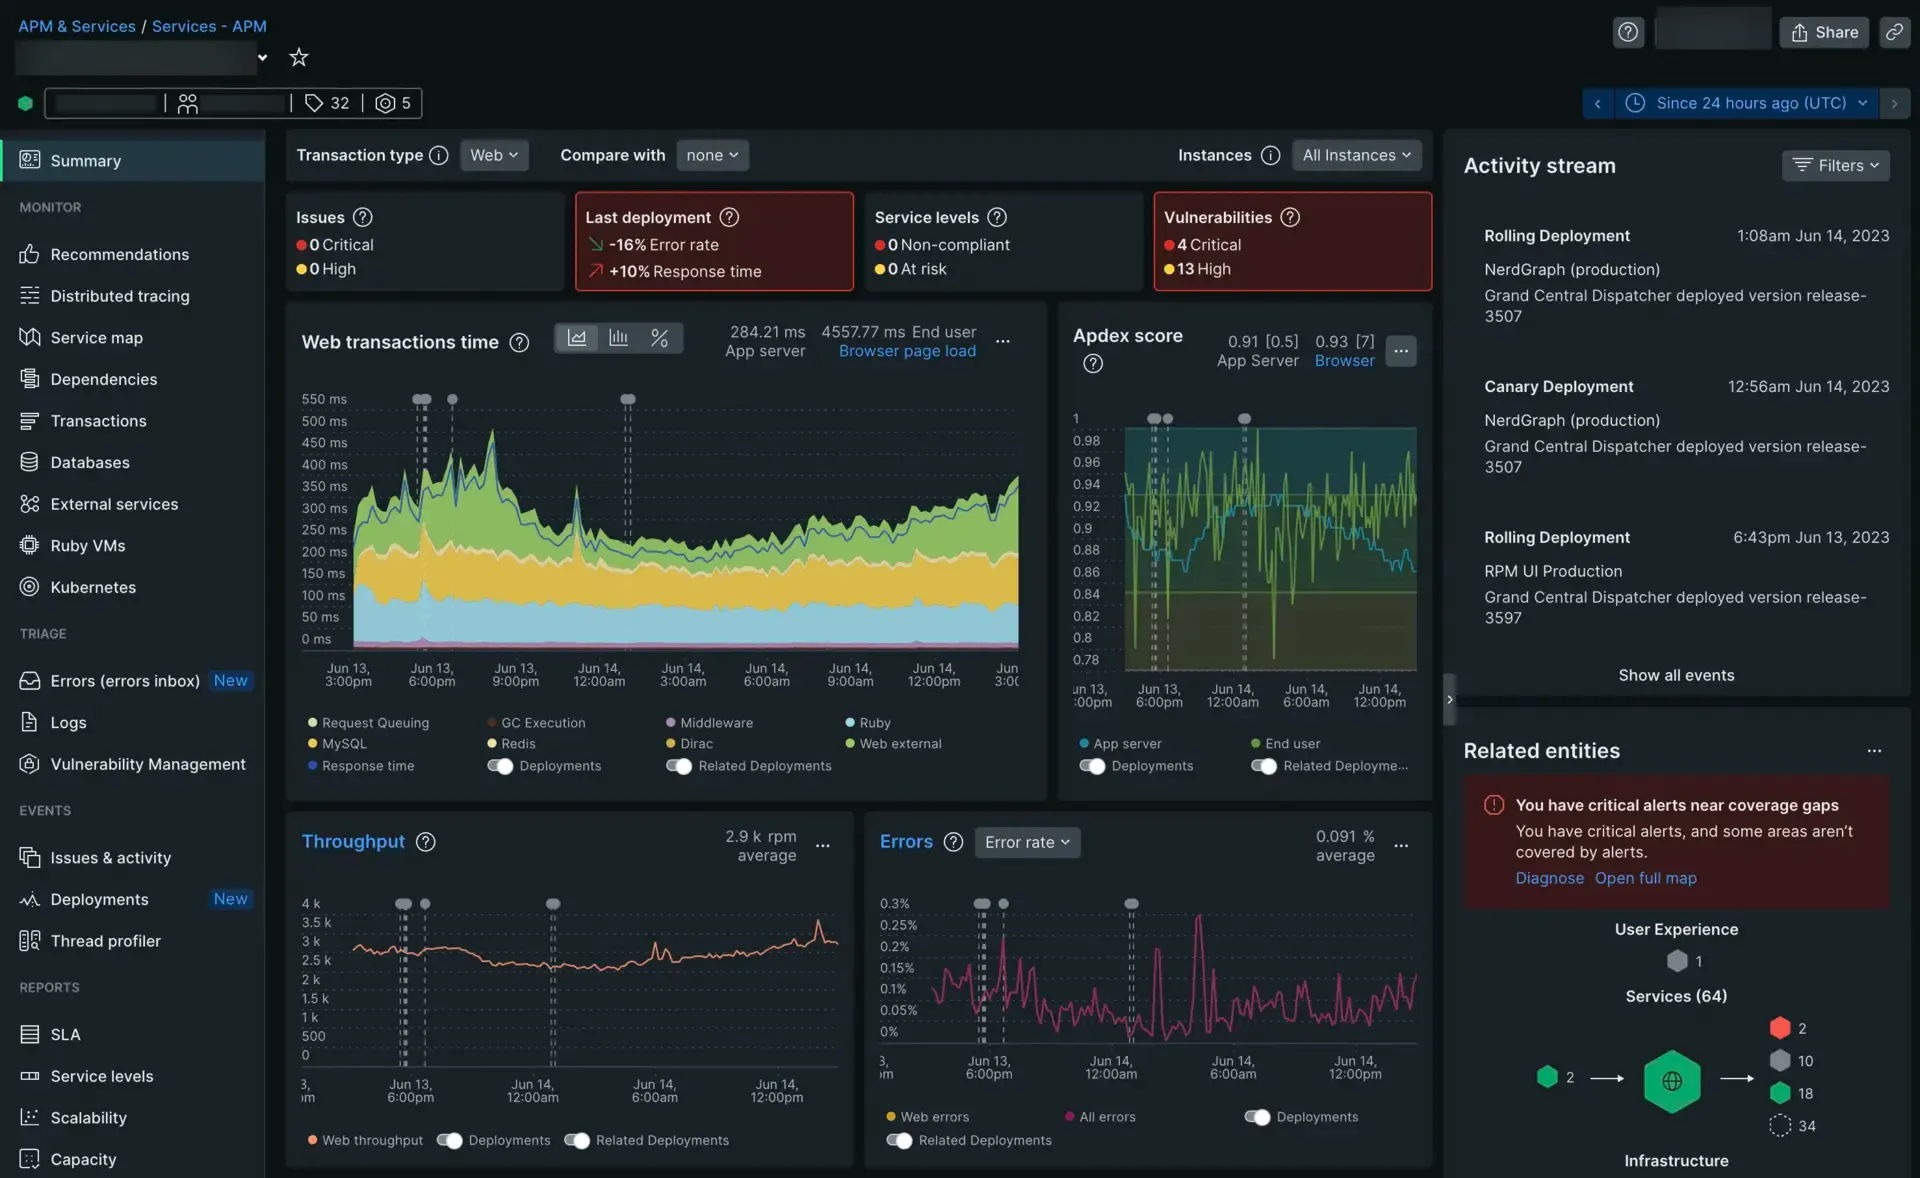
New Relic 是 APM 领域的老牌厂商,已演进为全栈可观测性平台。对于需要深入到代码层面排查应用性能问题的开发者而言,它尤为强大。
核心特性
- 深度 APM: 代码级链路追踪,定位慢数据库查询或低效函数。
- 浏览器与移动端: 原生支持在 Web 和移动应用上追踪终端用户体验(RUM)。
- 应用智能: AI 驱动的洞察,用于检测异常并关联事件。
优点
- 统一数据平台: 所有遥测数据(指标、日志、链路)集中存储。
- 免费档: 面向小团队的慷慨免费额度(100 GB/月)。
缺点
- 复杂度: 平台体量庞大,简单需求下在 UI 中穿行也会让人头疼。
- 计费模式: 免费档虽好,但完整权限按用户计费,对较大团队来说成本会偏高。
适用对象: 专注于应用性能监控(APM)和全栈调试的开发团队。
价格 按用量计费:100 GB/月免费。付费方案 $0.30/GB 摄入起,另加每用户席位费(Core $99/月,Plus $549/月)。
6. Icinga
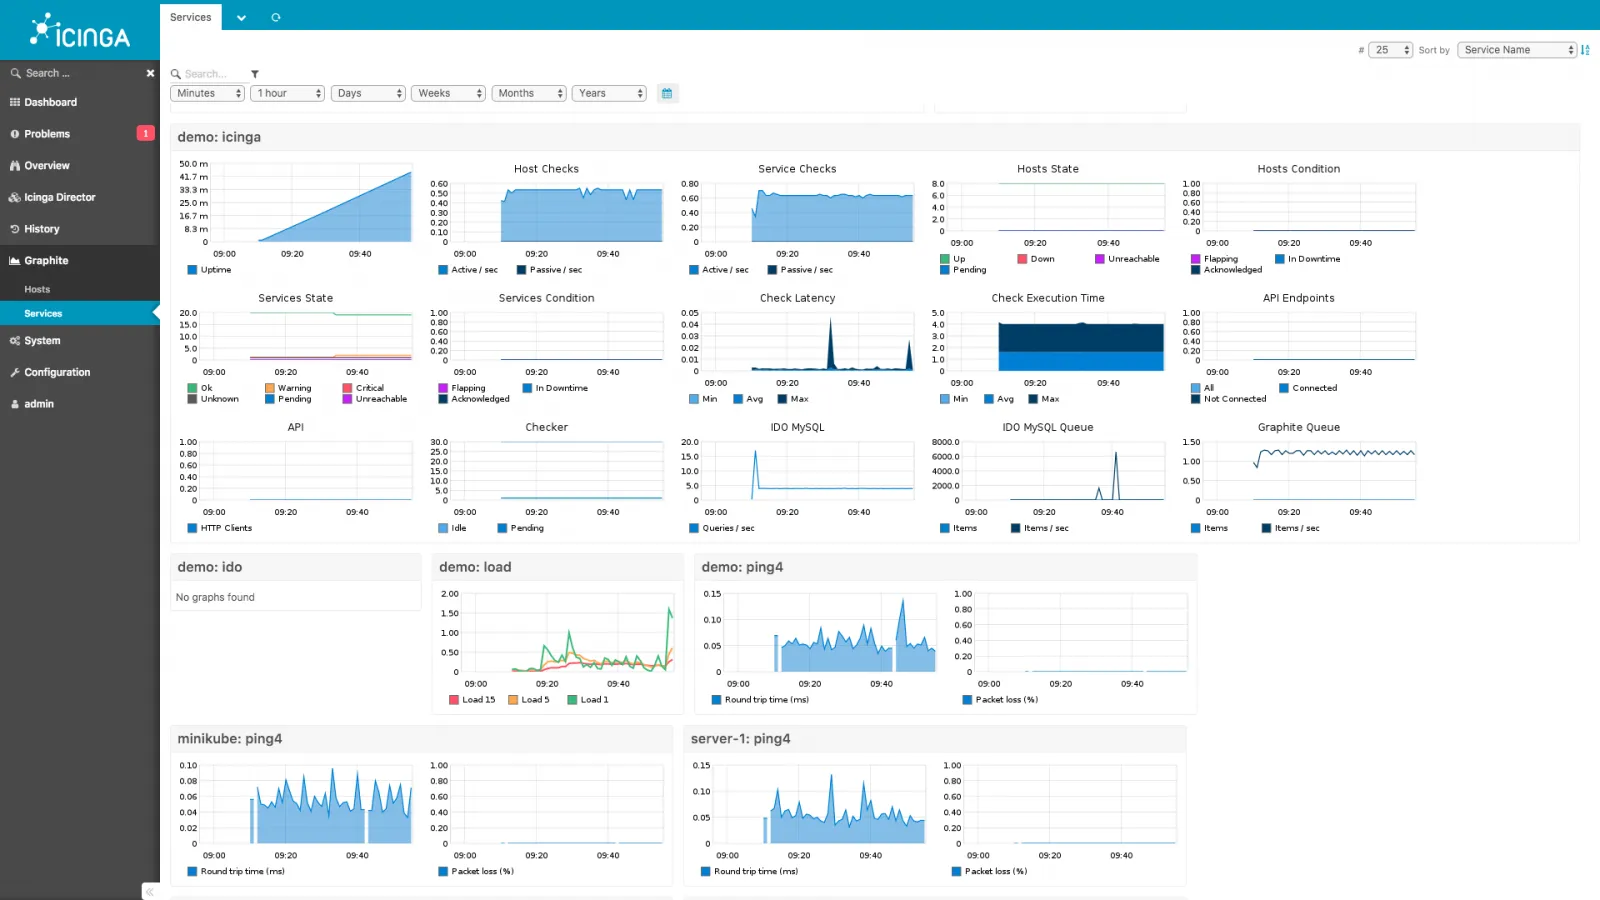
Icinga 脱胎于 Nagios 的分支,将经典监控方式现代化。它保留了与 Nagios 插件的兼容性,同时加入了现代 Web 界面、强大的配置 API 和可扩展性特性。
核心特性
- Icinga Director: 基于 Web 的配置管理工具,比直接编辑配置文件更方便。
- 分布式监控: 内置对分布式部署和高可用的支持。
- 插件兼容: 兼容数千个现成的 Nagios 插件。
优点
- 经典的现代化: 既有 Nagios 的可靠性,又有好得多的 UI 和 API。
- 商业支持: 适用于”免费”不够用的企业级部署。
缺点
- 部署成本: 相比 SaaS 工具,仍需大量搭建和配置工作。
- 学习曲线: 理解其配置语言和对象模型需要时间。
适用对象: 喜欢 Nagios 灵活性、但又想要更现代、API 驱动且可扩展的工具的系统管理员。
价格 免费(开源)。另提供商业支持。
7. Zabbix
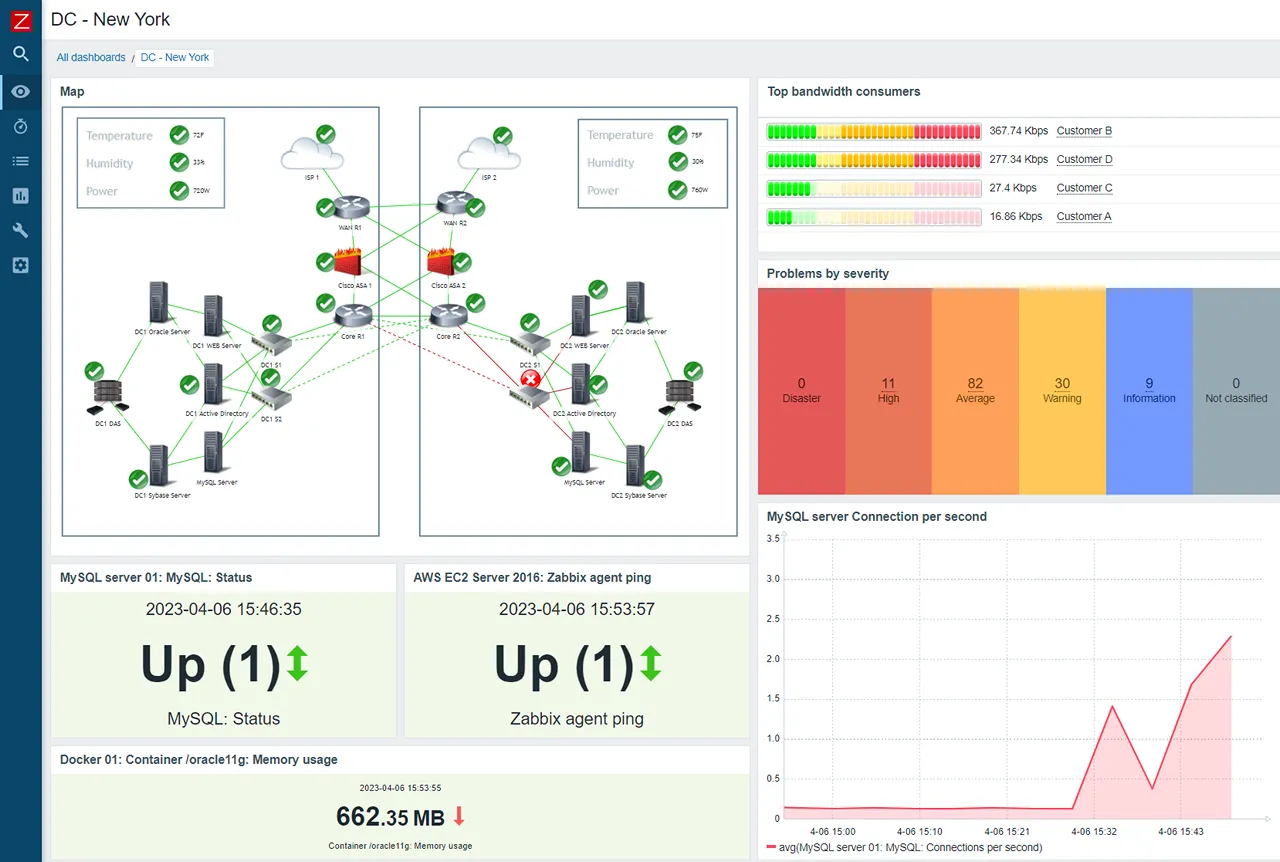
Zabbix 是一个成熟的企业级开源平台。作为传统监控的重磅选手,它深受网络工程师和大型传统企业青睐。
核心特性
- 有 agent 与无 agent: 可通过 SNMP、JMX、IPMI 及其自有 agent 进行监控。
- 推送与拉取: 同时支持轮询和 trapping 两种数据采集方式。
- 细粒度权限: 出色的多租户和用户权限控制。
优点
- SaaS 可选: Zabbix Cloud 为不愿承担自托管开销的团队提供托管方案。
- 久经考验: 在大规模环境中实战检验数十年。
缺点
- 复杂度: 配置可能非常冗长(XML/模板),耗时费力。
- 现代感: 缺少现代可观测性工具那种无缝的云原生集成和顺滑体验。
适用对象: 网络运维中心(NOC)、MSP,以及拥有大量本地基础设施、需要专门支持或托管监控环境的组织。
价格 软件本身开源,但专业使用往往倾向于 Zabbix Cloud,$50/月起。企业级支持和培训也需付费。
8. Nagios
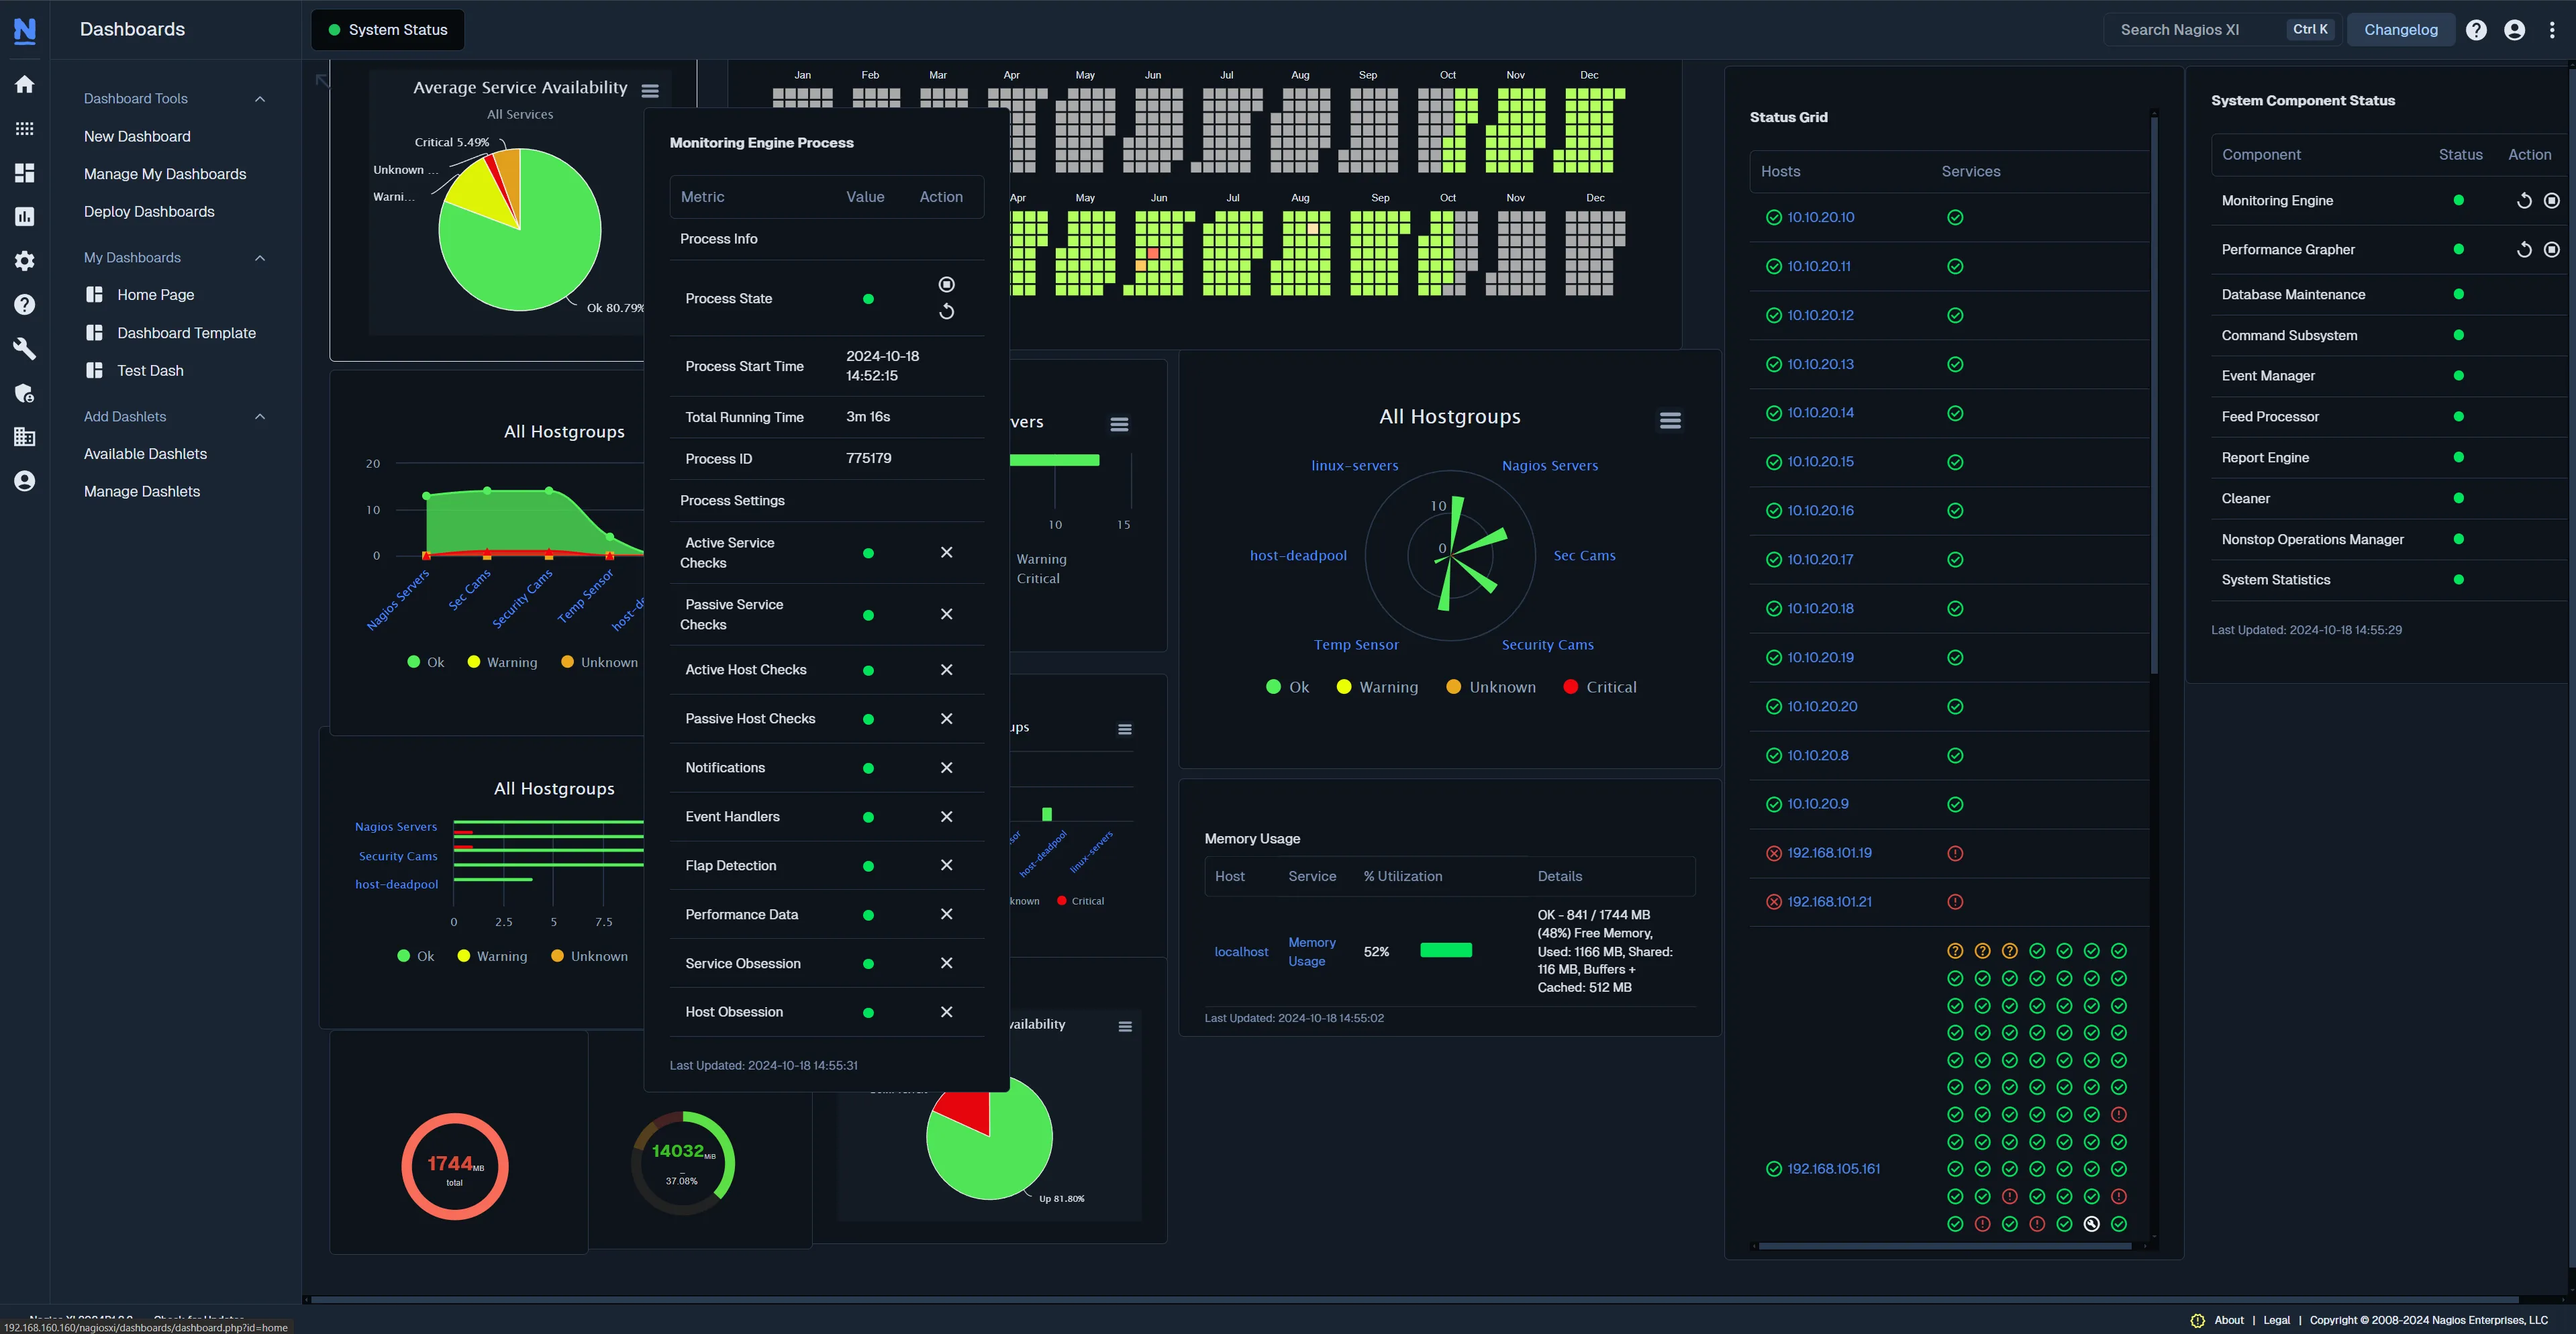
Nagios 是监控领域的”鼻祖”。按现代标准它已算传统技术,但凭借稳定性和庞大的检查脚本生态,至今仍被广泛部署。
核心特性
- 插件生态: 只要某种设备存在,Nagios 里多半就有对应的 Perl 或 Bash 脚本来监控它。
- 二元状态导向: 在明确的”OK/CRITICAL”告警方面表现出色。
优点
- 可靠性: 极其稳定,逻辑简单。
- 通用: 几乎每位系统管理员都会看 Nagios 告警。
缺点
- 过时: 配置基于文件且脆弱,UI 也属于另一个时代。
- 指标: 它本质上是状态检查工具,而非指标/绘图工具,通常需要搭配其他工具才能出图。
适用对象: 遵循”没坏就别修”原则的传统环境,或只有 Nagios 插件能支持的特定硬件检查场景。
价格 Nagios Core(开源)免费。Nagios XI(商业版)标准授权 $2,495 起(最多 100 个节点)。
总结
Netdata 在它擅长的领域是一款出色的工具:以近乎免费的方式让你对单台服务器获得极高分辨率的洞察。但对许多团队来说,扩展的复杂度、以及缺少集成的日志和告警历史,让它更像一块跳板,而非最终归宿。
- 兼顾简单与强大: 试试 Simple Observability。它把混乱化为清晰、可操作的仪表盘。
- 面向 Kubernetes/云原生: 选择 Prometheus + Grafana。
- 预算充裕的企业: Datadog 是豪华之选。
选择契合团队技能和组织预算的工具。如需直接对比,请参阅我们的 Netdata 与 Zabbix 对比 和 Netdata 与 Prometheus 对比 详解。