



Netdata ist eine bekannte Open-Source-Monitoring-Plattform mit einer einzigartigen Edge-First-, verteilten Architektur, die Echtzeit-Metriken mit Sekunden-Granularität ermöglicht. Während dieser Ansatz für bestimmte Anwendungsfälle leistungsstark ist, bringt er Kompromisse mit sich: höhere Ressourcennutzung auf jedem Node und Komplexität bei der Skalierung über Hunderte von Servern.
Wenn Sie etwas Einfacheres suchen, bietet Simple Observability eine leichtgewichtige Alternative. Es basiert auf einem Open-Source-Agenten, der minimale Ressourcen verbraucht und buchstäblich mit einem Befehl zu installieren ist. Alles andere wird über die UI konfiguriert, sodass Sie das YAML-Gefrickel überspringen können.
In diesem Artikel gehen wir die besten Alternativen zu Netdata im Jahr 2026 durch. Wir beginnen mit einem Überblick, was Netdata gut macht (und wo es Schwierigkeiten hat), behandeln dann die wichtigsten Kriterien, die Sie bei der Evaluierung von Monitoring-Tools beachten sollten. Schließlich vergleichen wir jede Option, um Ihnen zu helfen, die richtige Wahl für Ihr Team zu finden. Wenn Sie auch andere Tools evaluieren, werfen Sie einen Blick auf unsere Guides zu Zabbix-Alternativen und der Nagios-Alternative.
Kurzübersicht
| Tool | Am besten für | Preismodell |
|---|---|---|
| Simple Observability | Einfachheit & Vereinheitlichung | $3 / Mo / Server |
| Prometheus & Grafana | Cloud Native / K8s | Kostenlos (OSS) / Managed kostenpflichtig |
| Checkmk | Komplexe IT / Hybrid | ~$6 / Host / Monat |
| Datadog | Enterprise / Cloud | $15+ / Host / Monat |
| New Relic | App-Performance (APM) | Nutzungsbasiert ($0,30/GB) |
| Icinga | Flexible Konfiguration | Kostenlos (OSS) |
| Zabbix | Netzwerk / On-Prem | $50 / Mo (Cloud) |
| Nagios | Legacy-Stabilität | $2.495+ (XI-Lizenz) |
Netdata-Überblick
Wofür bekannt
Netdata ist am bekanntesten für seine Echtzeit-, hochaufgelösten Daten. Die Plattform sammelt jede Sekunde System-Metriken und hält eine Latenz von etwa 1 Sekunde von der Erfassung bis zur Visualisierung aufrecht. Sie ist für die sofortige Fehlersuche konzipiert, wenn Sie diese Granularität benötigen.
Wichtigste Funktionen
- Echtzeit-Metriken: Sekundengranularität für sofortiges Feedback.
- Unsupervised ML: Integrierte Anomalieerkennung, die Ausreißer ohne manuelle Schwellenwerte markiert.
- Auto-Discovery: Erkennt automatisch Dienste und Anwendungen, die auf dem Host laufen.
- Verteilte Architektur: Daten werden typischerweise am Edge (auf dem Node selbst) gespeichert, was zentrale Speicherkosten senkt, aber die lokale Ressourcennutzung erhöht.
Warum nach einer Netdata-Alternative suchen?
Während Netdata beim Echtzeit-Monitoring auf Einzelnode-Ebene glänzt, erzeugt seine Architektur einige praktische Herausforderungen.
1. Skalierbarkeit in dynamischen Umgebungen
Netdatas verteilte Natur funktioniert gut für Speichereffizienz, aber das Verwalten über Hunderte kurzlebiger Container oder Microservices wird schnell kompliziert. Das Aggregieren von Daten aus Tausenden von Nodes erfordert typischerweise erhebliche Konfiguration, oder Sie verlassen sich auf Netdata Cloud, das eigene Kosten und Komplexität mit sich bringt.
2. Ressourcen-Overhead
Da Netdata hochaufgelöste Daten verarbeitet und Anomalieerkennung direkt auf jedem Agenten durchführt, verbraucht es mehr CPU und RAM als leichtgewichtige Forwarder wie Telegraf oder der Simple Observability-Agent. In ressourcenbeschränkten Umgebungen kann dieser Beobachtereffekt ein echtes Problem sein.
3. Fehlende Observability-Säulen
Netdata ist primär ein Metrik-Tool. Es hat kürzlich Log-Verarbeitung hinzugefügt (Indexierung von Logs am Edge), fehlt aber noch die native verteilte Trace-Unterstützung. Das steht auf der Roadmap für 2026, aber wenn Sie heute Full-Stack-Observability (Metriken, Logs und Traces) benötigen, müssen Sie mehrere Tools zusammenstellen.
Wie wählt man eine Alternative?
Bei der Evaluierung von Alternativen sollten Sie diese Kernkriterien beachten:
- Agent-Effizienz: Suchen Sie nach leichtgewichtigen Agenten, die in effizienten Sprachen (Go, Rust, C++) geschrieben sind und Ihre Produktions-Workloads nicht beeinträchtigen.
- Vereinheitlichte Observability: Unterstützt das Tool Metriken, Logs und Alerts in einer einzigen Ansicht?
- Benutzerfreundlichkeit: Können Sie es in Minuten einrichten (Time-to-Value) oder erfordert es Wochen Konfiguration?
- Preisgestaltung: Ist das Preismodell vorhersehbar? Vermeiden Sie Tools mit komplexer mengenabhängiger Abrechnung, wenn Sie ein striktes Budget haben.
Die 8 besten Netdata-Alternativen
1. Simple Observability
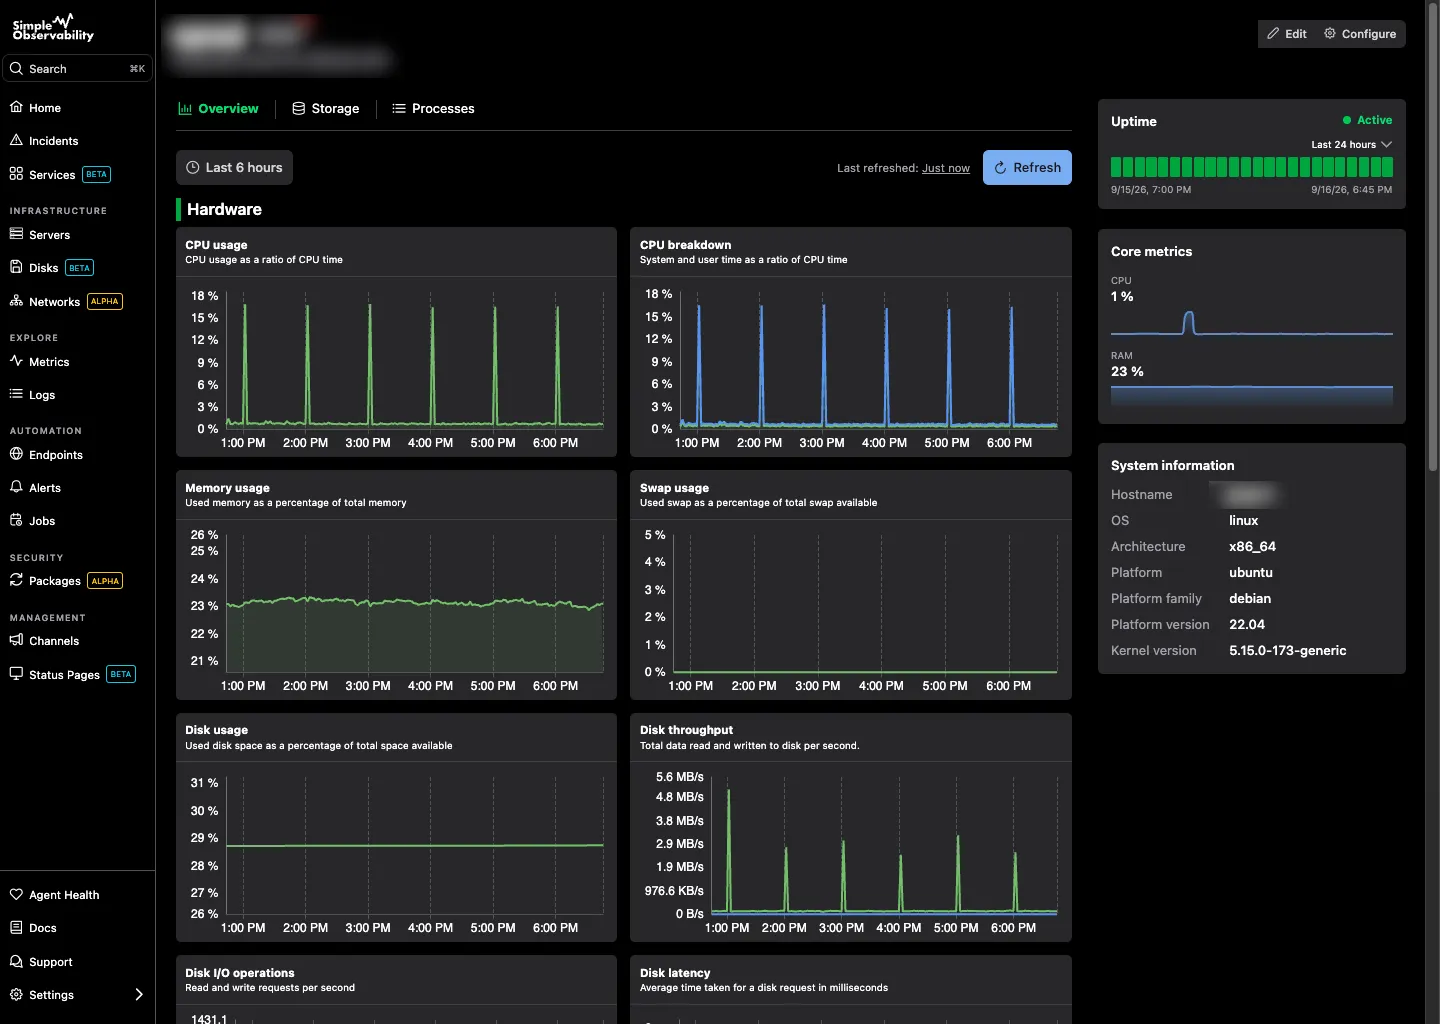
Simple Observability ist eine Server-Monitoring-Plattform, die als unkomplizierteste Alternative für Teams entwickelt wurde, die Ergebnisse ohne Aufwand wollen. Sie kombiniert Metriken und Logs in einer einheitlichen Oberfläche und ersetzt arguably drei separate Tools (Metriken, Logs, Uptime) durch eines.
Wichtigste Funktionen
- Vereinheitlichtes Dashboard: Sehen Sie CPU-/Speicher-Spikes neben Anwendungs-Logs in derselben Ansicht.
- Zero-Config-Alarme: Kommt mit sinnvollen Standardwerten, sodass Sie ab Tag eins geschützt sind.
- Leichtgewichtiger Agent: Hochgradig optimierter Open-Source-Agent, der die Ressourcen Ihres Servers respektiert.
- SaaS-Komfort: Kein Hosting der eigenen Metrik-Datenbank oder Retention-Stacks.
Simple Observability vs Netdata Anders als Netdata, das mit Tausenden von Metriken out of the box überwältigend sein kann, fokussiert sich Simple Observability auf Signal über Lärm. Es liefert die kritischen Metriken, die Sie tatsächlich für den Produktionsbetrieb benötigen, zentral gespeichert, damit Sie keine Daten verlieren, wenn ein Node ausfällt (ein Risiko bei Netdatas lokalem Standardspeicher).
Vorteile
- Äußerst einfach zu bedienen: Installation mit einem Befehl, keine Konfiguration nötig.
- Vorhersehbare Preisgestaltung: Pauschale pro Server. Keine Überraschungen durch “pro Million Custom Metrics” oder “pro GB Log”.
- Vollständige historische Daten: Langfristige Aufbewahrung standardmäßig inklusive.
Nachteile
- Weniger granular: Während Netdata 1-Sekunden-Auflösung bietet, nutzt Simple Observability Standard-60s-Intervalle, um Kosten und Bandbreite vernünftig zu halten.
Am besten für: Startups, Agenturen und DevOps-Teams, die eine “Set-and-Forget”-Monitoring-Lösung wünschen, die einfach funktioniert.
Preis
- Kostenlos: $0 für 1 Server.
- Kostenpflichtig: $3/Mo pro Server für unbegrenzte Server.
- Individuell: Mengenrabatte für große Flotten.
2. Prometheus & Grafana
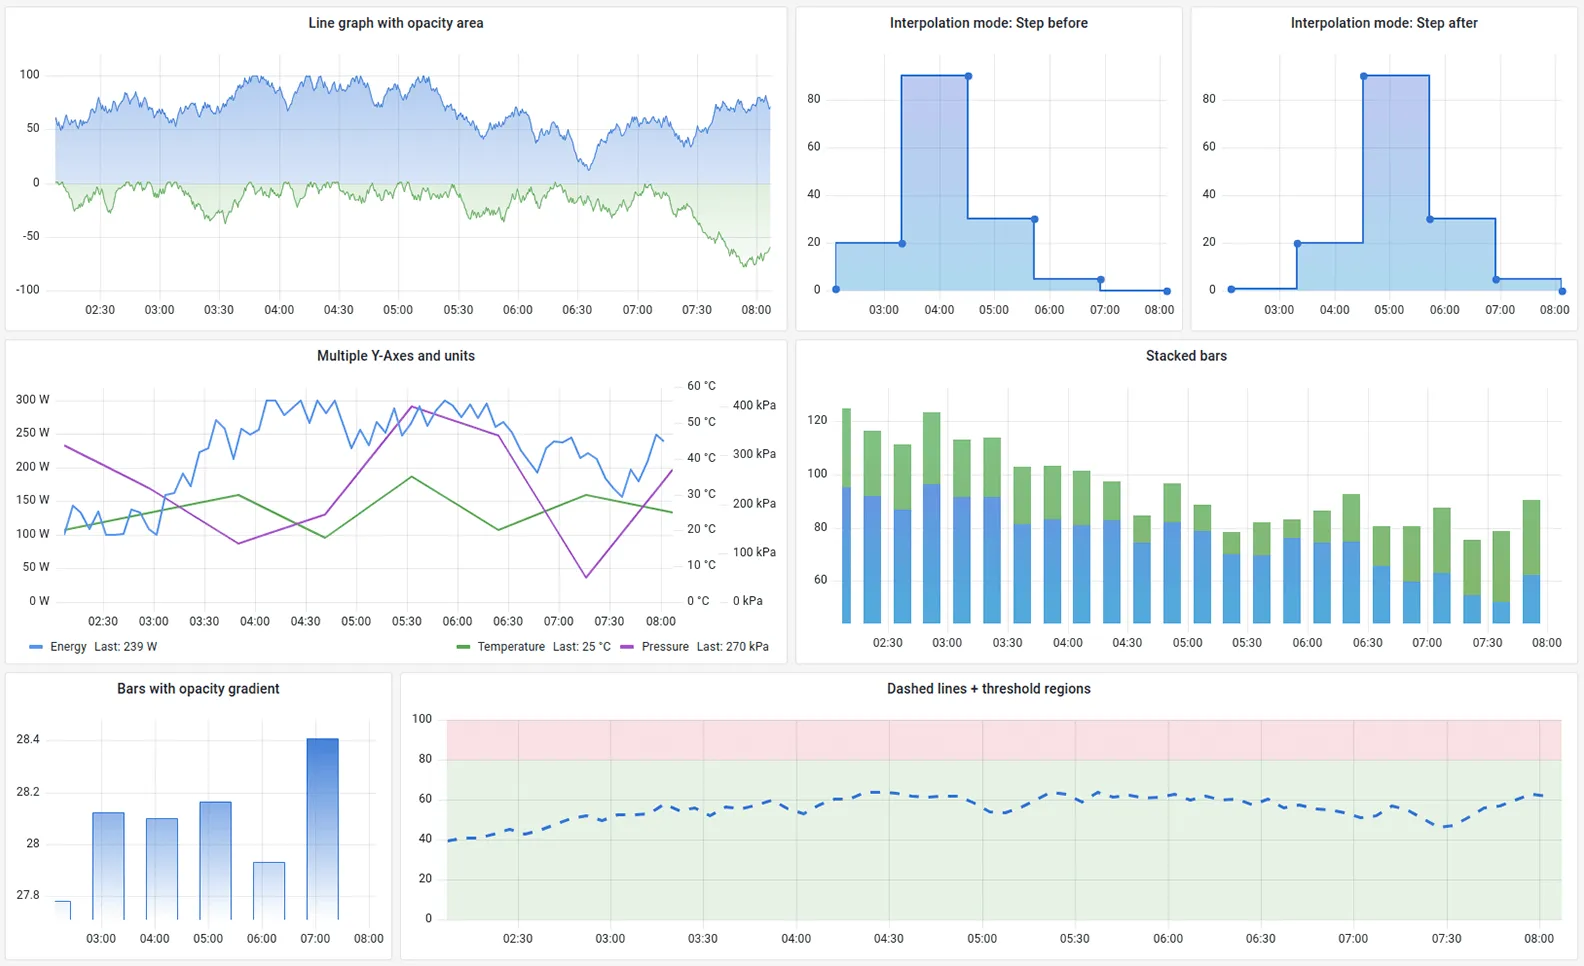
Prometheus zusammen mit Grafana ist der Industriestandard für Cloud-natives Monitoring. Es ist eine leistungsstarke Open-Source-Kombination, bei der Prometheus die Metriken sammelt und Grafana sie visualisiert.
Wichtigste Funktionen
- Mehrdimensionales Datenmodell: Leistungsstarke Abfragen mit PromQL.
- Riesiges Ökosystem: Exporter für praktisch jede existierende Software (Redis, Postgres, Nginx etc.).
- Alertmanager: Verarbeitet Alerts mit anspruchsvollem Routing und Gruppierung.
Vorteile
- Industriestandard: Die De-facto-Wahl für Kubernetes-Monitoring.
- Open Source: Bei Self-Hosting komplett kostenlos.
- Flexibilität: Sie können sich jedes vorstellbare Dashboard in Grafana bauen.
Nachteile
- Komplexität: Erfordert das Einrichten und Warten von zwei separaten Software-Komponenten (Prometheus + Grafana).
- Speicherung: Sie sind verantwortlich für das Verwalten der langfristigen Speicherung und von Backups (oft erfordert dies Thanos oder Cortex für Skalierbarkeit).
- Steile Lernkurve: PromQL ist leistungsstark, erfordert aber Zeit zum Erlernen im Vergleich zu Point-and-Click-Oberflächen.
Am besten für: Kubernetes-Umgebungen, Platform-Engineering-Teams und Organisationen mit dedizierten SRE-Ressourcen.
Preis Kostenlos (Open Source). Skalierter Betrieb erfordert jedoch meistens kostenpflichtige Speicher-Erweiterungen (Thanos) oder Managed Services wie Grafana Cloud oder Amazon Managed Prometheus, die nutzungsbasiert sind.
3. Checkmk
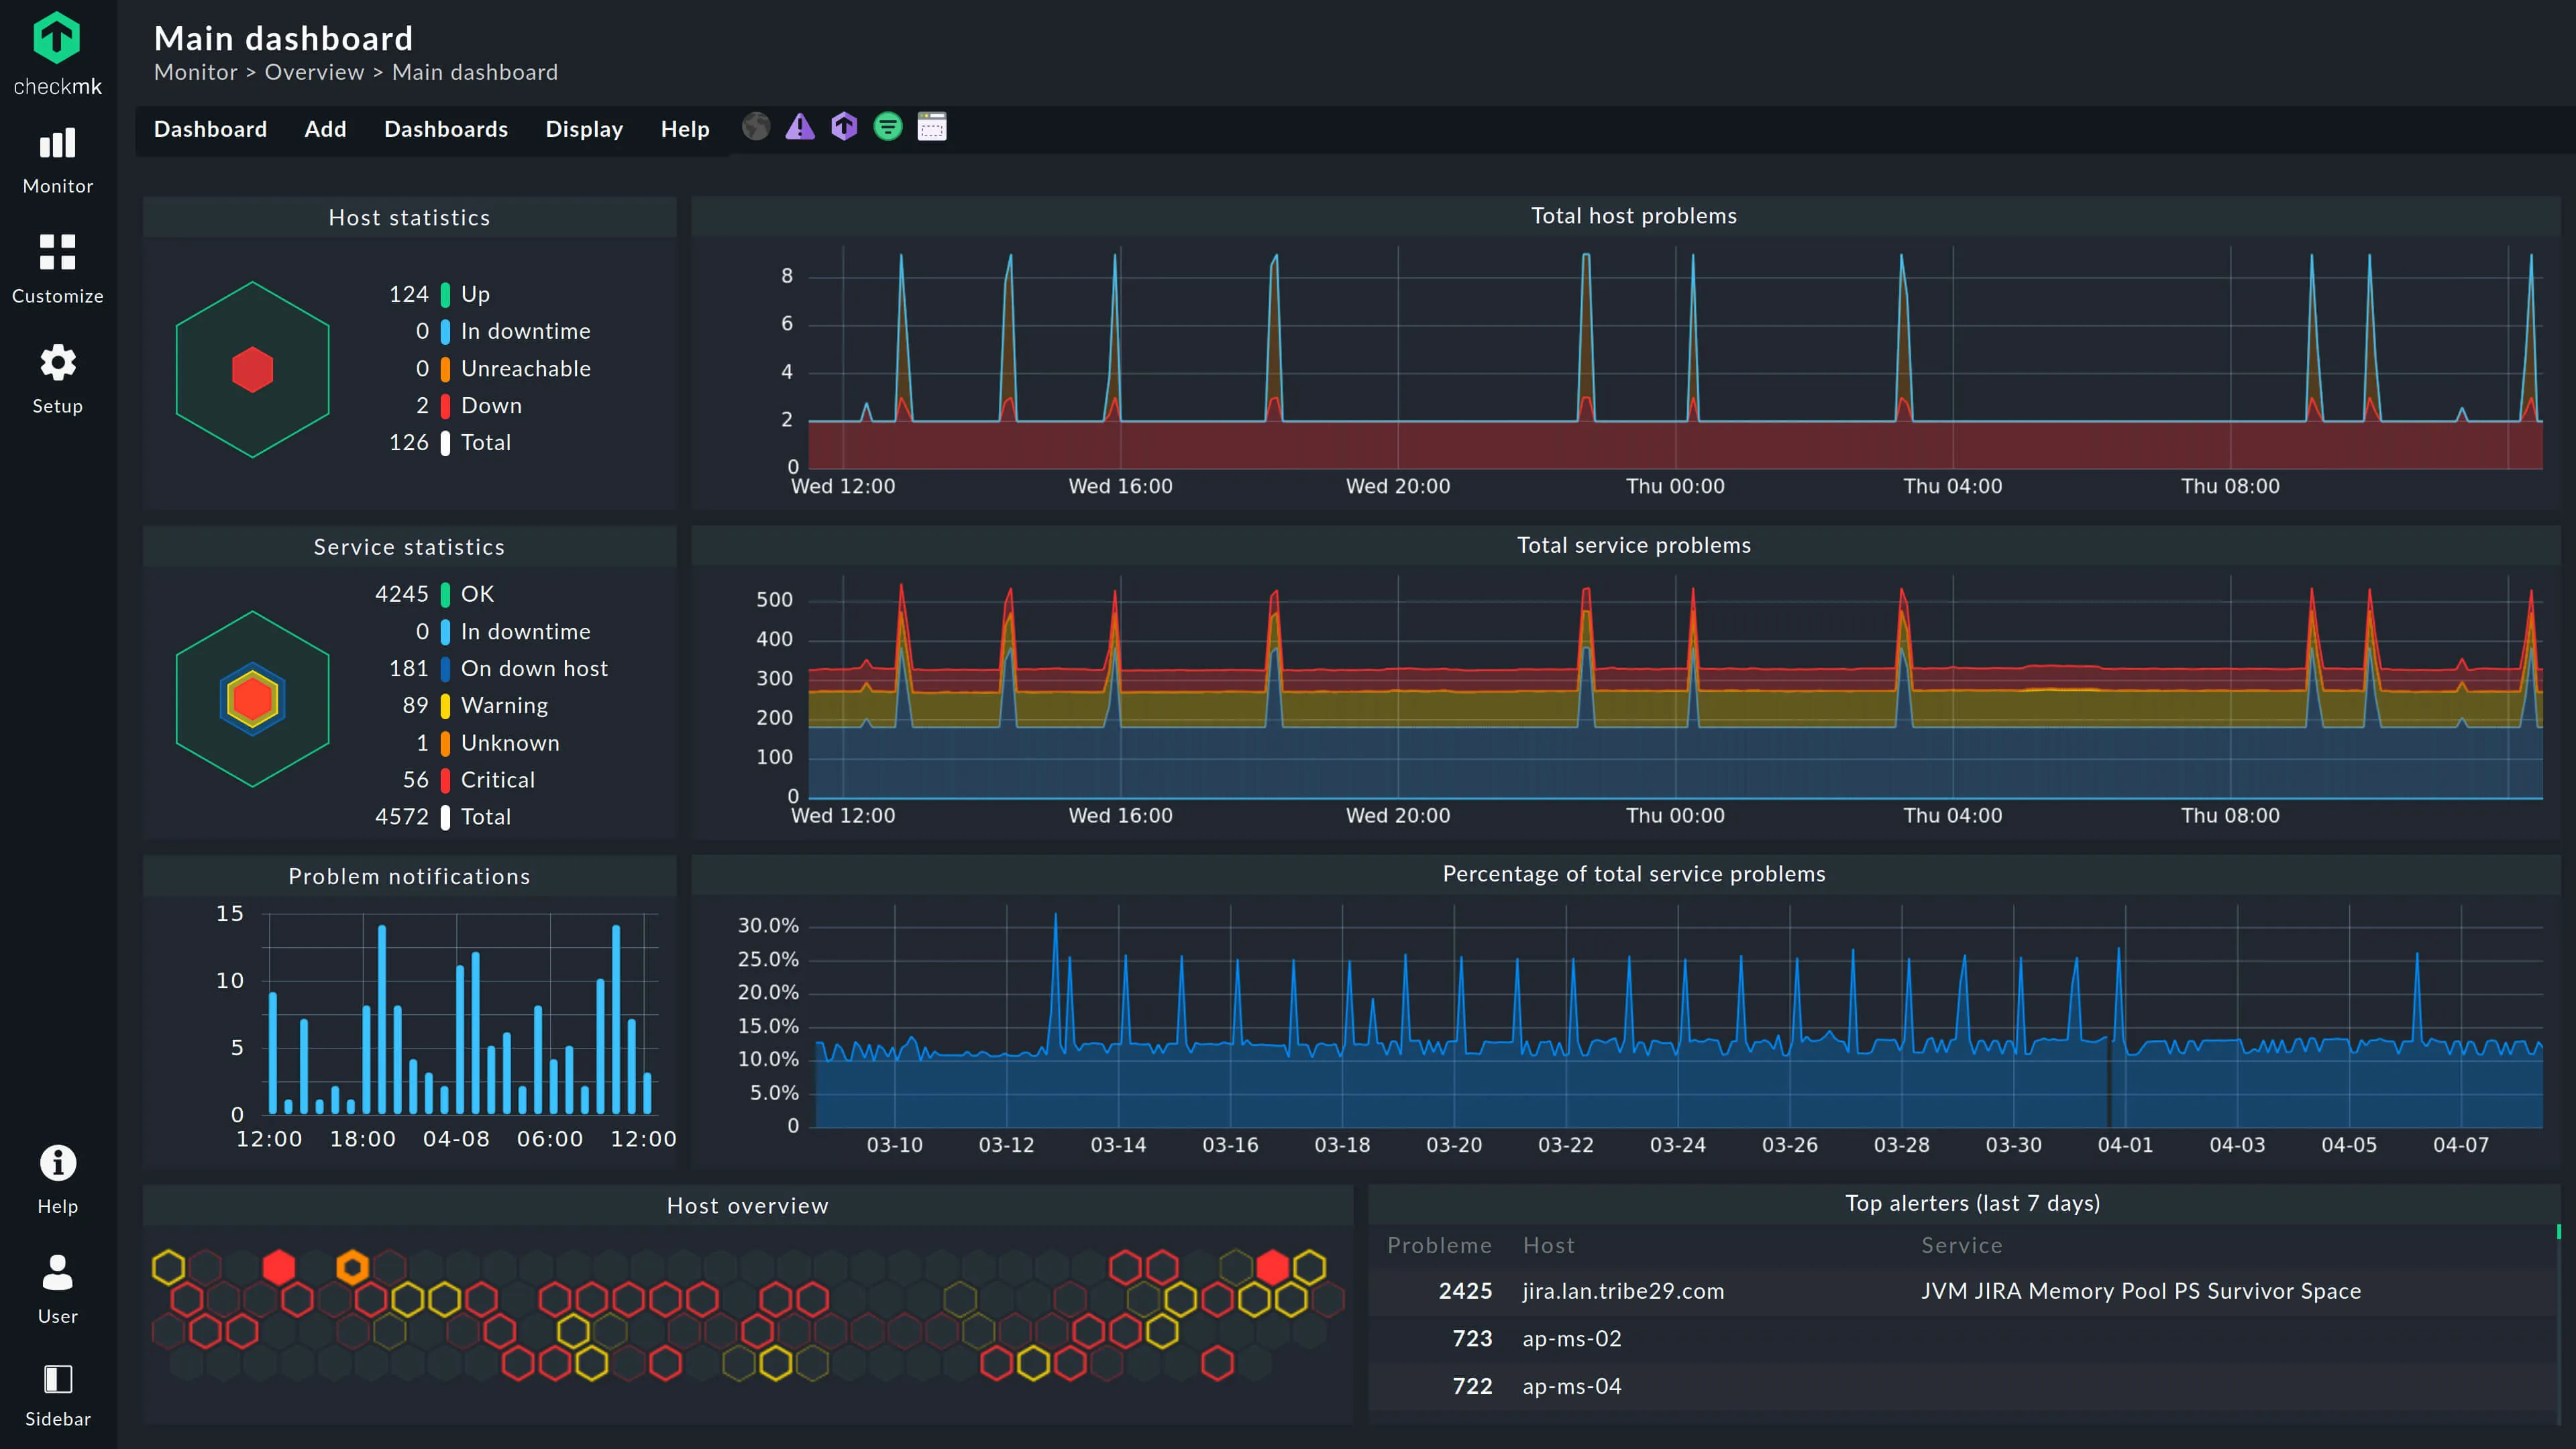
Checkmk ist ein umfassendes Monitoring-Tool, das in komplexen, hybriden IT-Umgebungen glänzt. Es schlägt die Brücke zwischen klassischen Nagios-artigen Prüfungen und moderner Metrik-Erfassung.
Wichtigste Funktionen
- Hybrides Monitoring: Gleichzeitig gut bei der Überwachung von Bare Metal, Switches und Docker-Containern.
- Automatische Service-Discovery: Scannt Hosts, um automatisch laufende Dienste zu finden und Prüfungen zu konfigurieren.
- 2.000+ Plugins: Massive Bibliothek an Integrationen.
Vorteile
- All-in-One: Verwaltet sowohl zustandsbasiertes Monitoring (Up/Down) als auch metrikbasiertes Performance-Monitoring gut.
- Skalierbar: Kann Tausende von Diensten auf einem einzelnen Server dank seines effizienten Cores bewältigen.
Nachteile
- UI/UX: Die Oberfläche ist funktional, kann aber überladen und veraltet wirken im Vergleich zu modernen SaaS-Tools.
- Konfiguration: Äußerst leistungsstark, hat aber eine steile Lernkurve für fortgeschrittene Funktionen.
Am besten für: Sysadmins und IT-Abteilungen, die eine Mischung aus Legacy-Hardware, On-Prem-Servern und Cloud-Instanzen verwalten.
Preis Die Open-Source-Edition ist kostenlos. Enterprise ab ~$2.100/Jahr für 3.000 Dienste (ca. 100 Hosts). SaaS-Editionen ab ~$6 pro Host/Monat (abgerechnet pro Dienst).
4. Datadog
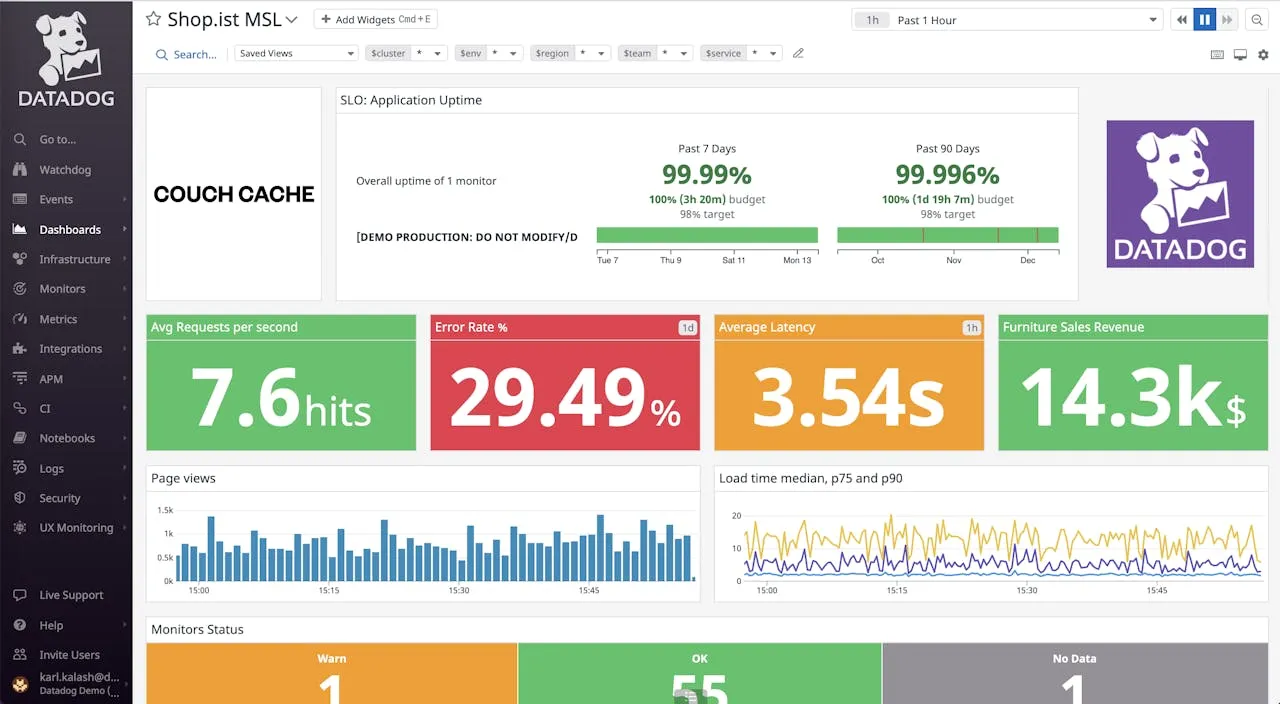
Datadog ist der 800-Pound-Gorilla der Observability-Branche. Es bietet eine massive, vereinheitlichte Plattform, die jeden nur denkbaren Winkel des Monitorings abdeckt: Infrastruktur, APM, Logs, Security, Netzwerk und RUM.
Wichtigste Funktionen
- Full-Stack-Observability: Wirklich vereinheitlichte Daten-Korrelation über Traces, Logs und Metriken hinweg.
- Watchdog AI: Automatisierte Anomalieerkennung, die Probleme oft schon vor Ihnen entdeckt.
- 400+ Integrationen: Point-and-Click-Integrationen für AWS, Azure, Google Cloud und SaaS-Tools.
Vorteile
- Polierte UI: Intuitiv, schnell und tatsächlich angenehm zu bedienen.
- Tiefe Transparenz: Das Maß an Insight für APM und Tracing ist unübertroffen.
Nachteile
- Kosten: Berüchtigt teuer. Der “Pro-Host”-Preis ist nur der Einstieg; Custom Metrics, Log-Ingestion und Retention summieren sich schnell.
- Vendor Lock-in: Der proprietäre Agent und das Datenformat machen es schwer, das Tool zu verlassen, einmal tief integriert.
Am besten für: Große Unternehmen und stark wachsende Technologieunternehmen, bei denen Engineering-Geschwindigkeit wertvoller ist als die Optimierung der Monitoring-Rechnung.
Preis Infrastruktur beginnt bei $15/Host/Mo. Dies ist jedoch selten der Endpreis. APM, Logs ($0,10/GB indiziert) und Custom Metrics werden separat abgerechnet und verdoppeln oder verdreifachen die Basiskosten in der Produktion oft.
5. New Relic
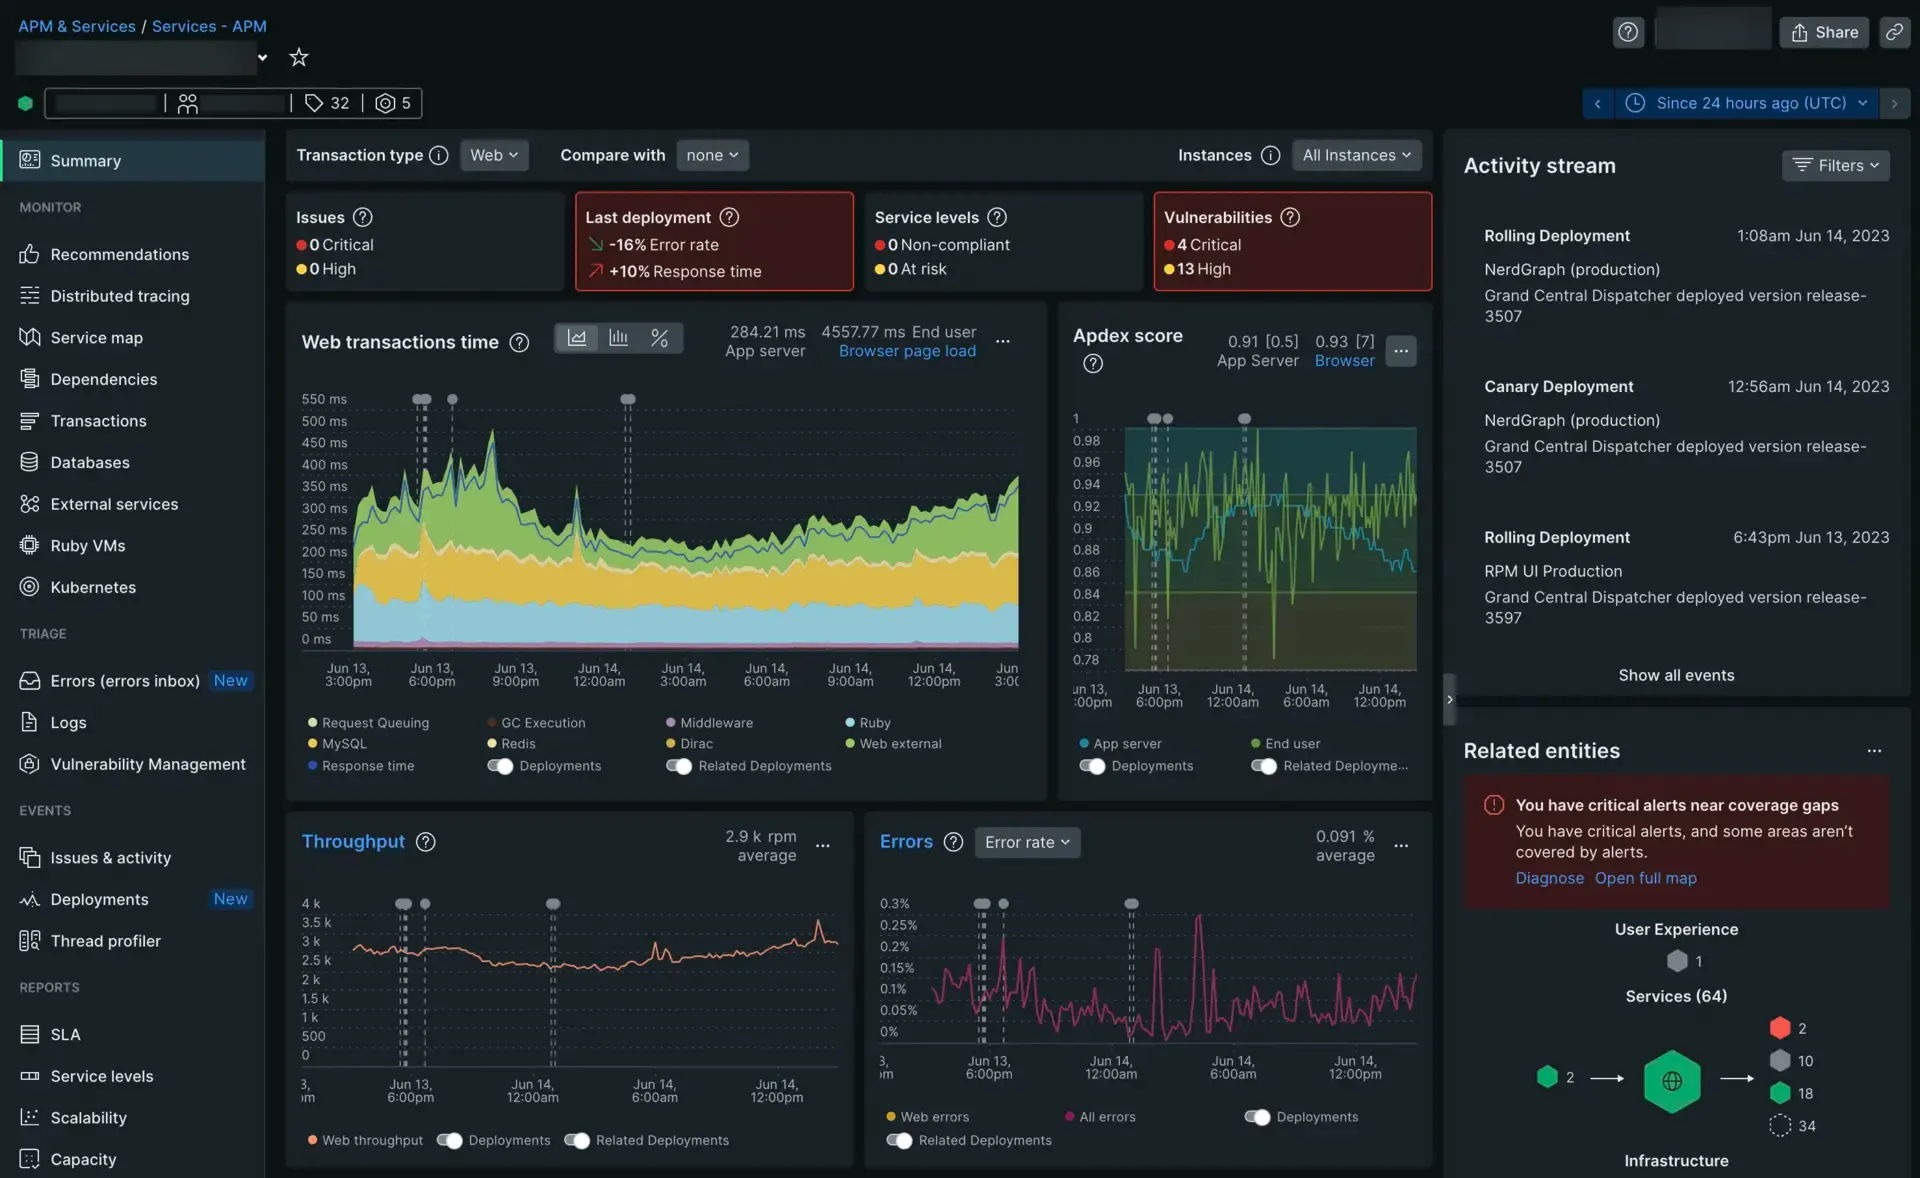
New Relic ist ein Veteran im APM-Bereich, der sich zu einer Full-Stack-Observability-Plattform entwickelt hat. Er ist besonders stark für Entwickler, die tiefe Code-Level-Transparenz zum Debuggen von Anwendungs-Performance-Problemen benötigen.
Wichtigste Funktionen
- Deep APM: Code-Level-Tracing zur Identifizierung langsamer Datenbankabfragen oder ineffizienter Funktionen.
- Browser & Mobile: Native Unterstützung für End-User-Experience-Tracking (RUM) auf Web- und Mobile-Apps.
- Applied Intelligence: KI-gestützte Insights zur Anomalieerkennung und Ereigniskorrelation.
Vorteile
- Vereinheitlichte Datenplattform: Alle Telemetrie (Metriken, Logs, Traces) an einem Ort gespeichert.
- Free-Tier: Großzügiger Free-Tier (100 GB/Monat) für kleine Teams.
Nachteile
- Komplexität: Die Plattform ist riesig, und die Navigation in der UI kann für einfache Bedürfnisse überwältigend sein.
- Preismodell: Während der Free-Tier gut ist, kann die Pro-User-Preisgestaltung für vollen Zugriff für größere Teams teuer werden.
Am besten für: Entwicklerteams, die sich auf Application Performance Monitoring (APM) und Full-Stack-Debugging konzentrieren.
Preis Nutzungsbasiert: Kostenlos für 100 GB/Monat. Kostenpflichtige Pläne ab $0,30/GB Ingestion + Pro-User-Sitzgebühren ($99/Mo für Core, $549/Mo für Plus).
6. Icinga
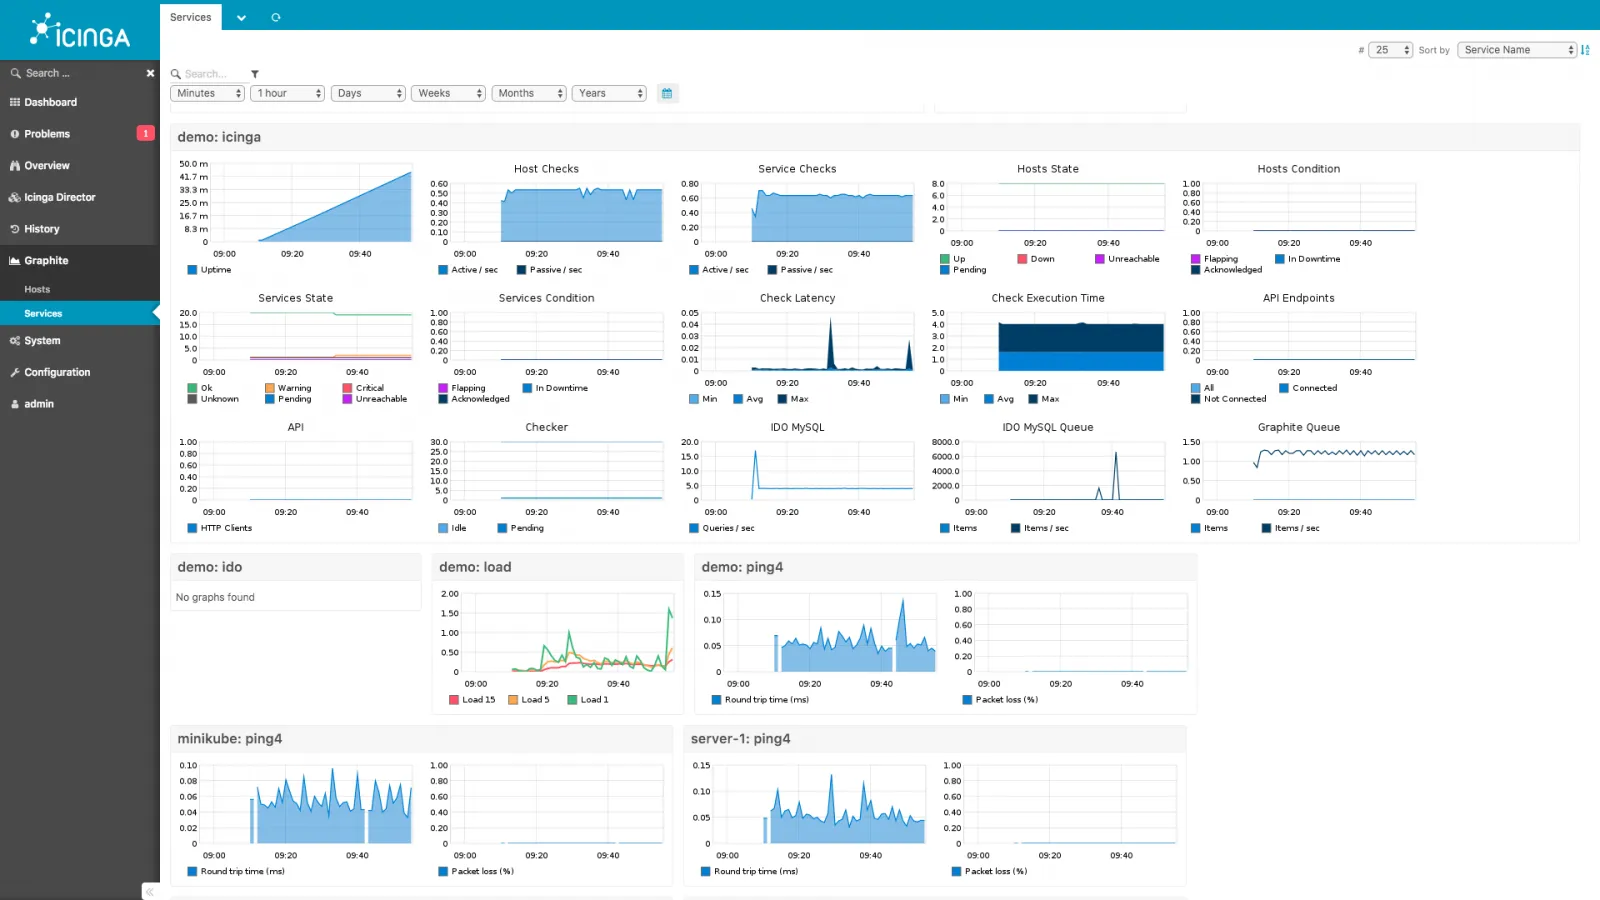
Als Fork von Nagios geboren, hat Icinga den klassischen Monitoring-Ansatz modernisiert. Es behält die Kompatibilität mit Nagios-Plugins, fügt aber eine moderne Weboberfläche, eine robuste Konfigurations-API und Skalierungsfunktionen hinzu.
Wichtigste Funktionen
- Icinga Director: Ein webbasiertes Tool zur Verwaltung der Konfiguration, das einfacher ist als das Editieren von Konfigurationsdateien.
- Verteiltes Monitoring: Eingebaute Unterstützung für verteilte Setups und Hochverfügbarkeit.
- Plugin-Kompatibilität: Kompatibel mit Tausenden existierenden Nagios-Plugins.
Vorteile
- Modernisierter Klassiker: Die Zuverlässigkeit von Nagios mit viel besserer UI und API.
- Kommerzieller Support: Verfügbar für Enterprise-Deployments, bei denen “kostenlos” nicht reicht.
Nachteile
- Einrichtungsaufwand: Erfordert noch erhebliche Einrichtung und Konfiguration im Vergleich zu SaaS-Tools.
- Lernkurve: Das Verstehen der Konfigurationssprache und des Objektmodells kostet Zeit.
Am besten für: Sysadmins, die die Flexibilität von Nagios lieben, aber ein moderneres, API-getriebenes und skalierbareres Tool wollen.
Preis Kostenlos (Open Source). Kommerzieller Support verfügbar.
7. Zabbix
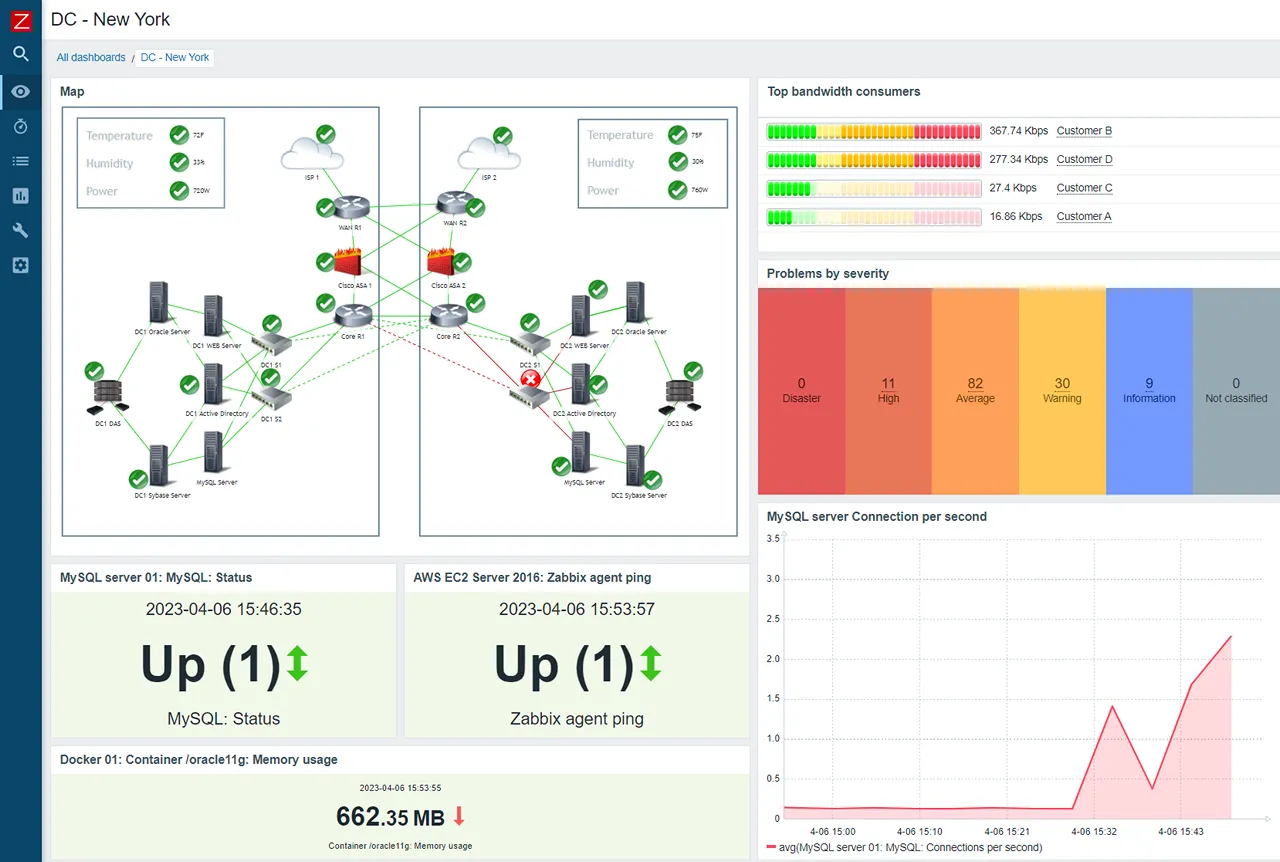
Zabbix ist eine ausgereifte, Enterprise-fähige Open-Source-Plattform. Sie ist ein traditioneller Monitoring-Gigant, beliebt bei Netzwerkengineers und großen traditionellen Unternehmen.
Wichtigste Funktionen
- Agent & Agentless: Kann über SNMP, JMX, IPMI und über den eigenen Agenten überwachen.
- Push & Pull: Unterstützt sowohl Polling als auch Trapping als Datenerhebungsmethoden.
- Granulare Berechtigungen: Hervorragendes Multi-Tenancy und Benutzer-Berechtigungsmanagement.
Vorteile
- SaaS-Verfügbarkeit: Zabbix Cloud bietet einen Managed-Pfad für Teams, die den Overhead des Self-Hosting nicht wollen.
- Bewährt: Seit Jahrzehnten in massiven Umgebungen im Einsatz.
Nachteile
- Komplexität: Die Konfiguration kann sehr umfassend sein (XML/Templates) und zeitaufwendig.
- Modernität: Es fehlen die nahtlosen Cloud-Native-Integrationen und die flüssige Handhabung moderner Observability-Tools.
Am besten für: Network Operations Centers (NOCs), MSPs und Organisationen mit starker On-Prem-Infrastruktur, die dedizierten Support oder eine Managed-Monitoring-Umgebung benötigen.
Preis Die Software ist Open Source, die professionelle Nutzung driftet jedoch oft in Richtung Zabbix Cloud, der bei $50/Mo startet. Enterprise-Grade-Support und Schulungen sind ebenfalls kostenpflichtige Services.
8. Nagios
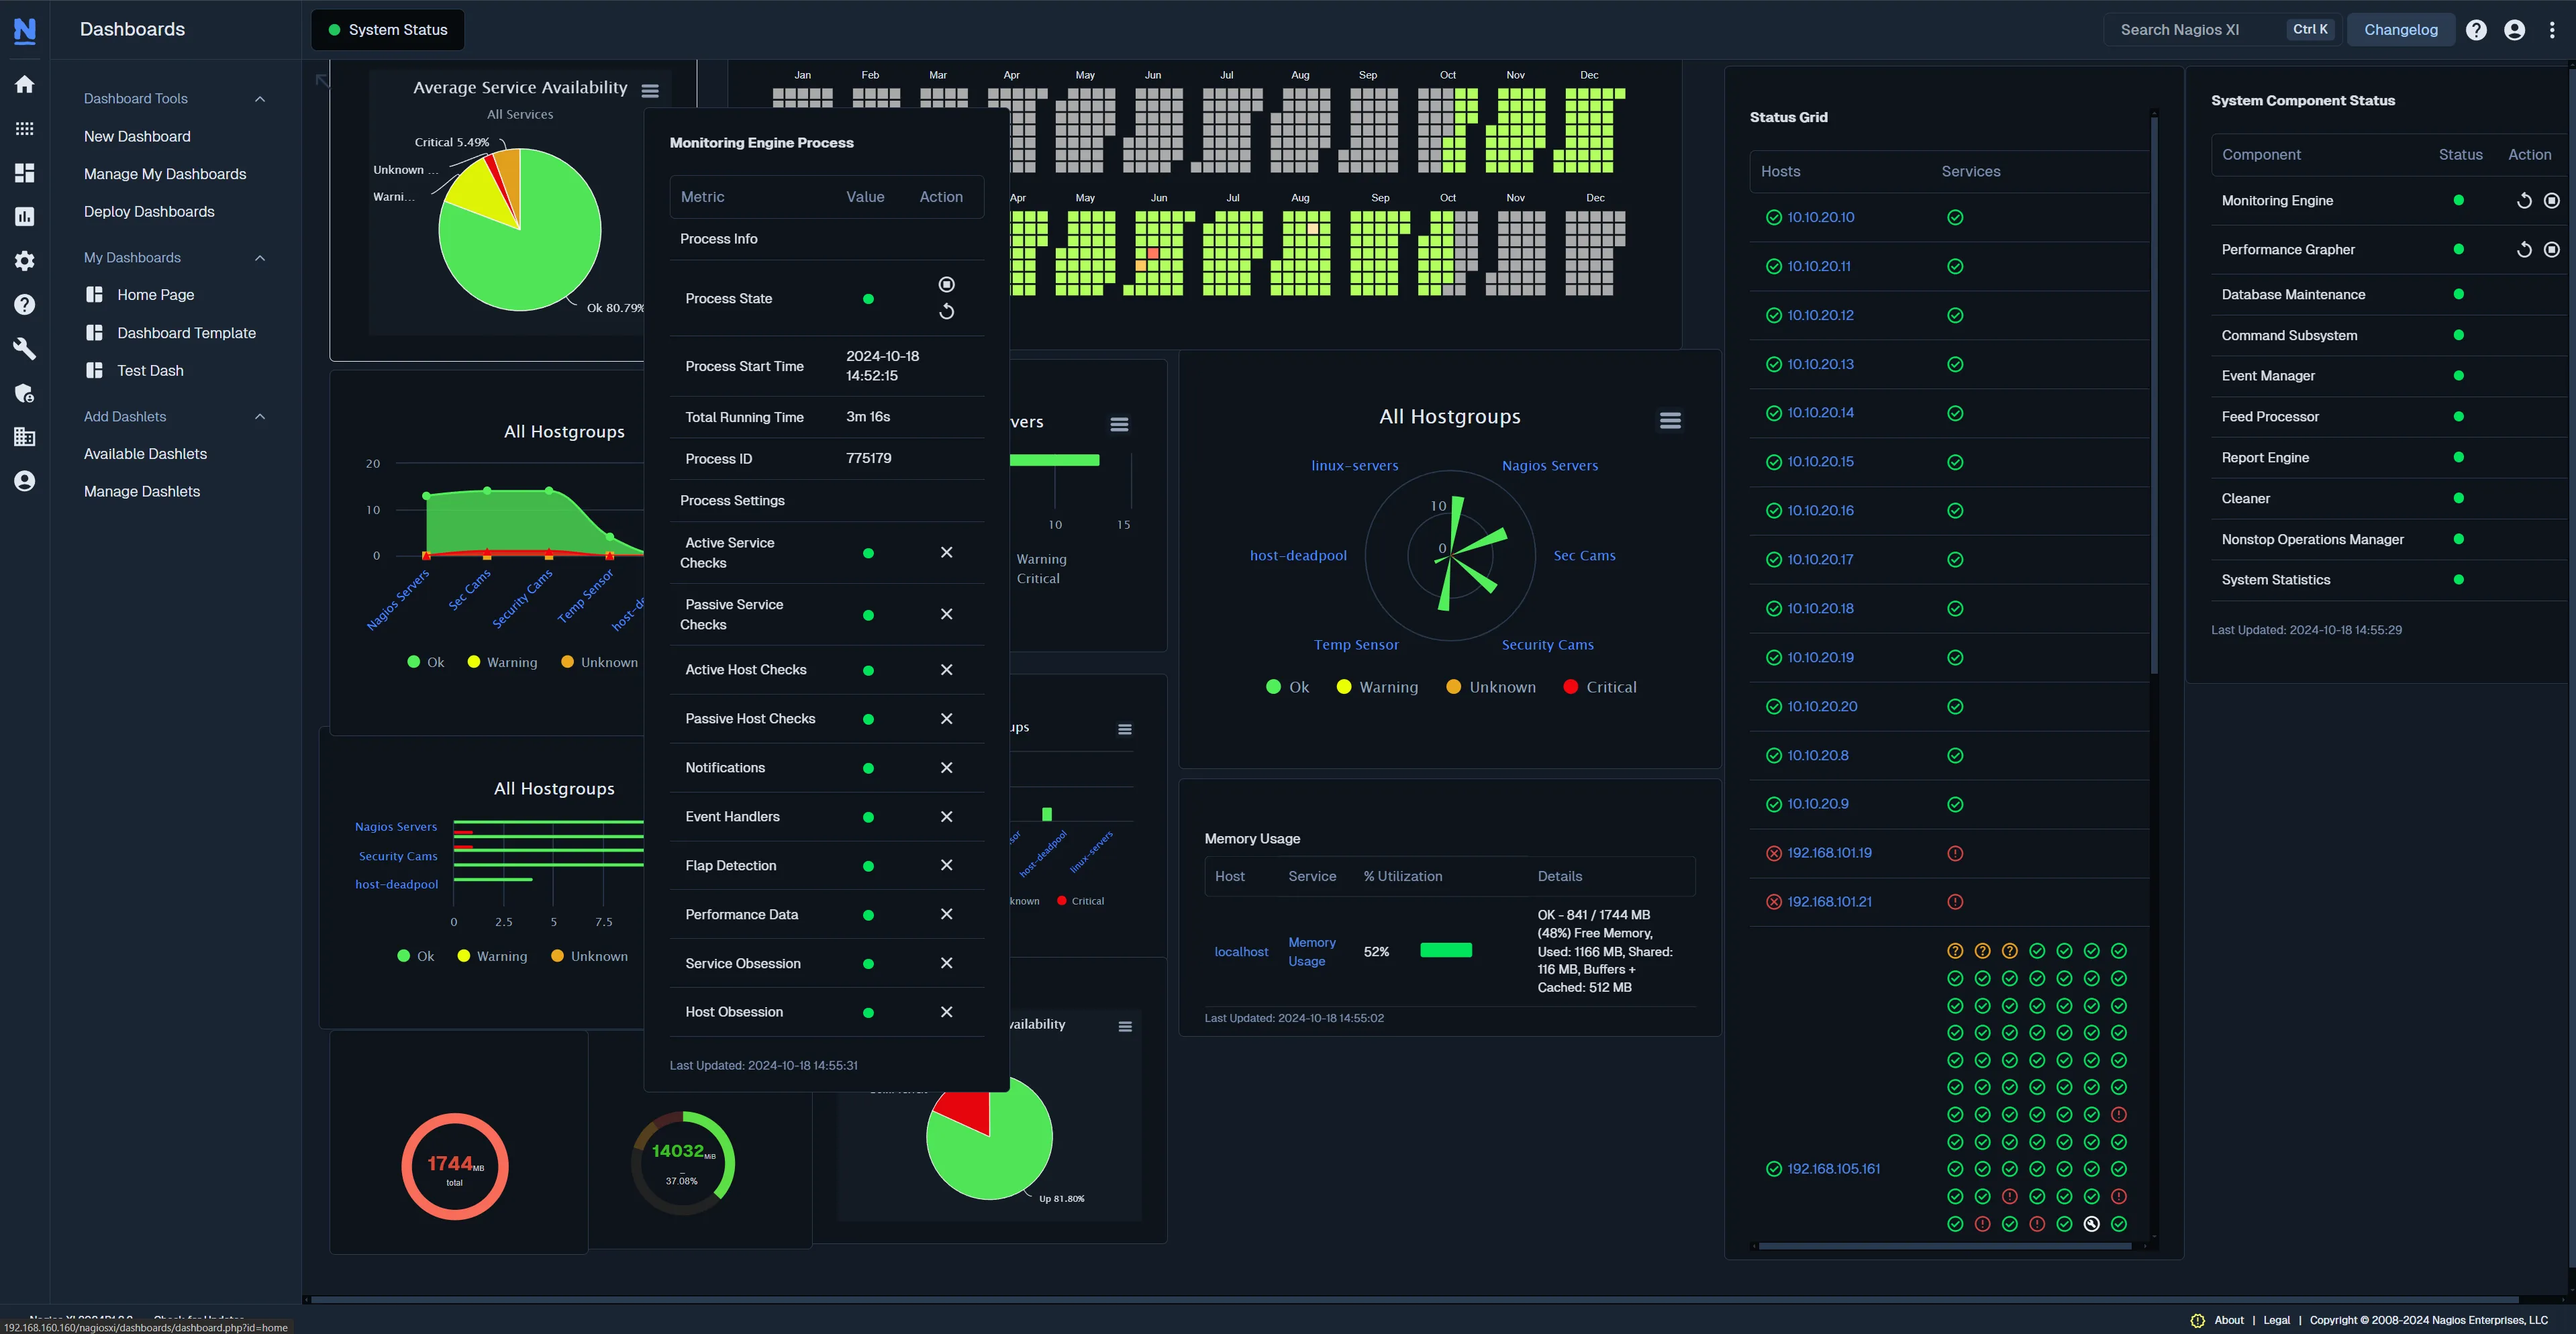
Nagios ist der “Großvater” des Monitorings. Während er nach modernen Standards als Legacy-Technologie gilt, ist er dank seiner Stabilität und seines riesigen Ökosystems an Check-Skripten noch immer weit verbreitet.
Wichtigste Funktionen
- Plugin-Ökosystem: Wenn ein Gerät existiert, gibt es wahrscheinlich ein Perl- oder Bash-Skript, um es in Nagios zu überwachen.
- Binärer Status-Fokus: Hervorragend beim definitiven “OK/CRITICAL”-Alerting.
Vorteile
- Zuverlässigkeit: Äußerst stabil und einfach in seiner Logik.
- Universalität: Fast jeder Sysadmin weiß, wie man einen Nagios-Alert liest.
Nachteile
- Veraltet: Die Konfiguration ist dateibasiert und spröde. Die UI ist aus einer anderen Ära.
- Metriken: Es ist fundamental ein Status-Check-Tool, kein Metrik-/Graphing-Tool. Normalerweise müssen Sie es mit etwas anderem für Diagramme kombinieren.
Am besten für: Legacy-Umgebungen, in denen “if it ain’t broke, don’t fix it” gilt, oder für sehr spezifische Hardware-Prüfungen, die nur Nagios-Plugins unterstützen.
Preis Nagios Core (Open Source) ist kostenlos. Nagios XI (kommerziell) ab $2.495 für eine Standardlizenz (bis 100 Nodes).
Fazit
Netdata ist ein fantastisches Tool für das, was es tut: Ihnen einen unglaublich hochaufgelösten Blick auf einen einzelnen Server zu geben, praktisch kostenlos. Aber für viele Teams macht die Komplexität der Skalierung und das Fehlen integrierter Logs und Alert-Historie es zu einem Sprungbrett statt zu einem endgültigen Ziel.
- Für die beste Balance aus Einfachheit und Leistung: Probieren Sie Simple Observability. Es vereinfacht das Chaos zu einem sauberen, verwertbaren Dashboard.
- Für Kubernetes/Cloud-Native: Gehen Sie mit Prometheus + Grafana.
- Für tiefe Enterprise-Budgets: Datadog ist die Luxuswahl.
Wählen Sie das Tool, das zu den Fähigkeiten Ihres Teams und dem Budget Ihrer Organisation passt. Für direkte Vergleiche siehe unsere Auswertungen zu Netdata vs Zabbix und Netdata vs Prometheus.