



Netdata est une plateforme de supervision open source bien connue, dotée d’une architecture distribuée et edge-first unique qui permet des métriques en temps réel avec une granularité à la seconde. Si cette approche est puissante pour certains cas d’usage, elle a un prix : une consommation de ressources plus élevée sur chaque nœud et une complexité accrue lors de la mise à l’échelle sur des centaines de serveurs.
Si vous cherchez quelque chose de plus simple, Simple Observability offre une alternative légère. Elle s’appuie sur un agent open source qui consomme un minimum de ressources et s’installe littéralement en une seule commande. Tout le reste se configure via l’interface, ce qui vous évite de jongler avec du YAML.
Dans cet article, nous passons en revue les meilleures alternatives à Netdata en 2026. Nous commençons par un aperçu de ce que Netdata fait bien (et de ses faiblesses), puis nous couvrons les critères clés à prendre en compte lors de l’évaluation d’outils de supervision. Enfin, nous comparons chaque option pour vous aider à trouver celle qui convient à votre équipe. Si vous évaluez aussi d’autres outils, consultez nos guides sur les alternatives à Zabbix et l’alternative à Nagios.
Résumé rapide
| Outil | Idéal pour | Modèle de prix |
|---|---|---|
| Simple Observability | Simplicité et unification | $3 / mois / serveur |
| Prometheus & Grafana | Cloud natif / K8s | Gratuit (OSS) / managed payant |
| Checkmk | IT complexe / hybride | ~$6 / hôte / mois |
| Datadog | Entreprise / cloud | $15+ / hôte / mois |
| New Relic | Performance applicative (APM) | À l’usage ($0.30/GB) |
| Icinga | Configuration flexible | Gratuit (OSS) |
| Zabbix | Réseau / on-prem | $50 / mois (Cloud) |
| Nagios | Stabilité héritée | $2,495+ (licence XI) |
Présentation de Netdata
Ce pour quoi il est connu
Netdata est surtout connu pour ses données en temps réel et haute résolution. La plateforme collecte les métriques système chaque seconde et maintient une latence d’environ 1 seconde entre la collecte et la visualisation. Elle est conçue pour le dépannage immédiat quand vous avez besoin de ce niveau de granularité.
Fonctionnalités clés
- Métriques en temps réel : granularité à la seconde pour un retour immédiat.
- ML non supervisée : détection d’anomalies intégrée qui signale les valeurs aberrantes sans seuils manuels.
- Auto-découverte : détecte automatiquement les services et applications qui tournent sur l’hôte.
- Architecture distribuée : les données sont généralement stockées en périphérie (sur le nœud lui-même), ce qui réduit les coûts de stockage central mais augmente la consommation de ressources locale.
Pourquoi chercher une alternative à Netdata ?
Si Netdata excelle en supervision temps réel d’un nœud unique, son architecture pose quelques défis pratiques.
1. Passage à l’échelle dans les environnements dynamiques
La nature distribuée de Netdata fonctionne bien pour l’efficacité du stockage, mais la gérer sur des centaines de conteneurs éphémères ou de microservices devient vite complexe. Agréger les données de milliers de nœuds nécessite généralement une configuration importante, sinon vous dépendez de Netdata Cloud, qui apporte ses propres coûts et sa propre complexité.
2. Surconsommation de ressources
Parce que Netdata traite des données haute résolution et exécute la détection d’anomalies directement sur chaque agent, il consomme plus de CPU et de RAM que des collecteurs légers comme Telegraf ou l’agent Simple Observability. Dans les environnements contraints en ressources, cet effet d’observation peut devenir un vrai problème.
3. Piliers d’observabilité manquants
Netdata est avant tout un outil de métriques. Il a récemment ajouté la gestion des journaux (indexation des logs en périphérie), mais il manque toujours un support natif du tracing distribué. C’est au programme pour 2026, mais si vous avez besoin d’une observabilité full-stack (métriques, logs et traces) dès aujourd’hui, vous devrez combiner plusieurs outils.
Comment choisir une alternative ?
Lors de l’évaluation des alternatives, prenez en compte ces critères fondamentaux :
- Efficacité de l’agent : privilégiez des agents légers écrits dans des langages performants (Go, Rust, C++) qui n’impacteront pas vos workloads de production.
- Observabilité unifiée : l’outil prend-il en charge métriques, logs et alertes dans une interface unique ?
- Facilité d’usage : pouvez-vous le configurer en quelques minutes (Time-to-Value), ou faut-il des semaines de configuration ?
- Prix : le modèle de tarification est-il prévisible ? Évitez les outils avec une facturation au compteur complexe si vous avez un budget strict.
8 meilleures alternatives à Netdata
1. Simple Observability
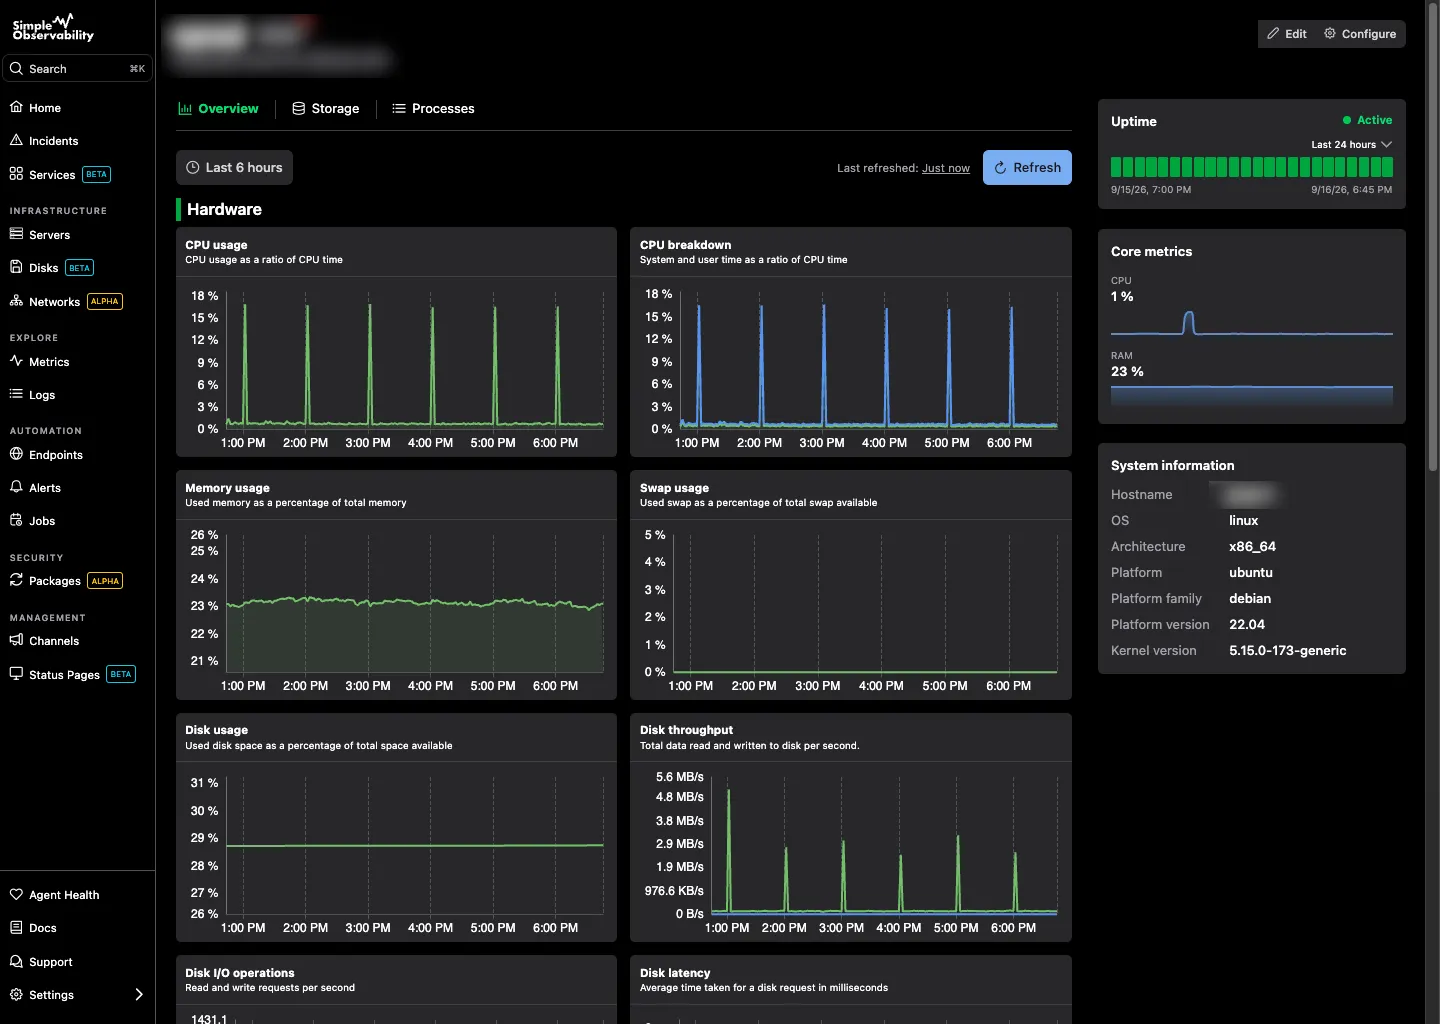
Simple Observability est une plateforme de supervision de serveurs conçue pour être l’alternative la plus directe pour les équipes qui veulent des résultats sans les tracas. Elle combine métriques et logs dans une interface unifiée, remplaçant sans doute trois outils distincts (Métriques, Logs, Disponibilité) par un seul.
Fonctionnalités clés
- Tableau de bord unifié : visualisez les pics CPU/mémoire aux côtés des journaux applicatifs dans la même vue.
- Alertes sans configuration : des valeurs par défaut pertinentes vous protègent dès le premier jour.
- Agent léger : agent open source hautement optimisé qui respecte les ressources de votre serveur.
- Commodité SaaS : pas besoin d’héberger votre propre base de données de métriques ou votre stack de rétention.
Simple Observability vs Netdata Contrairement à Netdata, qui peut s’avérer écrasant avec des milliers de métriques prêtes à l’emploi, Simple Observability se concentre sur le signal plutôt que le bruit. Elle fournit les métriques critiques dont vous avez réellement besoin pour faire tourner des systèmes en production, stockées de façon centralisée pour ne pas perdre de données si un nœud tombe (un risque avec le stockage local par défaut de Netdata).
Avantages
- Extrêmement facile à utiliser : installation en une commande, zéro configuration requise.
- Tarification prévisible : forfait fixe par serveur. Pas de surprises en « par million de métriques custom » ou « par GB de logs ».
- Données historiques complètes : rétention long terme incluse par défaut.
Inconvénients
- Moins granulaire : là où Netdata offre une résolution à la seconde, Simple Observability utilise des intervalles standards de 60 s pour garder des coûts et une bande passante raisonnables.
Idéal pour : Startups, agences et équipes DevOps qui veulent une supervision « configurer et oublier » qui fonctionne, simplement.
Prix
- Gratuit : $0 pour 1 serveur.
- Payant : $3/mo par serveur pour des serveurs illimités.
- Sur mesure : remises sur volume pour les grandes flottes.
2. Prometheus & Grafana
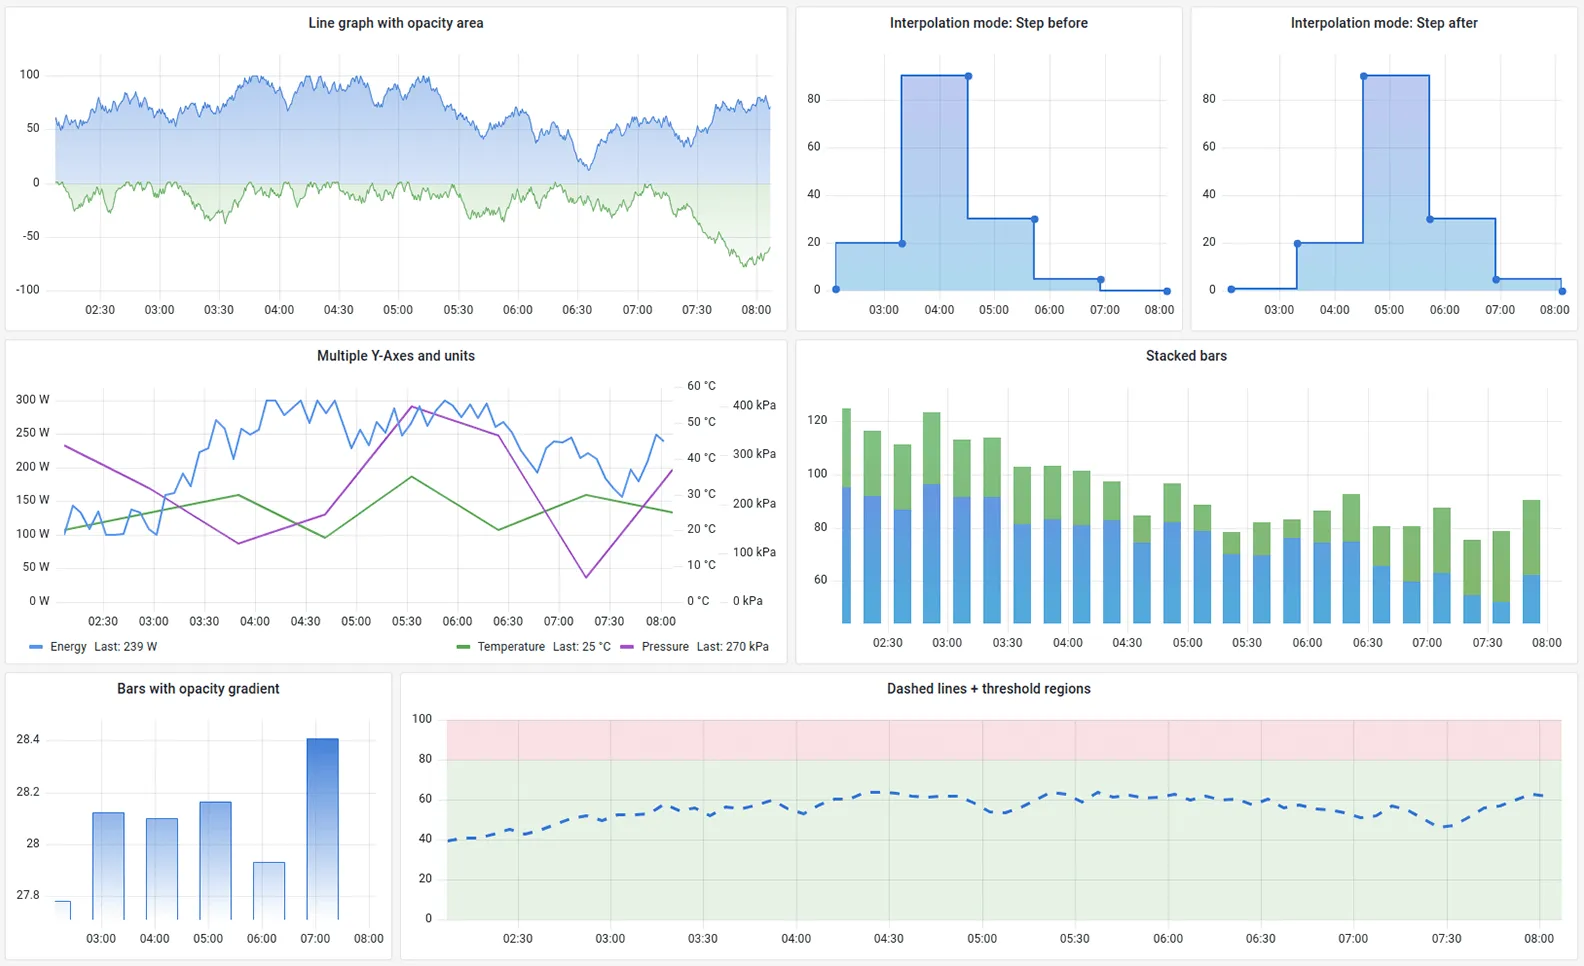
Prometheus couplé à Grafana est le standard de l’industrie pour la supervision cloud-native. C’est une combinaison open source puissante où Prometheus collecte les métriques et Grafana les visualise.
Fonctionnalités clés
- Modèle de données multi-dimensionnel : requêtes puissantes avec PromQL.
- Écosystème immense : des exportateurs existent pour presque tous les logiciels (Redis, Postgres, Nginx, etc.).
- Alertmanager : gère les alertes avec un routage et un regroupement sophistiqués.
Avantages
- Standard de l’industrie : le choix de facto pour la supervision Kubernetes.
- Open source : entièrement gratuit à l’usage si auto-hébergé.
- Flexibilité : vous pouvez créer n’importe quel tableau de bord imaginable dans Grafana.
Inconvénients
- Complexité : nécessite l’installation et la maintenance de deux logiciels distincts (Prometheus + Grafana).
- Stockage : vous êtes responsable de la gestion du stockage long terme et des sauvegardes (requiert souvent d’ajouter Thanos ou Cortex pour la scalabilité).
- Courbe d’apprentissage abrupte : PromQL est puissant mais demande du temps à maîtriser comparé à des interfaces cliquer-glisser.
Idéal pour : Environnements Kubernetes, équipes d’ingénierie de plateforme et organisations disposant de ressources SRE dédiées.
Prix Gratuit (Open Source). Cependant, le passage à l’échelle nécessite généralement des extensions de stockage payantes (Thanos) ou des services managed comme Grafana Cloud ou Amazon Managed Prometheus, qui sont facturés à l’usage.
3. Checkmk
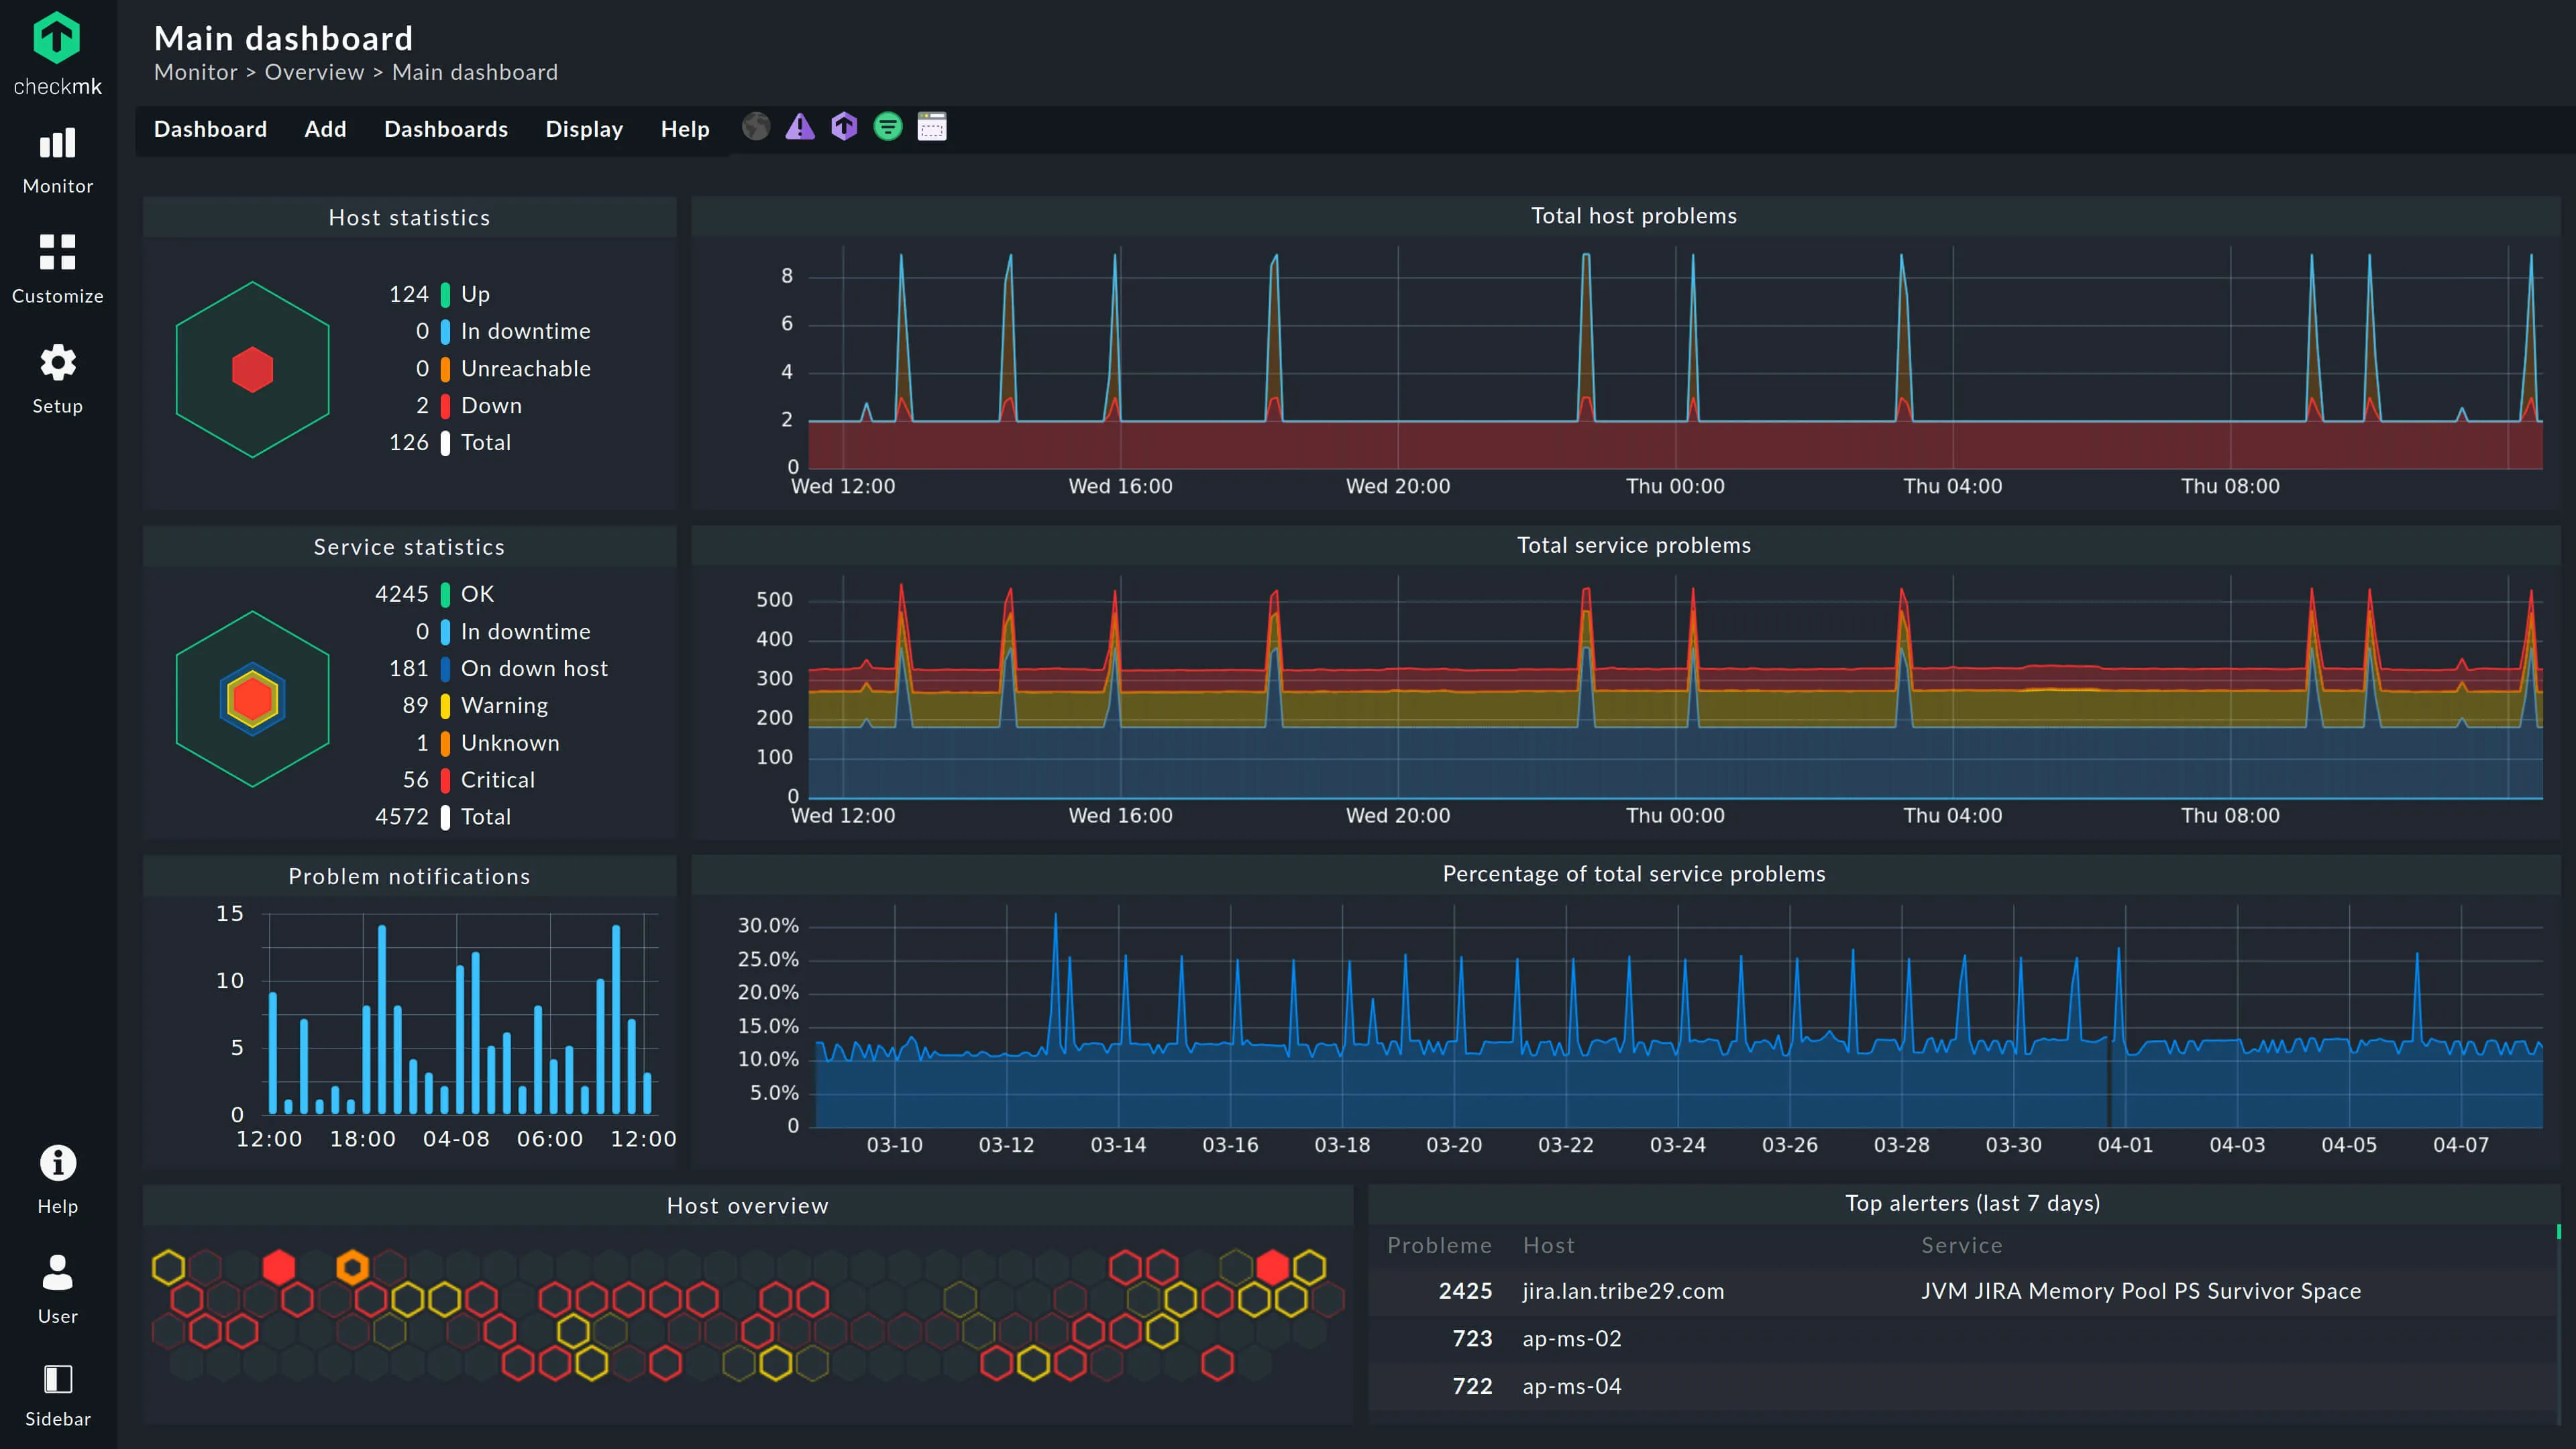
Checkmk est un outil de supervision complet qui excelle dans les environnements IT complexes et hybrides. Il fait le pont entre les checks à l’ancienne façon Nagios et la collecte de métriques moderne.
Fonctionnalités clés
- Supervision hybride : aussi bon pour superviser du bare metal, des switches que des conteneurs Docker.
- Découverte automatique des services : scanne les hôtes pour trouver automatiquement les services en cours d’exécution et configurer les checks.
- 2,000+ plugins : une bibliothèque d’intégrations massive.
Avantages
- Tout-en-un : gère aussi bien la supervision par état (Up/Down) que les performances de métriques.
- Scalable : peut gérer des milliers de services sur un seul serveur grâce à son cœur efficace.
Inconvénients
- Interface/UX : l’interface, bien que fonctionnelle, peut paraître chargée et datée comparée aux outils SaaS modernes.
- Configuration : extrêmement puissant mais avec une courbe d’apprentissage abrupte pour les fonctionnalités avancées.
Idéal pour : Sysadmins et départements IT qui gèrent un mélange de matériel hérité, de serveurs on-prem et d’instances cloud.
Prix L’édition Open Source est gratuite. L’édition Enterprise démarre à ~$2,100/an pour 3,000 services (environ 100 hôtes). Les éditions SaaS démarrent à ~$6 par hôte/mois (facturées par service).
4. Datadog
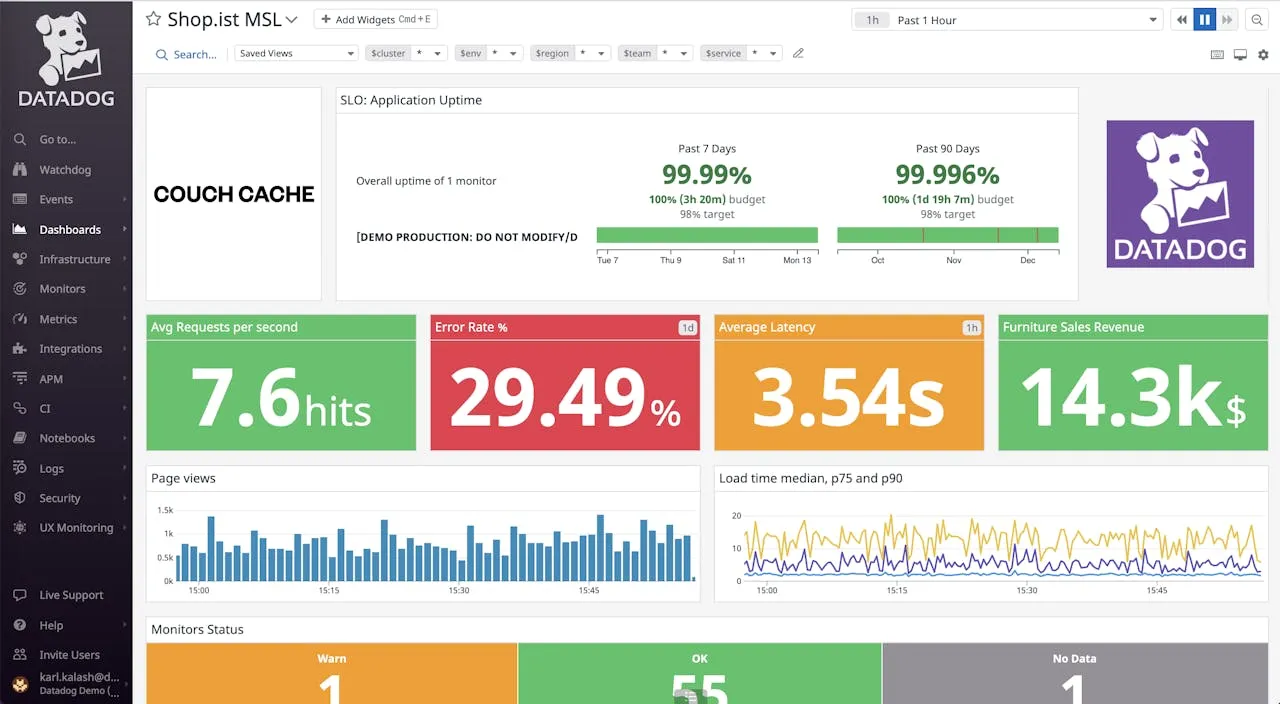
Datadog est le poids lourd de l’espace observabilité. Il offre une plateforme massive et unifiée couvrant tous les angles possibles de la supervision : infrastructure, APM, logs, sécurité, réseau et RUM.
Fonctionnalités clés
- Observabilité full-stack : corrélation de données véritablement unifiée entre traces, logs et métriques.
- Watchdog AI : détection d’anomalies automatisée qui repère souvent les problèmes avant vous.
- 400+ intégrations : intégrations en quelques clics pour AWS, Azure, Google Cloud et des outils SaaS.
Avantages
- Interface soignée : intuitive, rapide et réellement agréable à utiliser.
- Visibilité profonde : le niveau de détail pour l’APM et le tracing est inégalé.
Inconvénients
- Coût : notoirement cher. Le prix « par hôte » n’est que le ticket d’entrée ; les métriques custom, l’ingestion de logs et la rétention s’additionnent vite.
- Vendor lock-in : l’agent propriétaire et le format de données rendent difficile de partir une fois profondément intégré.
Idéal pour : Grandes entreprises et sociétés tech en forte croissance où la vélocité d’ingénierie compte plus que l’optimisation de la facture de supervision.
Prix L’infrastructure démarre à $15/hôte/mois. Cependant, ce n’est rarement le prix final. L’APM, les logs ($0.10/GB indexés) et les métriques custom sont tous facturés séparément, doublant ou triplant souvent le coût de base en production.
5. New Relic
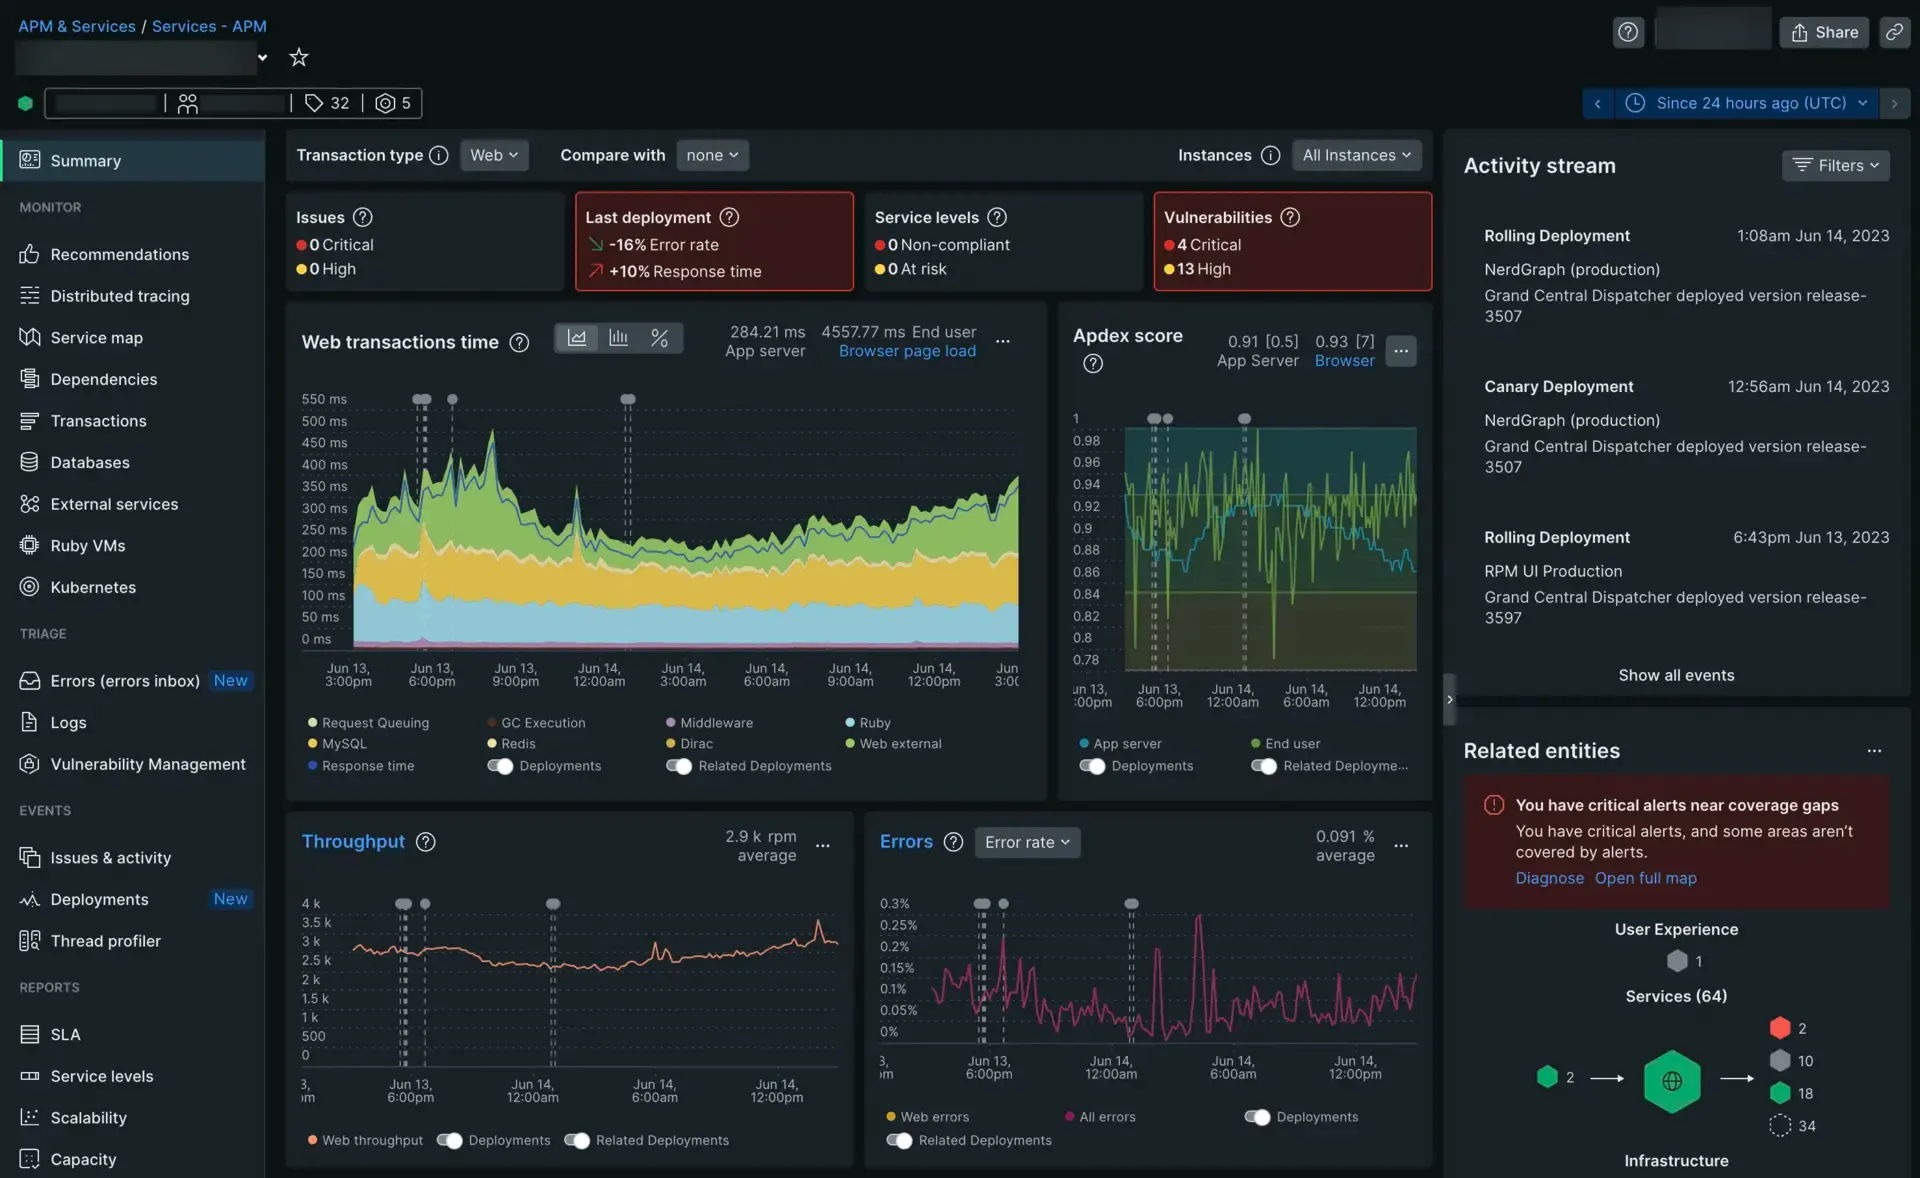
New Relic est un vétéran de l’espace APM qui a évolué en plateforme d’observabilité full-stack. Il est particulièrement adapté aux développeurs qui ont besoin d’une visibilité profonde au niveau du code pour déboguer les problèmes de performance applicative.
Fonctionnalités clés
- APM approfondi : tracing au niveau du code pour identifier les requêtes de base de données lentes ou les fonctions inefficaces.
- Browser et mobile : support natif du suivi de l’expérience utilisateur final (RUM) sur les applications web et mobiles.
- Applied intelligence : insights pilotés par l’IA pour détecter les anomalies et corréler les événements.
Avantages
- Plateforme de données unifiée : toute la télémétrie (métriques, logs, traces) est stockée au même endroit.
- Offre gratuite : offre gratuite généreuse (100 GB/mois) pour les petites équipes.
Inconvénients
- Complexité : la plateforme est vaste et la navigation dans l’interface peut s’avérer écrasante pour des besoins simples.
- Modèle de prix : si l’offre gratuite est bonne, la tarification par utilisateur pour un accès complet peut devenir chère pour les grandes équipes.
Idéal pour : Équipes de développement axées sur la supervision de performance applicative (APM) et le débogage full-stack.
Prix À l’usage : gratuit jusqu’à 100 GB/mois. Les plans payants démarrent à $0.30/GB ingérés + des frais par siège utilisateur ($99/mo pour Core, $549/mo pour Plus).
6. Icinga
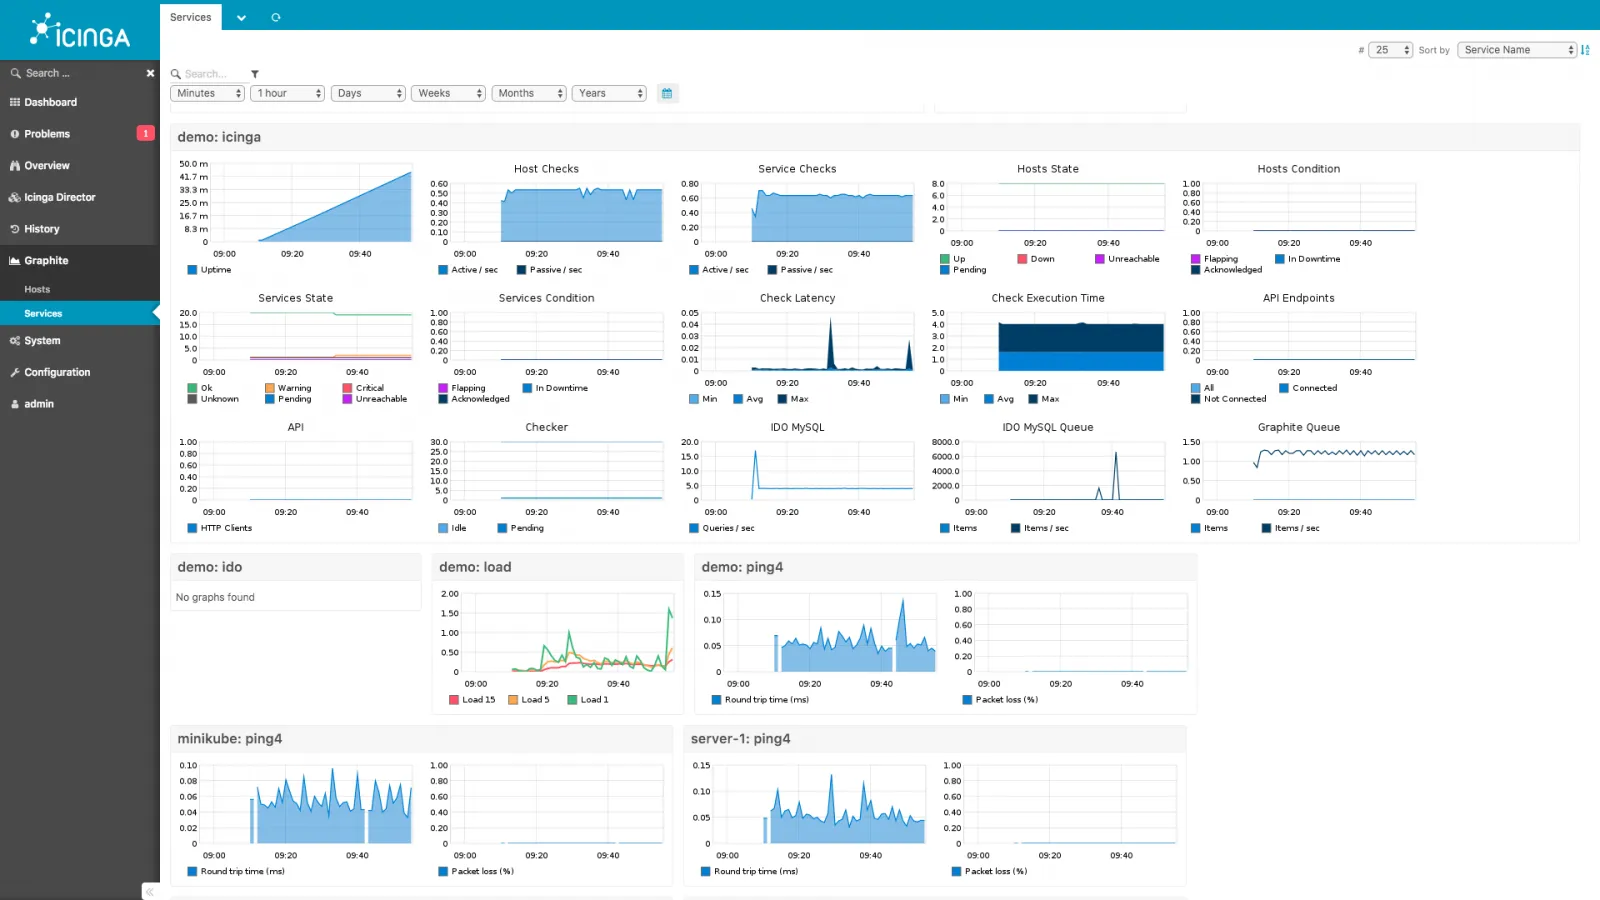
Né comme un fork de Nagios, Icinga a modernisé l’approche classique de supervision. Il conserve la compatibilité avec les plugins Nagios mais ajoute une interface web moderne, une API de configuration robuste et des fonctionnalités de scalabilité.
Fonctionnalités clés
- Icinga Director : un outil web pour gérer la configuration, plus simple que l’édition de fichiers de config.
- Supervision distribuée : support intégré des architectures distribuées et de la haute disponibilité.
- Compatibilité des plugins : compatible avec des milliers de plugins Nagios existants.
Avantages
- Le classique modernisé : la fiabilité de Nagios avec une bien meilleure interface et API.
- Support commercial : disponible pour les déploiements d’entreprise où « gratuit » ne suffit pas.
Inconvénients
- Effort de mise en place : nécessite encore une configuration et une installation importantes comparé aux outils SaaS.
- Courbe d’apprentissage : comprendre le langage de configuration et le modèle objet demande du temps.
Idéal pour : Sysadmins qui aiment la flexibilité de Nagios mais veulent un outil plus moderne, piloté par API et scalable.
Prix Gratuit (Open Source). Support commercial disponible.
7. Zabbix
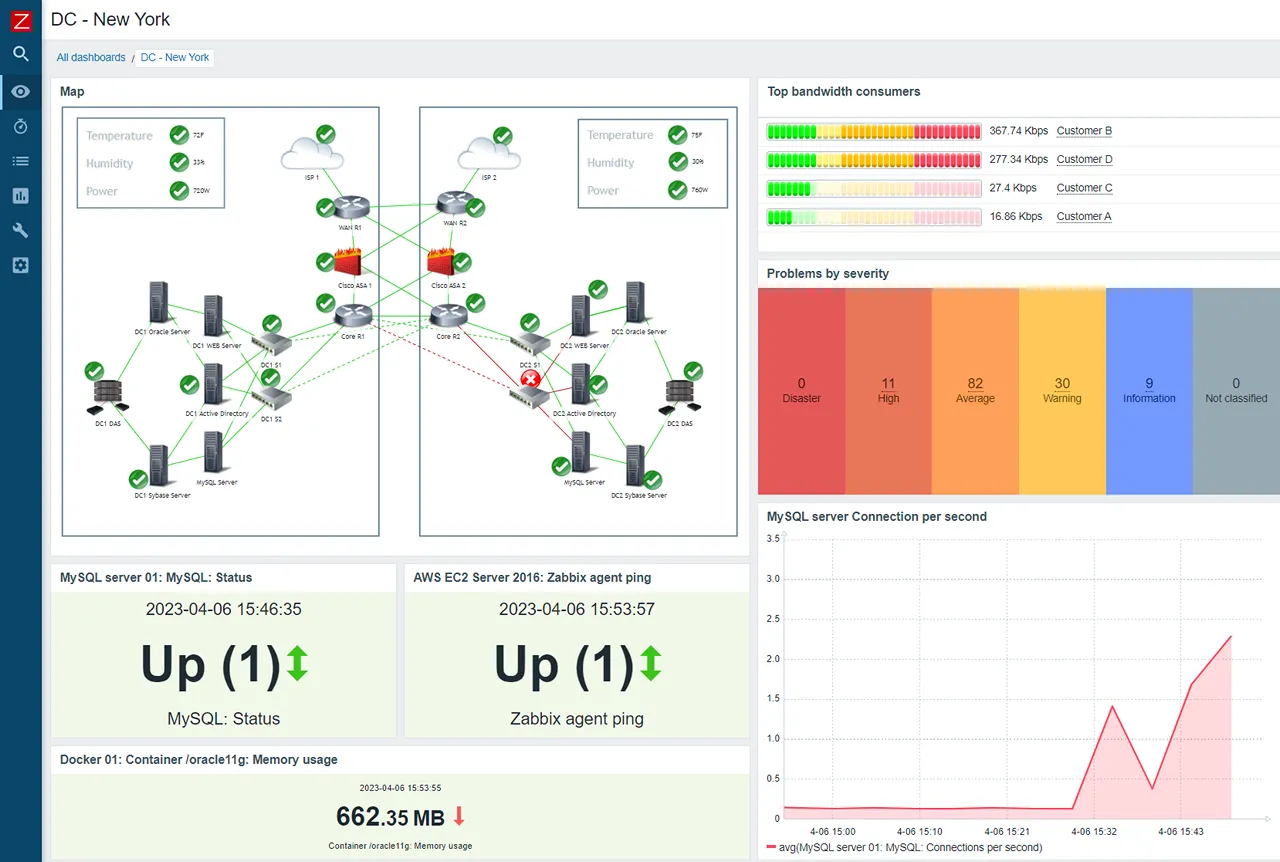
Zabbix est une plateforme open source mature et de niveau entreprise. C’est une puissance de supervision traditionnelle, prisée par les ingénieurs réseau et les grandes entreprises classiques.
Fonctionnalités clés
- Avec et sans agent : peut superviser via SNMP, JMX, IPMI et son propre agent.
- Push et pull : supporte à la fois le polling et le trapping comme méthodes de collecte.
- Permissions granulaires : excellent multi-tenant et contrôles d’accès utilisateurs.
Avantages
- Disponibilité SaaS : Zabbix Cloud offre une voie managed pour les équipes qui ne veulent pas la charge de l’auto-hébergement.
- Éprouvé : testé au combat dans des environnements massifs depuis des décennies.
Inconvénients
- Complexité : la configuration peut être très verbeuse (XML/templates) et chronophage.
- Modernité : manque les intégrations cloud-native fluides et le ressenti des outils d’observabilité modernes.
Idéal pour : Centres d’opérations réseau (NOC), MSP et organisations avec une infrastructure on-prem lourde nécessitant un support dédié ou un environnement de supervision managé.
Prix Bien que le logiciel soit Open Source, l’usage professionnel s’oriente souvent vers Zabbix Cloud qui démarre à $50/mo. Le support et la formation de niveau entreprise sont aussi des services payants.
8. Nagios
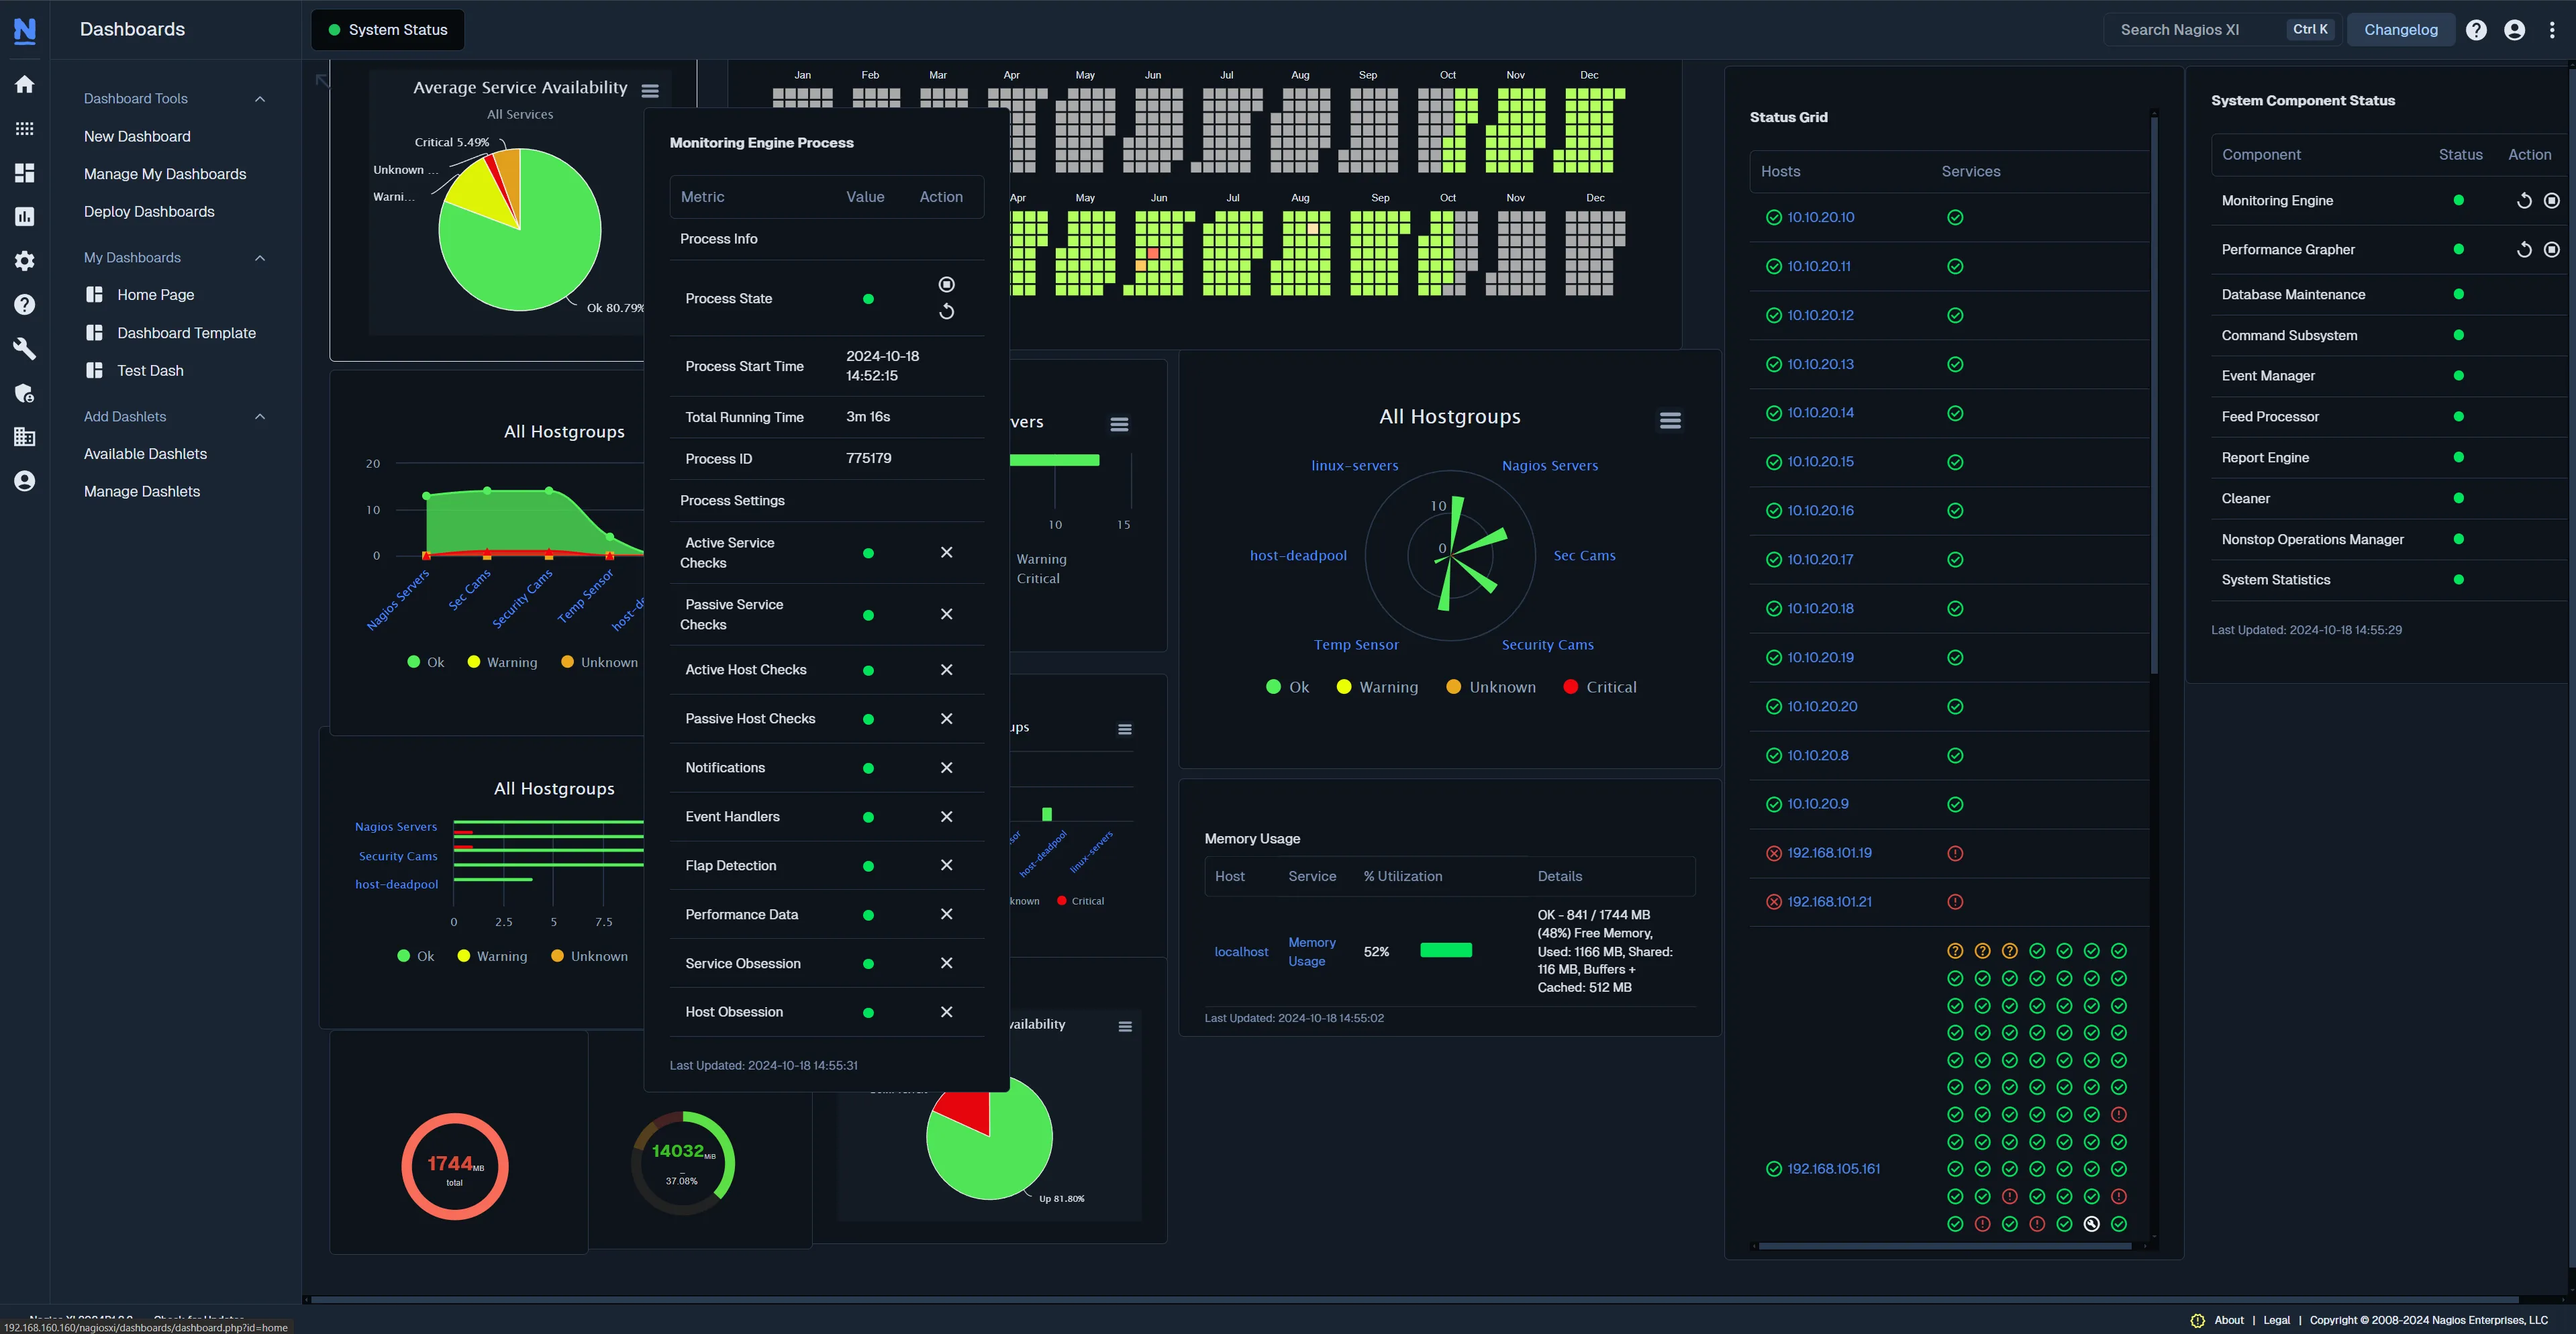
Nagios est le « grand-père » de la supervision. Bien qu’effectivement considéré comme une technologie héritée par les standards modernes, il reste largement déployé grâce à sa stabilité et son vaste écosystème de scripts de check.
Fonctionnalités clés
- Écosystème de plugins : si un appareil existe, il y a probablement un script Perl ou Bash pour le superviser dans Nagios.
- Focus sur l’état binaire : excellent pour l’alerte définitive « OK/CRITICAL ».
Avantages
- Fiabilité : extrêmement stable et simple dans sa logique.
- Universel : presque chaque sysadmin sait lire une alerte Nagios.
Inconvénients
- Obsolète : la configuration est basée sur des fichiers et fragile. L’interface appartient à une autre époque.
- Métriques : c’est fondamentalement un outil de check d’état, pas de métriques ou de graphiques. Il faut généralement le coupler avec autre chose pour avoir des graphiques.
Idéal pour : Environnements hérités où « on ne change pas ce qui marche », ou pour des checks matériels très spécifiques que seuls les plugins Nagios supportent.
Prix Nagios Core (Open Source) est gratuit. Nagios XI (commercial) démarre à $2,495 pour une licence standard (jusqu’à 100 nœuds).
Conclusion
Netdata est un outil fantastique pour ce qu’il fait : vous offrir une vue incroyablement haute résolution d’un serveur unique, et ce pratiquement gratuitement. Mais pour beaucoup d’équipes, la complexité de le passer à l’échelle et l’absence de logs et d’historique d’alerte intégrés en font une étape intermédiaire plutôt qu’une destination finale.
- Pour le meilleur équilibre simplicité-puissance : essayez Simple Observability. Elle transforme le chaos en un tableau de bord clair et actionnable.
- Pour Kubernetes / cloud-native : optez pour Prometheus + Grafana.
- Pour les budgets d’entreprise conséquents : Datadog est le choix de luxe.
Choisissez l’outil qui correspond aux compétences de votre équipe et au budget de votre organisation. Pour des comparaisons détaillées, consultez nos analyses Netdata vs Zabbix et Netdata vs Prometheus.