



O Checkmk é uma das plataformas de monitoramento mais capazes disponíveis. Sua auto-discovery é genuinamente impressionante, o motor principal lida com milhares de serviços em hardware modesto e cobre tudo, de bare metal a containers.
Mas se você está procurando uma alternativa ao Checkmk, provavelmente já esbarrou na lacuna entre o que o Checkmk pode fazer e quanto esforço é preciso para chegar lá. A configuração baseada em regras é poderosa, mas densa. Implantações multi-site precisam de planejamento cuidadoso. E a UI não acompanhou o que equipes modernas esperam.
Este artigo cobre sete alternativas práticas, começando com uma comparação rápida, depois os pontos de dor específicos que afastam as equipes do Checkmk e, por fim, uma análise honesta de cada opção, incluindo quando o Checkmk ainda é a escolha certa.
Resumo rápido
| Ferramenta | Melhor para | Complexidade | Preço |
|---|---|---|---|
| Simple Observability | Simplicidade e zero ops | Baixa | $3/mês por servidor |
| Zabbix | Grandes frotas on-prem | Alta | Grátis (OSS) / $50/mês (Cloud) |
| Prometheus + Grafana | Kubernetes / cloud native | Alta | Grátis (OSS) / Gerenciado pago |
| Netdata | Visibilidade em tempo real de nó único | Baixa | Grátis / ~$4,50/nó/mês |
| SigNoz | Métricas, logs e traces unificados | Média | Grátis (OSS) / $49/mês (Cloud) |
| ManageEngine OpManager | TI com foco em Windows e rede | Média | $245/ano (25 dispositivos) |
| Atera | MSPs / Departamentos de TI | Baixa | $149/técnico/mês |
Por que as equipes procuram uma alternativa ao Checkmk
As frustrações com o Checkmk tendem a ser operacionais, não funcionais. A ferramenta funciona. O problema é quanto tempo leva para mantê-la funcionando.
O motor de regras é poderoso, mas opaco
O modelo de configuração do Checkmk é construído em torno de regras, pastas e host tags. Entender por que um check específico se comporta de determinada maneira muitas vezes exige rastrear por múltiplas camadas de regras. Debugar significa fazer engenharia reversa da precedência de regras entre pastas, host tags e exceções explícitas.
Para equipes sem um especialista dedicado em Checkmk, isso vira um gargalo.
O monitoramento distribuído adiciona sobrecarga real
Setups multi-site exigem configurar replicação, gerenciar ativação entre sites e manter instâncias Apache separadas. Isso faz sentido para grandes empresas, mas é exagero para organizações com 20 a 50 servidores espalhados por algumas localidades.
A gestão de plugins se acumula com o tempo
Mais de 2.000 plugins de check é um ponto forte, mas gerenciar checks locais, fazer deploy de plugins customizados via agent bakery e manter tudo sincronizado entre versões de agente cria trabalho de manutenção que cresce junto com sua infraestrutura.
O preço enterprise é difícil de prever
O Checkmk cobra pelo número de serviços, não por hosts. Um único host pode gerar de 10 a mais de 100 serviços dependendo do que está rodando, tornando a estimativa de custo difícil. A edição Raw gratuita não tem recursos como agent bakery e monitoramento distribuído que a maioria das equipes acaba precisando.
A UI não envelheceu bem
A interface é densa em informações, mas datada. A navegação depende de menus laterais e filtros que exigem familiaridade. Comparada a UIs de monitoramento modernas com dashboards contextuais e drill-downs intuitivos, o Checkmk cria atrito para quem ainda não é especialista.
Como avaliar uma substituição para o Checkmk
Ao comparar concorrentes do Checkmk, foque nos critérios que determinam se uma ferramenta vai realmente reduzir sua carga operacional.
Tempo até o primeiro dashboard. O setup do Checkmk envolve criar sites, adicionar hosts, descobrir serviços e ativar mudanças. Algumas alternativas levam você a um dashboard funcional em menos de cinco minutos.
Filosofia de configuração. O Checkmk usa configuração baseada em regras com herança. Algumas alternativas usam YAML declarativo, outras são totalmente orientadas por UI. A questão-chave é: um novo membro da equipe consegue fazer mudanças sem quebrar nada?
Amplitude de observabilidade. O Checkmk é principalmente uma ferramenta de métricas e checagem de estado. Se você também precisa de logs na mesma plataforma, isso reduz as opções.
Previsibilidade de custo. O preço baseado em serviços do Checkmk dificulta o orçamento. Procure modelos por host ou de taxa fixa se a clareza de orçamento importa para sua equipe.
7 melhores alternativas ao Checkmk
1. Simple Observability
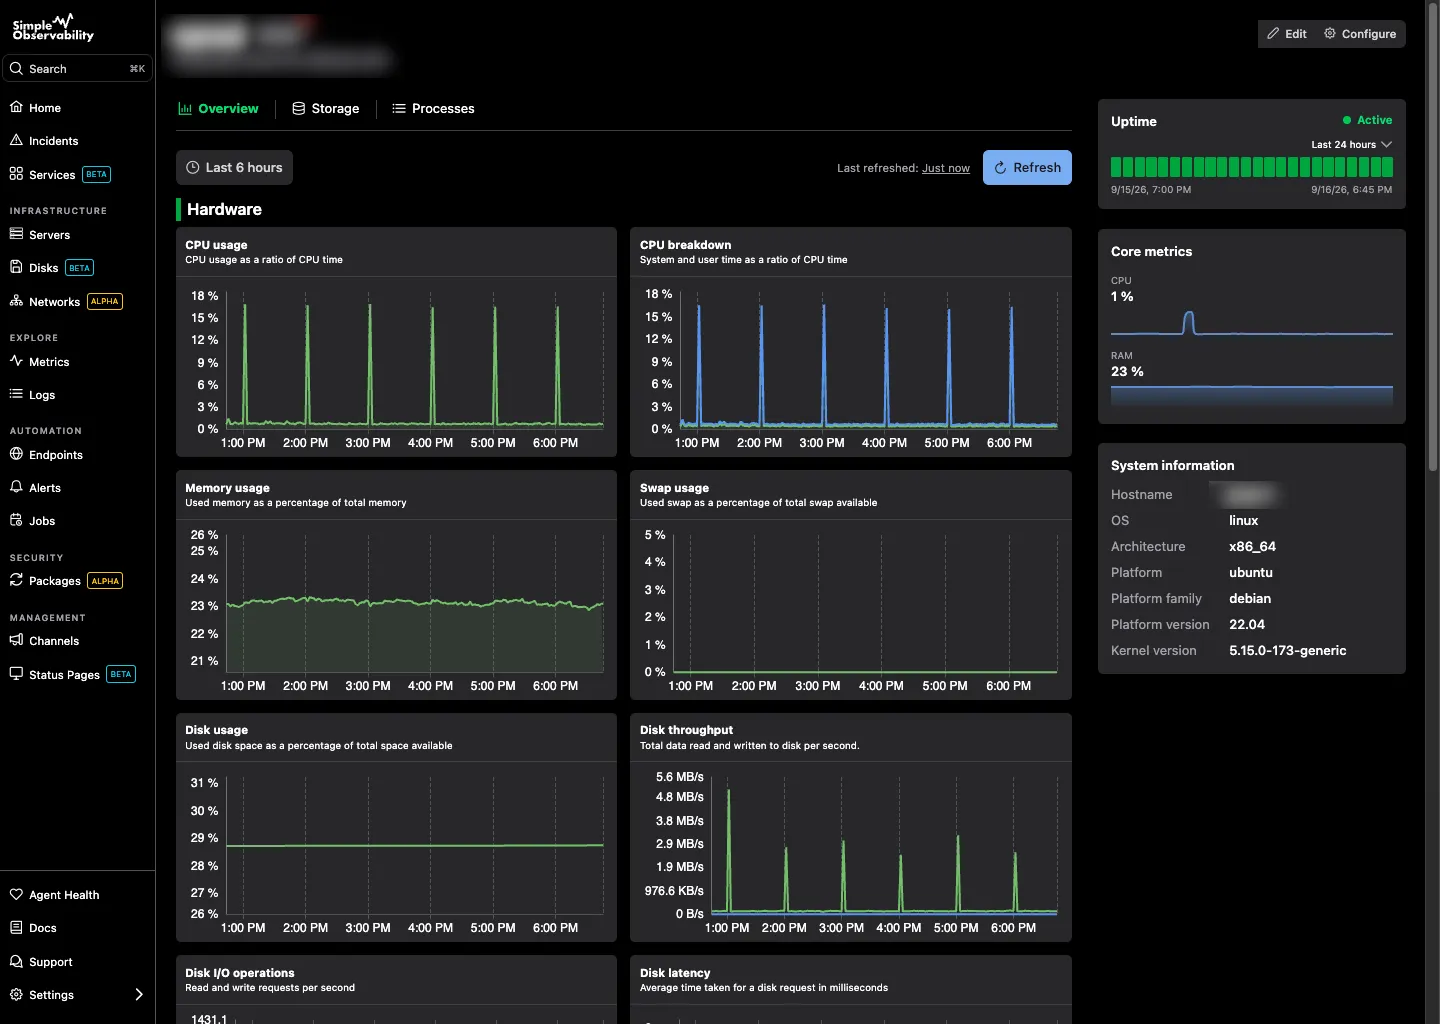
A Simple Observability é feita para ser o oposto do Checkmk em termos de complexidade. Um comando instala o agente. A configuração acontece pela UI. Métricas e logs aparecem na mesma visão. Não há motor de regras para aprender, sites para replicar nem banco de dados para manter.
Melhor para: Frotas de servidores de pequeno a médio porte onde o objetivo é “instalar e seguir em frente”.
Prós
- Instalação com um comando, sem configuração necessária.
- Métricas e logs unificados num único dashboard.
- Preço fixo e previsível por servidor.
Contras
- Controle menos granular que o sistema baseado em regras do Checkmk.
- Apenas SaaS, não adequado para ambientes air-gapped.
Preço: Grátis para 1 servidor. $3/mês por servidor a partir disso.
2. Zabbix
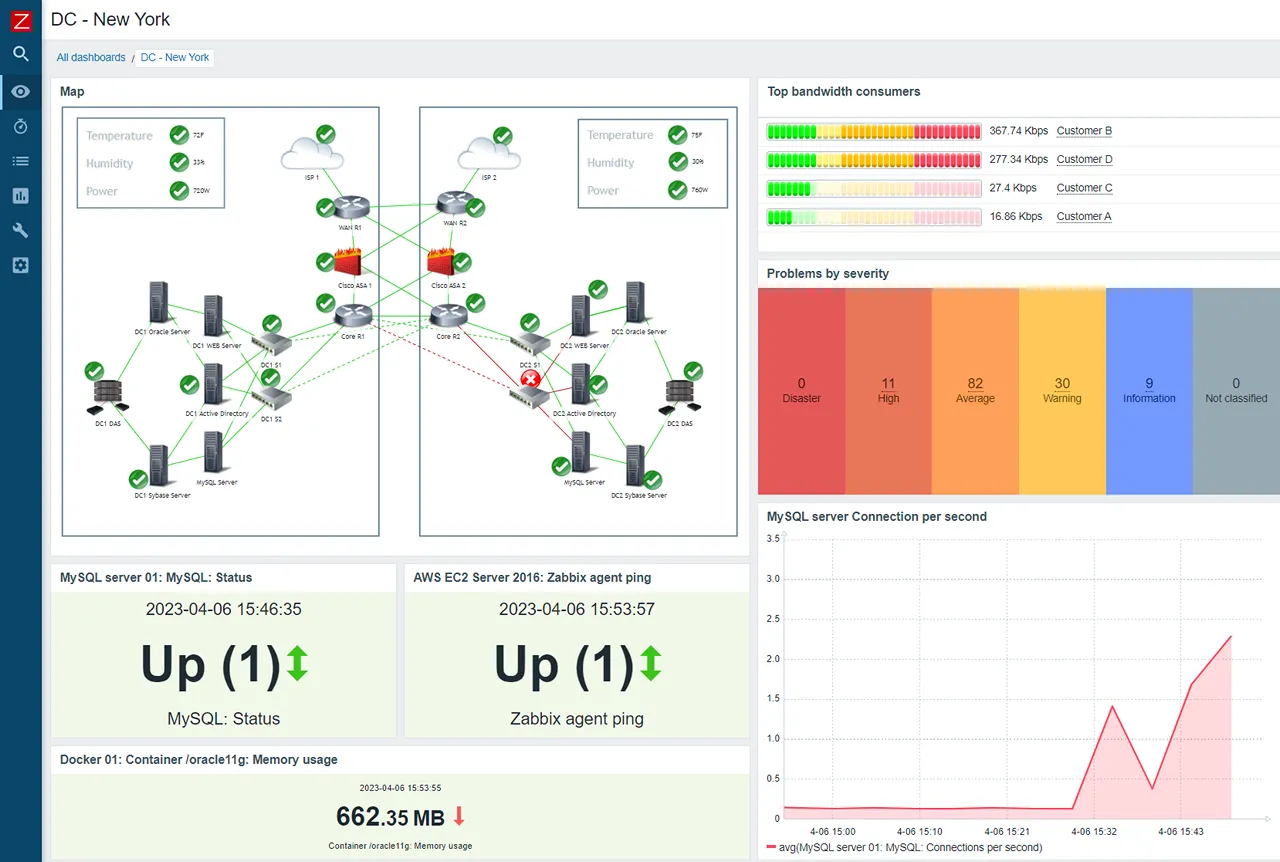
O Zabbix é o concorrente mais próximo do Checkmk em escopo e filosofia. É uma plataforma de monitoramento open-source completa que lida com infraestrutura, dispositivos de rede e aplicações. Como o Checkmk, está no mercado há mais de duas décadas.
Melhor para: Grandes ambientes on-prem com equipes dedicadas de monitoramento que querem controle total sem custos de licenciamento.
Prós
- Completamente open source, sem tiers limitados por recurso.
- Suporta monitoramento baseado em agente, SNMP, JMX e IPMI.
- Forte sistema de templates para padronizar o monitoramento entre tipos de dispositivo.
- O Zabbix Cloud oferece uma opção gerenciada.
Contras
- A configuração é verbosa (templates em XML) e a curva de aprendizado rivaliza com a do Checkmk.
- A UI melhorou, mas ainda parece utilitária.
- Suporte a cloud-native exige regras de descoberta complexas.
Preço: Grátis para self-host. O Zabbix Cloud começa em $50/mês.
Se você está avaliando outras ferramentas tradicionais de monitoramento de infraestrutura, nossa comparação do Zabbix cobre os tradeoffs em mais detalhes.
3. Prometheus e Grafana
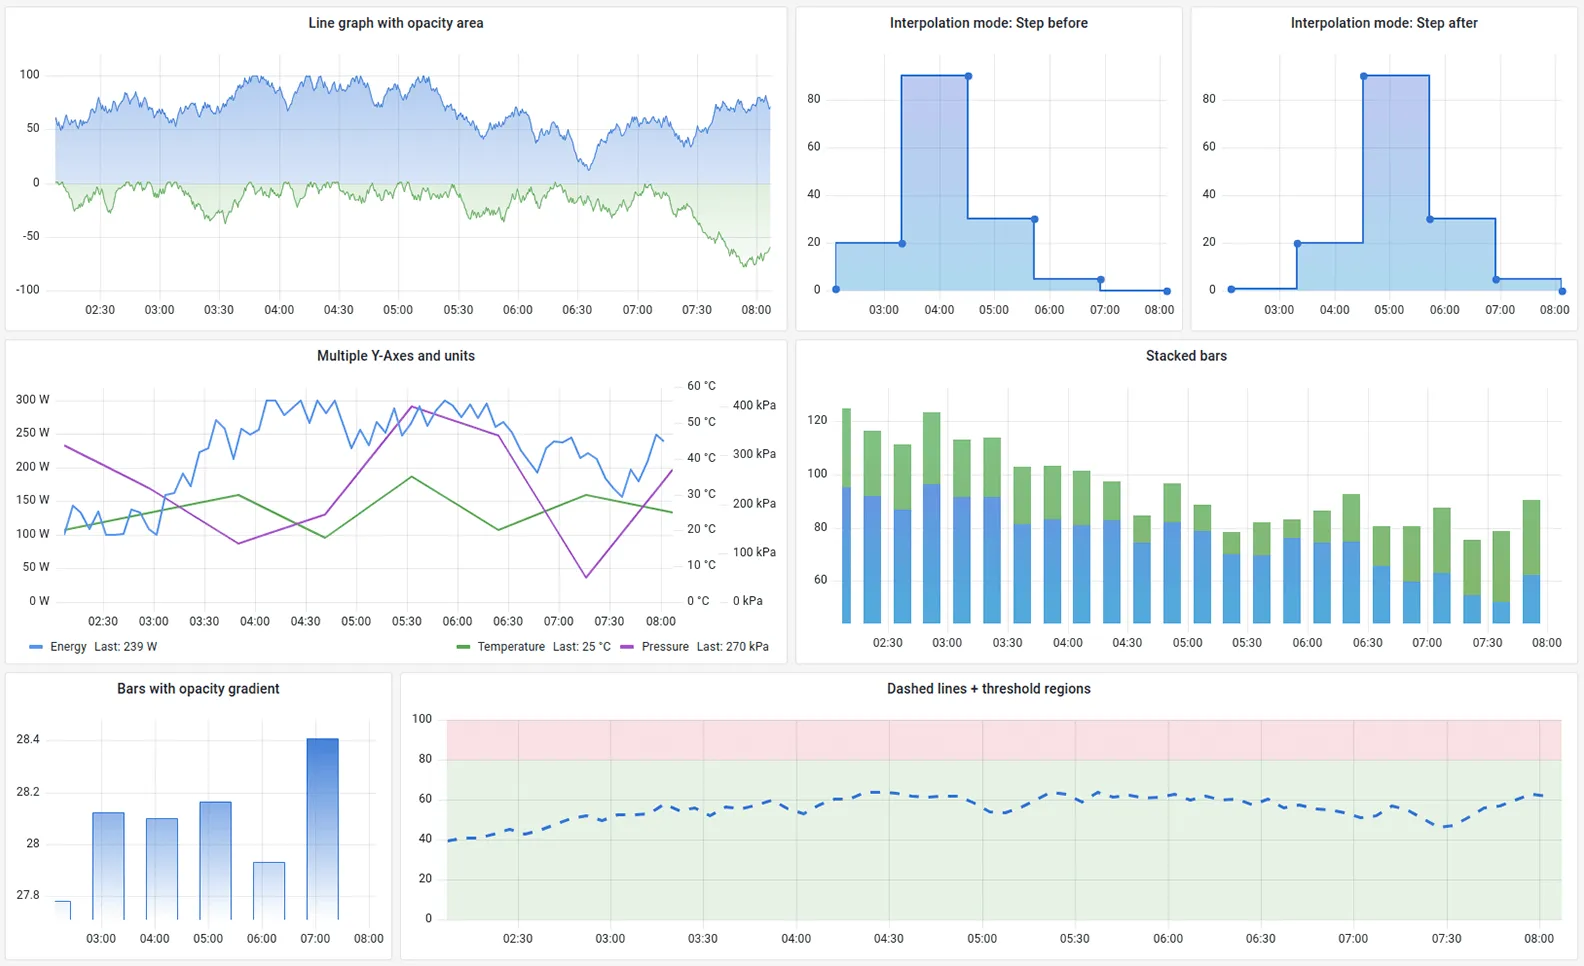
Prometheus combinado com Grafana é o padrão da indústria para monitoramento cloud-native. Enquanto o Checkmk cresceu no mundo do Nagios (checks de estado, hierarquia host/serviço), o Prometheus foi construído para ambientes dinâmicos e containerizados onde hosts aparecem e somem.
Melhor para: Clusters Kubernetes, equipes de platform engineering e organizações com recursos SRE.
Prós
- PromQL é muito mais expressivo que o alerta baseado em thresholds do Checkmk.
- Service discovery nativo para Kubernetes, AWS e outros ambientes dinâmicos.
- Ecossistema gigantesco de exporters.
- Grafana fornece visualização de primeira linha.
Contras
- Você está gerenciando uma stack (Prometheus, Grafana, Alertmanager, frequentemente Thanos), não um único produto.
- Sem gestão de logs embutida.
- PromQL tem uma curva de aprendizado íngreme.
Preço: Grátis (open source). Opções gerenciadas como Grafana Cloud são baseadas em uso.
4. Netdata
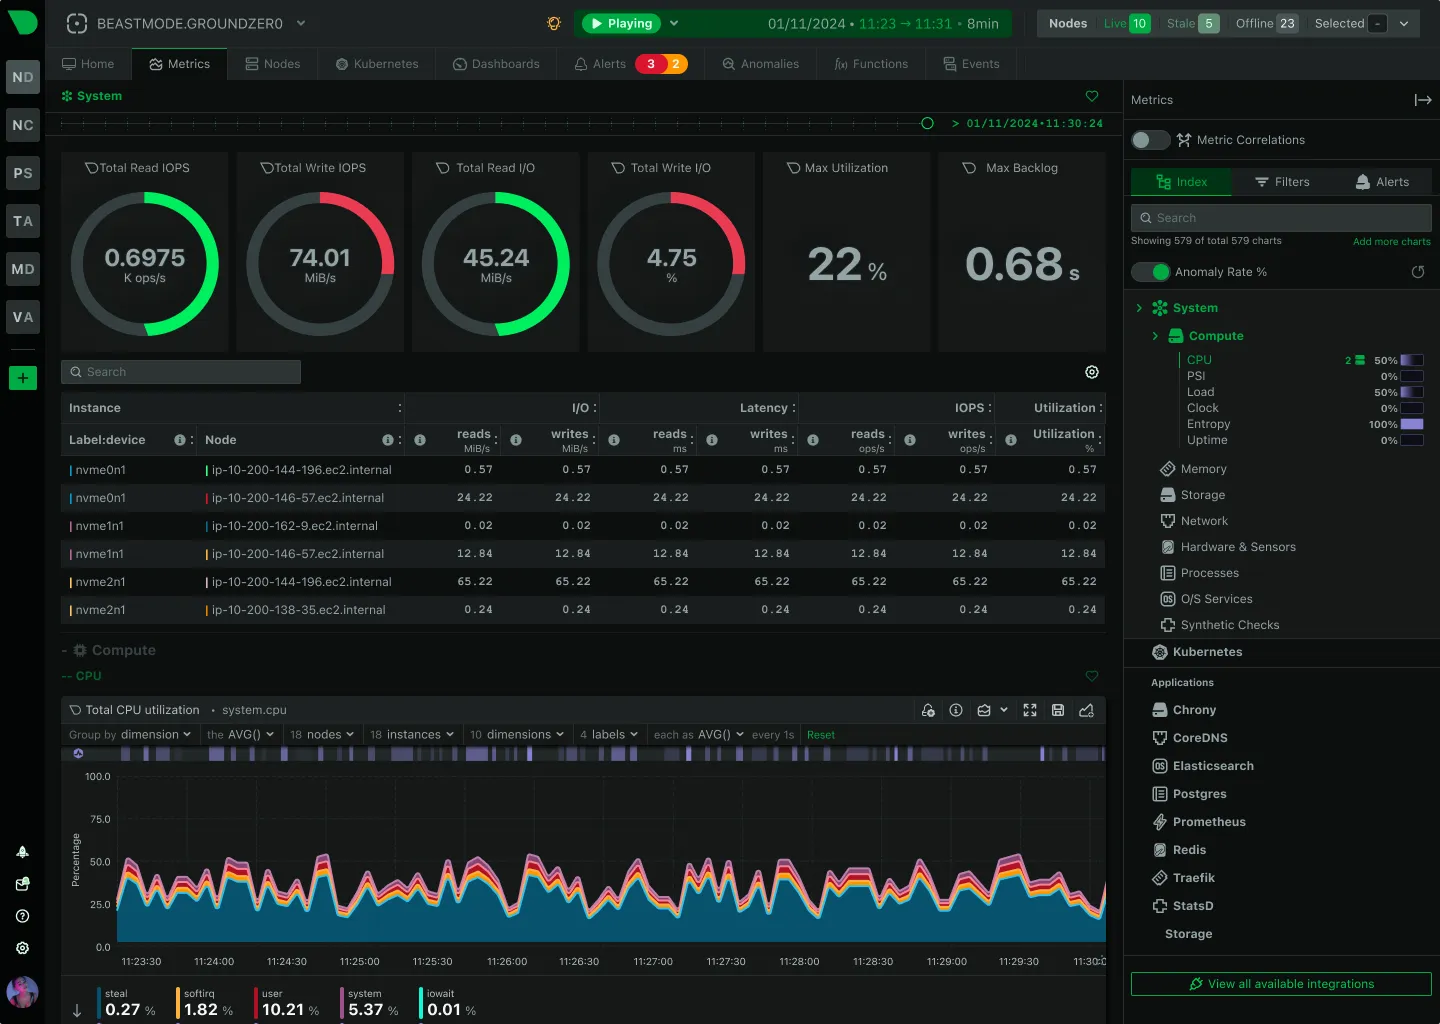
O Netdata faz o caminho oposto do Checkmk. Em vez de exigir configuração extensa antes de ver dados, ele detecta tudo no host automaticamente e começa a coletar métricas imediatamente com granularidade por segundo.
Melhor para: Equipes que querem visibilidade instantânea e de alta resolução de servidores individuais sem sobrecarga de configuração.
Prós
- Instale o agente e receba imediatamente centenas de gráficos (CPU, memória, disco, rede, aplicações).
- Detecção de anomalias embutida usando ML não supervisionado.
- O dashboard em tempo real é impressionante para troubleshooting de nó único.
Contras
- Agregação de frota é mais complexa que ferramentas centralizadas.
- Maior uso de recursos por nó por causa do ML on-host e processamento de dados de alta resolução.
- Suporte a logs ainda está amadurecendo.
Preço: Grátis para até 5 nós. Planos Business começam em torno de $4,50/nó/mês.
Para um olhar mais profundo nos tradeoffs do Netdata, confira nossa comparação de stack de monitoramento moderno.
5. SigNoz
O SigNoz é uma plataforma de observabilidade open-source construída sobre OpenTelemetry e ClickHouse. Unifica métricas, logs e traces numa única UI, algo que o Checkmk nem tenta.
Melhor para: Equipes que querem uma alternativa open-source self-hosted ao Datadog com observabilidade full-stack.
Prós
- Métricas, logs e traces distribuídos num só lugar.
- Nativo em OpenTelemetry com amplo suporte a linguagens e frameworks.
- Backend ClickHouse fornece queries rápidas em escala.
- Opção de Cloud disponível.
Contras
- Projeto mais novo com comunidade menor que Checkmk, Zabbix ou Prometheus.
- Self-hosting significa gerenciar ClickHouse, o que adiciona sua própria complexidade.
- Menos maduro para monitoramento de infraestrutura tradicional (SNMP, dispositivos de rede).
Preço: Self-hosted é grátis. SigNoz Cloud começa em $49/mês (baseado em uso).
6. ManageEngine OpManager
O ManageEngine OpManager é uma plataforma de monitoramento comercial popular em ambientes pesados em Windows e focados em rede. Enquanto o Checkmk pende para Linux e infraestrutura mista, o OpManager se sente mais em casa em departamentos de TI enterprise que rodam stacks da Microsoft.
Melhor para: Departamentos de TI com ambientes pesados em Windows/Active Directory e necessidades de monitoramento de rede.
Prós
- Boa auto-discovery para dispositivos de rede e servidores Windows.
- Análise de fluxo embutida (NetFlow, sFlow, jFlow) para tráfego de rede.
- Opção de licenciamento perpétuo disponível.
Contras
- A interface pode parecer congestionada e pesada para enterprise.
- Monitoramento cloud-native e de containers não é seu forte.
- Licenciamento por dispositivo escala rapidamente para ambientes maiores.
Preço: Grátis para até 3 dispositivos. Standard Edition começa em $245/ano para 25 dispositivos.
7. Atera
A Atera é uma plataforma de gestão de TI que combina monitoramento remoto com PSA, acesso remoto e ticketing. Não é uma concorrente direta de monitoramento do Checkmk, mas atende um público similar: equipes de TI gerenciando frotas de servidores e workstations.
Melhor para: MSPs e departamentos de TI que querem monitoramento, ticketing e acesso remoto numa única assinatura.
Prós
- Preço por técnico com dispositivos ilimitados. Custos previsíveis independentemente do tamanho da frota.
- Combina monitoramento, patching, acesso remoto e helpdesk.
- Setup significativamente menos técnico que o Checkmk.
Contras
- Profundidade de monitoramento é rasa comparada ao Checkmk. Sem checks granulares de nível de serviço ou plugins customizados.
- Preço por técnico ($149+/mês) fica caro conforme a equipe cresce.
Preço: Planos para departamentos de TI começam em $149/técnico/mês. Planos MSP começam em $129/técnico/mês. Endpoints ilimitados incluídos.
Quando você NÃO deve sair do Checkmk
O Checkmk não é a ferramenta certa para toda equipe, mas para certos casos de uso, nada chega perto.
Infraestrutura grande e heterogênea. Se você está monitorando centenas de hosts entre bare metal, VMs, containers e equipamentos de rede, a amplitude de checks embutidos do Checkmk é difícil de superar. Substituí-lo por algo mais simples muitas vezes significa perder visibilidade de sistemas legados ou de nicho.
Customização profunda de regras. O motor de regras que frustra equipes menores é exatamente o que organizações maiores precisam. Se seu monitoramento exige tratamento complexo de exceções entre grupos de hosts, pastas e períodos de tempo, a hierarquia de regras do Checkmk é feita sob medida para isso.
Ambientes guiados por conformidade. O audit logging, acesso baseado em papéis e opções de implantação on-premises do Checkmk o tornam uma escolha sólida para indústrias reguladas.
Investimento existente. Se sua equipe passou anos construindo conhecimento de Checkmk, checks customizados e runbooks em torno do seu modelo de alerta, o custo de migração pode superar os benefícios. Não subestime o conhecimento institucional travado na sua configuração atual.
Se você está avaliando outras substituições de monitoramento legado, cobrimos o caminho de migração do Nagios separadamente.