



O NGINX atua como a “porta da frente” da sua infraestrutura, mas não vem com dashboards embutidos. Para monitorá-lo de forma eficaz, você tipicamente depende de dois sinais nativos: o módulo stub_status para métricas de saturação em tempo real, e os access logs para rastreamento de latência em nível de requisição. Este guia cobre como configurar ambos. Se você usa Apache em vez disso, confira nosso guia de monitoramento do Apache. Para uma perspectiva mais ampla, nosso guia de monitoramento de web servers cobre ambos os servidores.
O que o NGINX expõe nativamente para monitoramento
Antes de recorrer a uma ferramenta de monitoramento, você precisa entender as três superfícies principais através das quais o NGINX expõe seu estado interno. Essas superfícies diferem na granularidade, no tipo de dado que fornecem e em como são consumidas por sistemas externos.
- Status Endpoints: Fornecem contadores globais em tempo real. São atualizados na memória e extremamente leves para consultar. São melhores para rastrear a “saturação” geral da instância NGINX.
- APIs (NGINX Plus): Disponíveis apenas na versão comercial, essas APIs fornecem dados JSON de alta resolução. Permitem visibilidade por serviço, por upstream e por cache que não está disponível na versão open-source.
- Logs: É onde os dados mais granulares moram. Access logs registram cada interação entre um cliente e o NGINX, enquanto error logs registram problemas internos. Logs são a única fonte de verdade para latência em nível de requisição e códigos de status individuais.
É importante distinguir entre as duas versões do NGINX: NGINX Open Source (OSS) e NGINX Plus. Embora o NGINX OSS seja a fundação da internet, suas capacidades nativas de monitoramento são intencionalmente focadas em métricas globais. O NGINX Plus oferece significativamente mais profundidade através de sua API dinâmica, que é essencial para ambientes em grande escala que exigem telemetria precisa para centenas de serviços diferentes.
Nas seções a seguir, vamos detalhar como aproveitar essas superfícies, começando pelo onipresente módulo stub_status.
Monitorando o NGINX com stub_status
O módulo stub_status é a principal (e frequentemente única) fonte de métricas em tempo real para o NGINX Open Source. Ele fornece uma saída simples em texto puro que revela o estado interno de conexões do seu servidor.
O que é o stub_status?
O ngx_http_stub_status_module rastreia um pequeno conjunto de contadores globais que medem a carga no servidor e o estado de seus processos worker. Ele não olha para requisições individuais; em vez disso, olha para as conexões pelas quais essas requisições trafegam. Embora não ofereça métricas por virtual-host ou por rota, é vital para entender se sua instância do NGINX está ficando saturada ou se há um problema com o ciclo de vida das conexões.
Como habilitar o stub_status
Para usar o stub_status, ele precisa estar habilitado na sua configuração. A maioria das versões de NGINX gerenciadas por package manager inclui esse módulo por padrão.
Exemplo de configuração
Você deve criar um bloco location dedicado. Por segurança, é crítico restringir o acesso. Expor suas métricas de status para a internet pública é um risco de segurança, pois pode revelar padrões de tráfego a atacantes.
server {
    listen 127.0.0.1:80;
    server_name localhost;

    location /nginx_status {
        stub_status;
        allow 127.0.0.1;   # Permite acesso local
        allow ::1;         # Permite acesso local IPv6
        deny all;          # Nega todos os outros
    }
}
Esse bloco de configuração geralmente vai num arquivo separado em /etc/nginx/sites-enabled/ ou diretamente dentro do bloco http do nginx.conf.
Aplicando as mudanças
Depois de atualizar sua configuração, sempre valide a sintaxe antes de recarregar para evitar indisponibilidade:
sudo nginx -tSe o teste for bem-sucedido, recarregue o NGINX. Isso sinaliza ao processo master para iniciar novos processos worker com a nova configuração e desligar graciosamente os antigos:
sudo systemctl reload nginxTestando e entendendo a saída
Você pode verificar se o endpoint está funcionando usando curl:
curl http://127.0.0.1/nginx_statusA saída é minimalista por design:
Active connections: 291
server accepts handled requests
 16630948 16630948 31070465
Reading: 6 Writing: 179 Waiting: 106
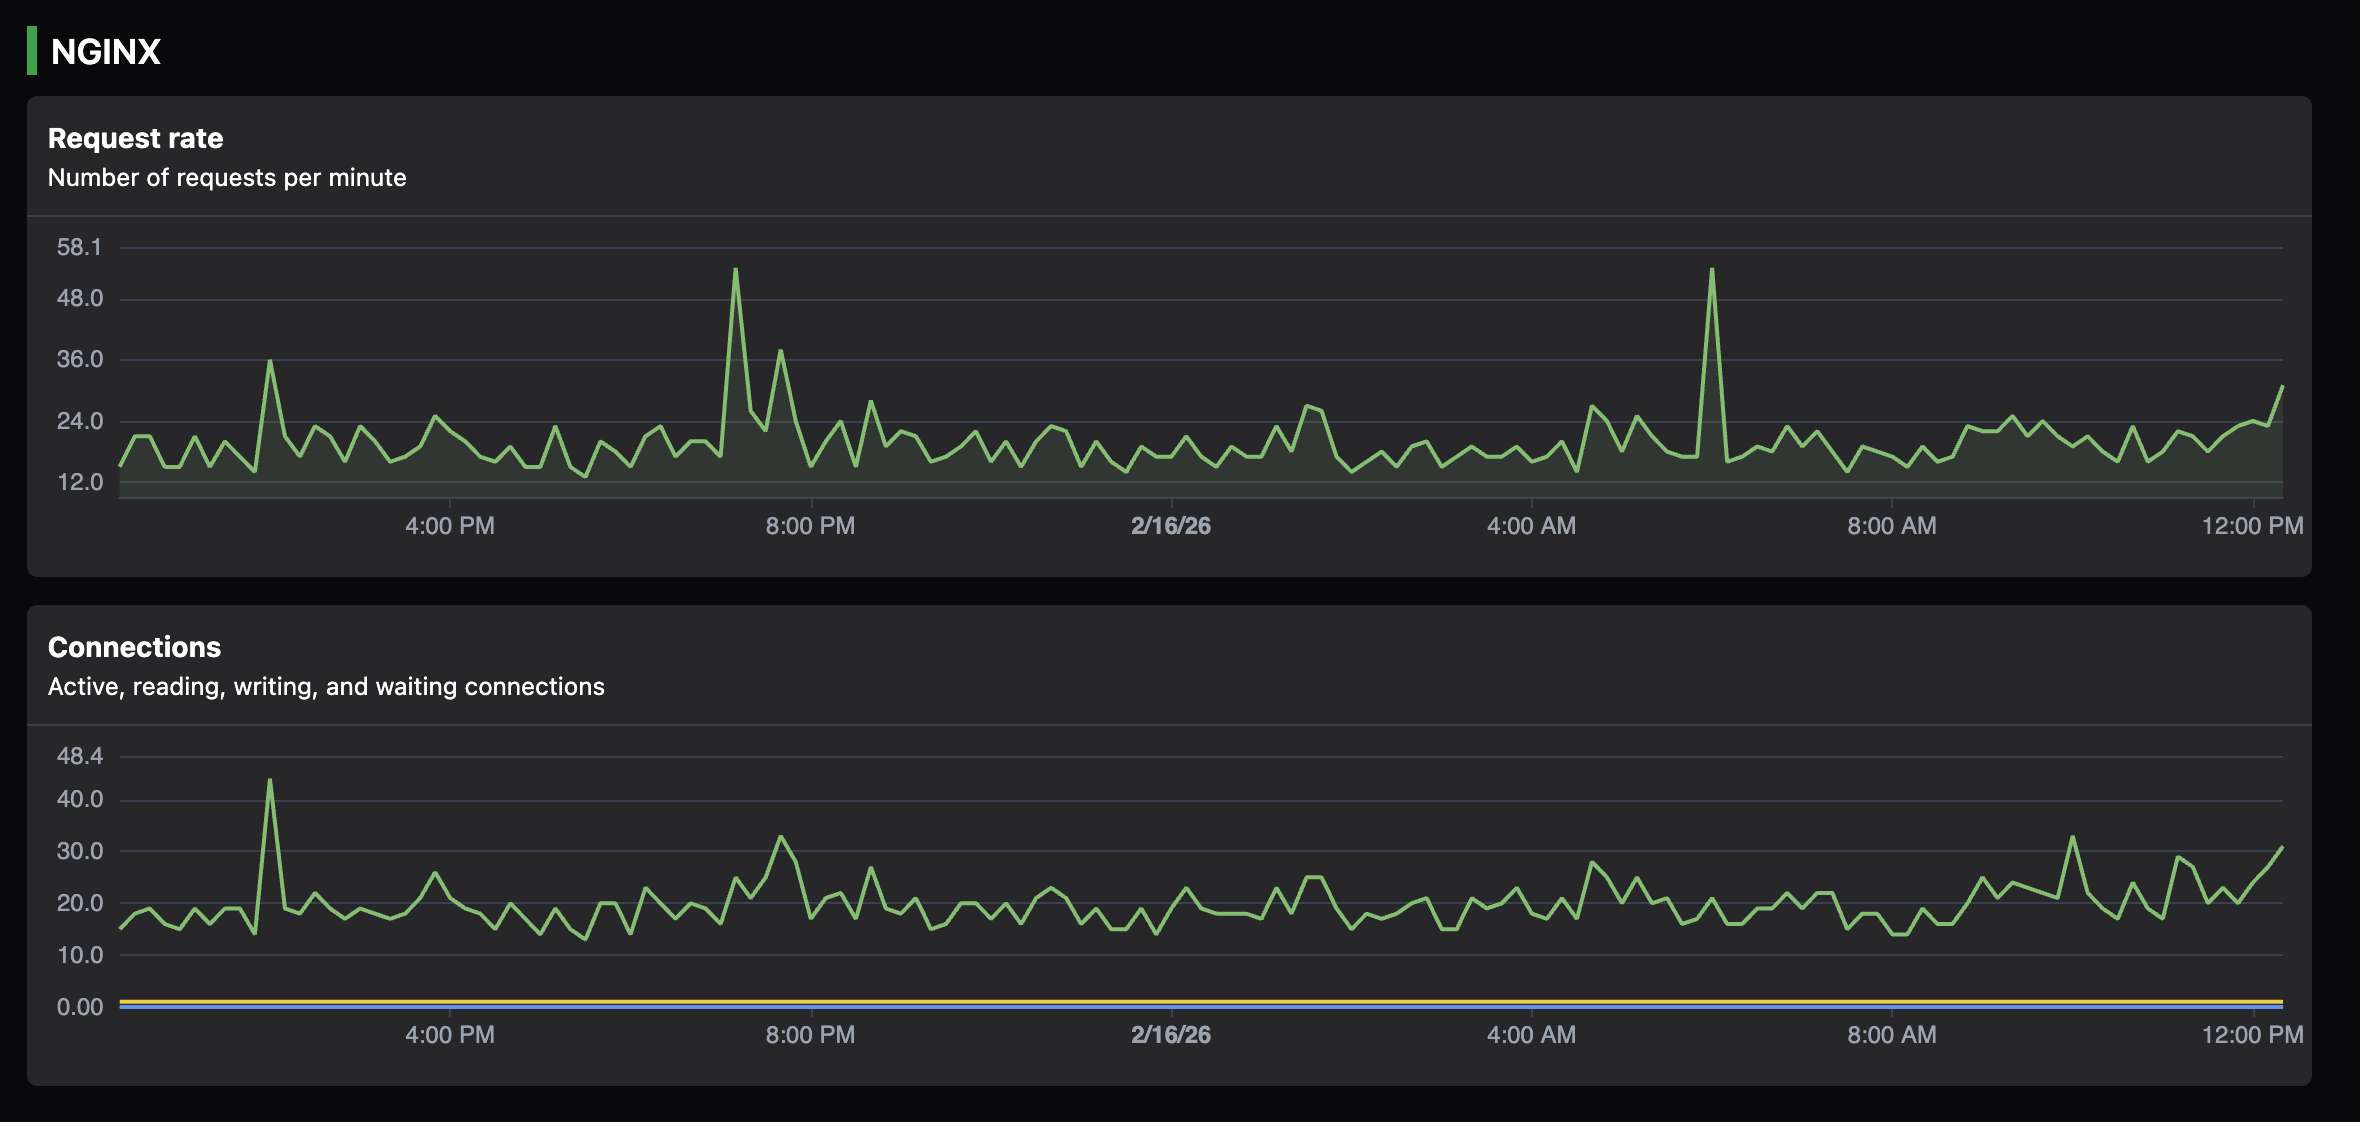
Embora esses números brutos sejam úteis para scripts, visualizá-los dá a você insight imediato nos padrões de tráfego:
O que essas métricas significam
Entender esses contadores é o primeiro passo no monitoramento do NGINX. Cada um conta uma parte específica da história:
- Active connections: O número total de conexões de cliente atualmente abertas. Isso inclui conexões que estão transmitindo dados ativamente e aquelas que estão ociosas.
- server accepts: O número total de conexões de cliente aceitas desde que o NGINX iniciou.
- handled: O número total de conexões tratadas. Num sistema saudável, isso deve ser igual a
accepts. Sehandledfor menor queaccepts, significa que o NGINX está descartando conexões, frequentemente porque atingiu o limite deworker_connections. - requests: O número total de requisições de cliente. Por causa das conexões keep-alive, uma única conexão pode servir muitas requisições. A razão entre
requestse conexõeshandledé uma boa medida da sua eficiência de keep-alive. - Reading: O NGINX está atualmente lendo o cabeçalho da requisição do cliente. Números altos aqui podem indicar clientes lentos ou potenciais ataques do tipo “Slowloris”.
- Writing: O NGINX está atualmente escrevendo a resposta de volta ao cliente. É aqui que o trabalho ativo acontece.
- Waiting: São conexões keep-alive onde o NGINX está esperando o cliente enviar outra requisição. Números altos aqui geralmente são aceitáveis, mas eles consomem memória e slots de conexão.
Limitações do stub_status
Embora o stub_status seja excelente para rastrear saturação básica, ele tem pontos cegos significativos que todo engenheiro deveria conhecer:
- Apenas contexto global: Você não consegue ver qual domínio específico (Server Name) está causando carga. Se você hospeda dez sites diferentes numa instância do NGINX, o
stub_statusagrega todos. - Sem códigos de status: Não diz se você está servindo 200 de sucesso ou falhando com 500.
- Sem insights de latência: Diz quantas requisições estão acontecendo, mas não dá nenhuma indicação de quanto tempo levam para serem processadas.
- Contadores cumulativos: São números absolutos desde que o processo iniciou. Para obter uma taxa “por segundo”, você precisa de uma ferramenta de monitoramento que colete os dados em intervalos e calcule a variação ao longo do tempo.
Monitorando com a API do NGINX Plus
Para equipes que exigem visibilidade mais profunda e podem justificar o custo, o NGINX Plus fornece uma API JSON RESTful. Isso não é apenas um upgrade do stub_status; é um nível inteiramente diferente de telemetria.
A API do NGINX Plus fornece dados em tempo real para:
- HTTP upstreams: Veja exatamente qual servidor de backend está lento ou falhando.
- Server zones: Obtenha estatísticas de tráfego e erro para cada bloco
serverindividual. - Caches: Monitore taxas de acerto de cache e capacidade.
- Resolvers: Verifique a saúde e a latência da resolução de DNS.
Explicitamente, esta API não está disponível no NGINX open-source. Exige uma licença comercial da F5. Por ser um recurso especializado, muitas ferramentas de monitoramento de propósito geral, incluindo a Simple Observability, não a suportam. Em vez disso, elas focam em extrair insights similares dos logs, o que funciona tanto na versão OSS quanto na Plus. Se você está usando NGINX Open Source, as seções a seguir sobre logs serão seu caminho principal para visibilidade granular.
Monitorando o NGINX através de Logs
Se o stub_status é o “pulso”, os logs são a “narrativa”. São a fonte mais crítica para troubleshooting detalhado e para entender a experiência do usuário.
Access logs vs. error logs
- Access logs: Registram cada requisição. São a fonte principal para calcular latência (p99), distribuições de códigos de status e padrões de tráfego.
- Error logs: Registram problemas internos (ex.: “upstream timed out” ou “file not found”). Se uma requisição falha, o access log diz que falhou, mas o error log geralmente diz por que. Por exemplo, um access log pode mostrar um 502 Bad Gateway, mas o error log vai especificar se foi “connection refused” ou “read timeout” do upstream.
Construindo um access log amigável para monitoramento
Por padrão, o formato de log combined do NGINX é feito para humanos lerem, não para sistemas de monitoramento interpretarem. Para obter observabilidade real, você deve definir um log_format customizado que inclua métricas de performance.
log_format monitoring_format '$remote_addr - $remote_user [$time_local] '
                             '"$request" $status $body_bytes_sent '
                             '"$http_referer" "$http_user_agent" '
                             'rt=$request_time urt=$upstream_response_time';

access_log /var/log/nginx/access.log monitoring_format;
Campos-chave para observabilidade:
- $status: Essencial para calcular taxas de erro. Fique de olho em picos de 5xx (erros de servidor) ou 4xx (erros de cliente).
- $request_time: O tempo total que o NGINX gastou na requisição, medido em segundos com resolução de milissegundos. Isso começa quando o NGINX lê os primeiros bytes do cliente e termina quando os últimos bytes da resposta são enviados. Essa é sua métrica principal de “latência”.
- $upstream_response_time: O tempo que a aplicação de backend levou para responder, também em segundos com resolução de milissegundos. Isso mede desde o estabelecimento da conexão com o upstream até o recebimento do último byte da resposta. Comparando isso com
$request_time, você consegue determinar se uma lentidão está acontecendo no próprio NGINX ou no código da sua aplicação. - $body_bytes_sent: Usado para rastrear bandwidth e identificar respostas anormalmente grandes (ou pequenas).
Por que os logs são essenciais para métricas
Você não consegue obter uma métrica de latência p99 a partir de um endpoint de status. Só consegue obtê-la olhando para a distribuição dos tempos individuais de requisição nos logs. Da mesma forma, calcular uma “Taxa de Sucesso” (2xx/3xx vs. Total) exige olhar para os códigos de status. É por isso que qualquer estratégia séria de monitoramento do NGINX deve incluir análise de logs. Enquanto as métricas te dão o alerta, os logs te dão o diagnóstico.
Como as ferramentas de monitoramento coletam esses sinais
Sistemas de monitoramento geralmente usam um de três padrões conceituais para ingerir sinais do NGINX. Entender esses padrões ajuda você a escolher a ferramenta certa para sua escala e complexidade.
1. Polling (método de pull)
A ferramenta de monitoramento ou um agente (como um plugin do Telegraf ou um script customizado) faz periodicamente uma requisição HTTP para /nginx_status. Ele interpreta o texto, calcula as taxas (deltas) e envia os dados a um banco. Isso é simples e funciona bem para métricas básicas, mas é limitado pela frequência de polling.
2. Scraping (estilo Prometheus)
Um processo “exporter” fica ao lado do NGINX, converte os dados de status e log brutos num formato que o Prometheus entende (OpenMetrics) e espera que o servidor central do Prometheus o “scrape”. Esse é o padrão em ambientes Kubernetes, mas exige manter o ciclo de vida do exporter.
3. Tailing e parsing
Esse é o método mais poderoso para observabilidade de alta fidelidade. Um agente fica anexado aos arquivos de log (tailing). Toda vez que uma nova linha é escrita, o agente a interpreta em tempo real. Ele pode então agregar isso em métricas, calculando latência média, taxas de erro e contagens de requisições, sem nunca precisar de um endpoint de status HTTP. Isso fornece a visão mais granular, mas exige mais recursos de CPU para o trabalho de parsing.
Como a Simple Observability se integra com o NGINX
A Simple Observability fornece uma abordagem unificada para o monitoramento do NGINX combinando as forças dos endpoints de status e dos logs. É feita para engenheiros que querem visibilidade de nível produção sem a complexidade de configurar exporters complexos ou parsers de log manuais.
O mecanismo de integração
A Simple Observability usa uma abordagem híbrida para maximizar a visibilidade minimizando a configuração:
- Descoberta de métricas: O agente da Simple Observability procura automaticamente por um endpoint
stub_statusconfigurado emlocalhost. Uma vez encontrado, começa a fazer polling de métricas em nível de conexão (Active, Reading, Writing, etc.). - Log tailing: O agente faz tail dos diretórios padrão de log do NGINX (ex.:
/var/log/nginx/). Ele vem pré-configurado para entender formatos padrão de log do NGINX e pode ser adaptado a formatos customizados de uma linha, tornando seus logs pesquisáveis e acessíveis. - Sem exigência de NGINX Plus: A Simple Observability trabalha com os sinais disponíveis na versão open-source. Ela não usa a API do NGINX Plus, tornando-a acessível a todos os usuários.
O que isso alcança
Combinando esses dois fluxos, a Simple Observability dá a você visibilidade do seu servidor NGINX:
- O servidor está saturado? (via métricas de stub_status)
- O que está acontecendo nos meus logs? (via access e error logs pesquisáveis)
Você recebe métricas em nível de conexão e logs pesquisáveis, tudo gerenciado por um único agente leve. Isso fornece visibilidade tanto da saúde geral da sua instância do NGINX quanto a capacidade de investigar requisições específicas quando problemas surgem.
Melhores práticas de monitoramento do NGINX
Para tirar o máximo do seu setup de monitoramento, mantenha esses três princípios em mente:
- Isole seu endpoint de status: Nunca escute em interfaces públicas. Use
127.0.0.1e restrinja o acesso via diretivasallow/deny. Dados de monitoramento são informações sensíveis sobre seu tráfego. - Monitore tanto o NGINX quanto o backend: Sempre inclua
$upstream_response_timenos seus logs. Se você monitora apenas a latência do NGINX, não vai saber se o problema é a configuração do NGINX ou uma query de banco lenta na sua aplicação. - Alerte sobre saturação e erros, não apenas “up/down”: Um processo NGINX rodando que está descartando 50% de suas conexões está efetivamente fora do ar, mesmo que o processo esteja “running”. Configure alertas sobre sua razão
handled/acceptse sua taxa de erros 5xx. - Use keep-alive: Monitore a razão entre
requestse conexõeshandled. Se estiver perto de 1:1, você não está se beneficiando do keep-alive, o que aumenta a latência para seus usuários.
Conclusão
O NGINX expõe sinais nativos limitados, mas extremamente úteis. Ao habilitar o stub_status e configurar adequadamente seus access logs, você desbloqueia os sinais principais necessários para entender throughput, latência e erros.
Monitoramento eficaz é a chave para manter uma infraestrutura web de alta performance. Ele faz a ponte entre dados brutos e insights acionáveis, permitindo que você detecte problemas antes que afetem seus usuários. Esteja você usando um setup manual ou uma ferramenta unificada como a Simple Observability, o objetivo é o mesmo: visibilidade do caminho crítico do seu tráfego.
Monitoramento não deveria ser uma reflexão tardia; deveria ser embutido na sua configuração desde o primeiro dia. Com os sinais certos, o NGINX se torna mais do que apenas um proxy - ele se torna sua ferramenta mais poderosa para excelência operacional.