



NGINX fungiert als “Eingangstür” Ihrer Infrastruktur, kommt aber nicht mit eingebauten Dashboards. Um es effektiv zu überwachen, stützen Sie sich typischerweise auf zwei native Signale: das stub_status-Modul für Echtzeit-Sättigungsmetriken und Access-Logs für latenzbezogenes Tracking auf Anforderungsebene. Dieser Leitfaden behandelt die Konfiguration beider. Wenn Sie stattdessen Apache betreiben, siehe unseren Apache-Monitoring-Leitfaden. Für eine breitere Perspektive behandelt unser Leitfaden zum Webserver-Monitoring beide Server.
Was NGINX nativ für das Monitoring bereitstellt
Bevor Sie zu einem Monitoring-Tool greifen, müssen Sie die drei primären Oberflächen verstehen, über die NGINX seinen internen Zustand offenlegt. Diese Oberflächen unterscheiden sich in ihrer Granularität, der Art der Daten, die sie liefern, und wie sie von externen Systemen genutzt werden.
- Status-Endpunkte: Diese liefern Echtzeit-Globalzähler. Sie werden im Speicher aktualisiert und sind extrem ressourcenschonend abzufragen. Sie eignen sich am besten zur Überwachung der allgemeinen “Sättigung” der NGINX-Instanz.
- APIs (NGINX Plus): Nur in der kommerziellen Version verfügbar, bieten diese APIs hochaufgelöste JSON-Daten. Sie ermöglichen Pro-Service-, Pro-Upstream- und Pro-Cache-Transparenz, die in der Open-Source-Version nicht verfügbar ist.
- Logs: Hier liegen die granularsten Daten. Access-Logs zeichnen jede einzelne Interaktion zwischen einem Client und NGINX auf, während Error-Logs interne Probleme protokollieren. Logs sind die einzige Wahrheitsquelle für Latenz auf Anforderungsebene und individuelle Status-Codes.
Es ist wichtig, zwischen den beiden Versionen von NGINX zu unterscheiden: NGINX Open Source (OSS) und NGINX Plus. Während NGINX OSS das Fundament des Internets bildet, sind seine nativen Monitoring-Fähigkeiten bewusst auf globale Metriken fokussiert. NGINX Plus bietet deutlich mehr Tiefe über seine dynamische API, die für groß angelegte Umgebungen unerlässlich ist, die präzise Telemetrie für Hunderte verschiedener Dienste benötigen.
In den folgenden Abschnitten gehen wir tiefer darauf ein, wie Sie diese Oberflächen nutzen, beginnend mit dem allgegenwärtigen stub_status-Modul.
NGINX mit stub_status überwachen
Das stub_status-Modul ist die primäre (und oft einzige) Quelle für Echtzeit-Metriken bei NGINX Open Source. Es liefert eine einfache Klartextausgabe, die den internen Verbindungszustand Ihres Servers offenlegt.
Was ist stub_status?
Das ngx_http_stub_status_module verfolgt eine kleine Menge von Globalzählern, die die Last auf dem Server und den Zustand seiner Worker-Prozesse messen. Es betrachtet keine einzelnen Anforderungen, sondern die Verbindungen, über die diese Anforderungen laufen. Es bietet zwar keine Pro-Virtual-Host- oder Pro-Route-Metriken, ist aber entscheidend, um zu verstehen, ob Ihre NGINX-Instanz gesättigt wird oder ob es ein Problem mit dem Verbindungs-Lebenszyklus gibt.
So aktivieren Sie stub_status
Um stub_status zu verwenden, muss es in Ihrer Konfiguration aktiviert sein. Die meisten paketverwalteten NGINX-Versionen enthalten dieses Modul standardmäßig.
Konfigurationsbeispiel
Sie sollten einen dedizierten location-Block erstellen. Aus Sicherheitsgründen ist es entscheidend, den Zugriff einzuschränken. Ihre Status-Metriken öffentlich im Internet preiszugeben ist ein Sicherheitsrisiko, da es Angreifern Traffic-Muster verrät.
server {
    listen 127.0.0.1:80;
    server_name localhost;

    location /nginx_status {
        stub_status;
        allow 127.0.0.1;   # Allow local access
        allow ::1;         # Allow local IPv6 access
        deny all;          # Deny everyone else
    }
}
Dieser Konfigurationsblock gehört normalerweise in eine separate Datei in /etc/nginx/sites-enabled/ oder direkt in den http-Block der nginx.conf.
Änderungen anwenden
Nach dem Aktualisieren Ihrer Konfiguration sollten Sie die Syntax immer vor dem Neuladen validieren, um Ausfallzeiten zu vermeiden:
sudo nginx -tWenn der Test erfolgreich ist, laden Sie NGINX neu. Das signalisiert dem Master-Prozess, neue Worker-Prozesse mit der neuen Konfiguration zu starten und alte ordnungsgemäß herunterzufahren:
sudo systemctl reload nginxTesten und Verstehen der Ausgabe
Sie können überprüfen, ob der Endpunkt funktioniert, mit curl:
curl http://127.0.0.1/nginx_statusDie Ausgabe ist bewusst minimalistisch:
Active connections: 291
server accepts handled requests
 16630948 16630948 31070465
Reading: 6 Writing: 179 Waiting: 106
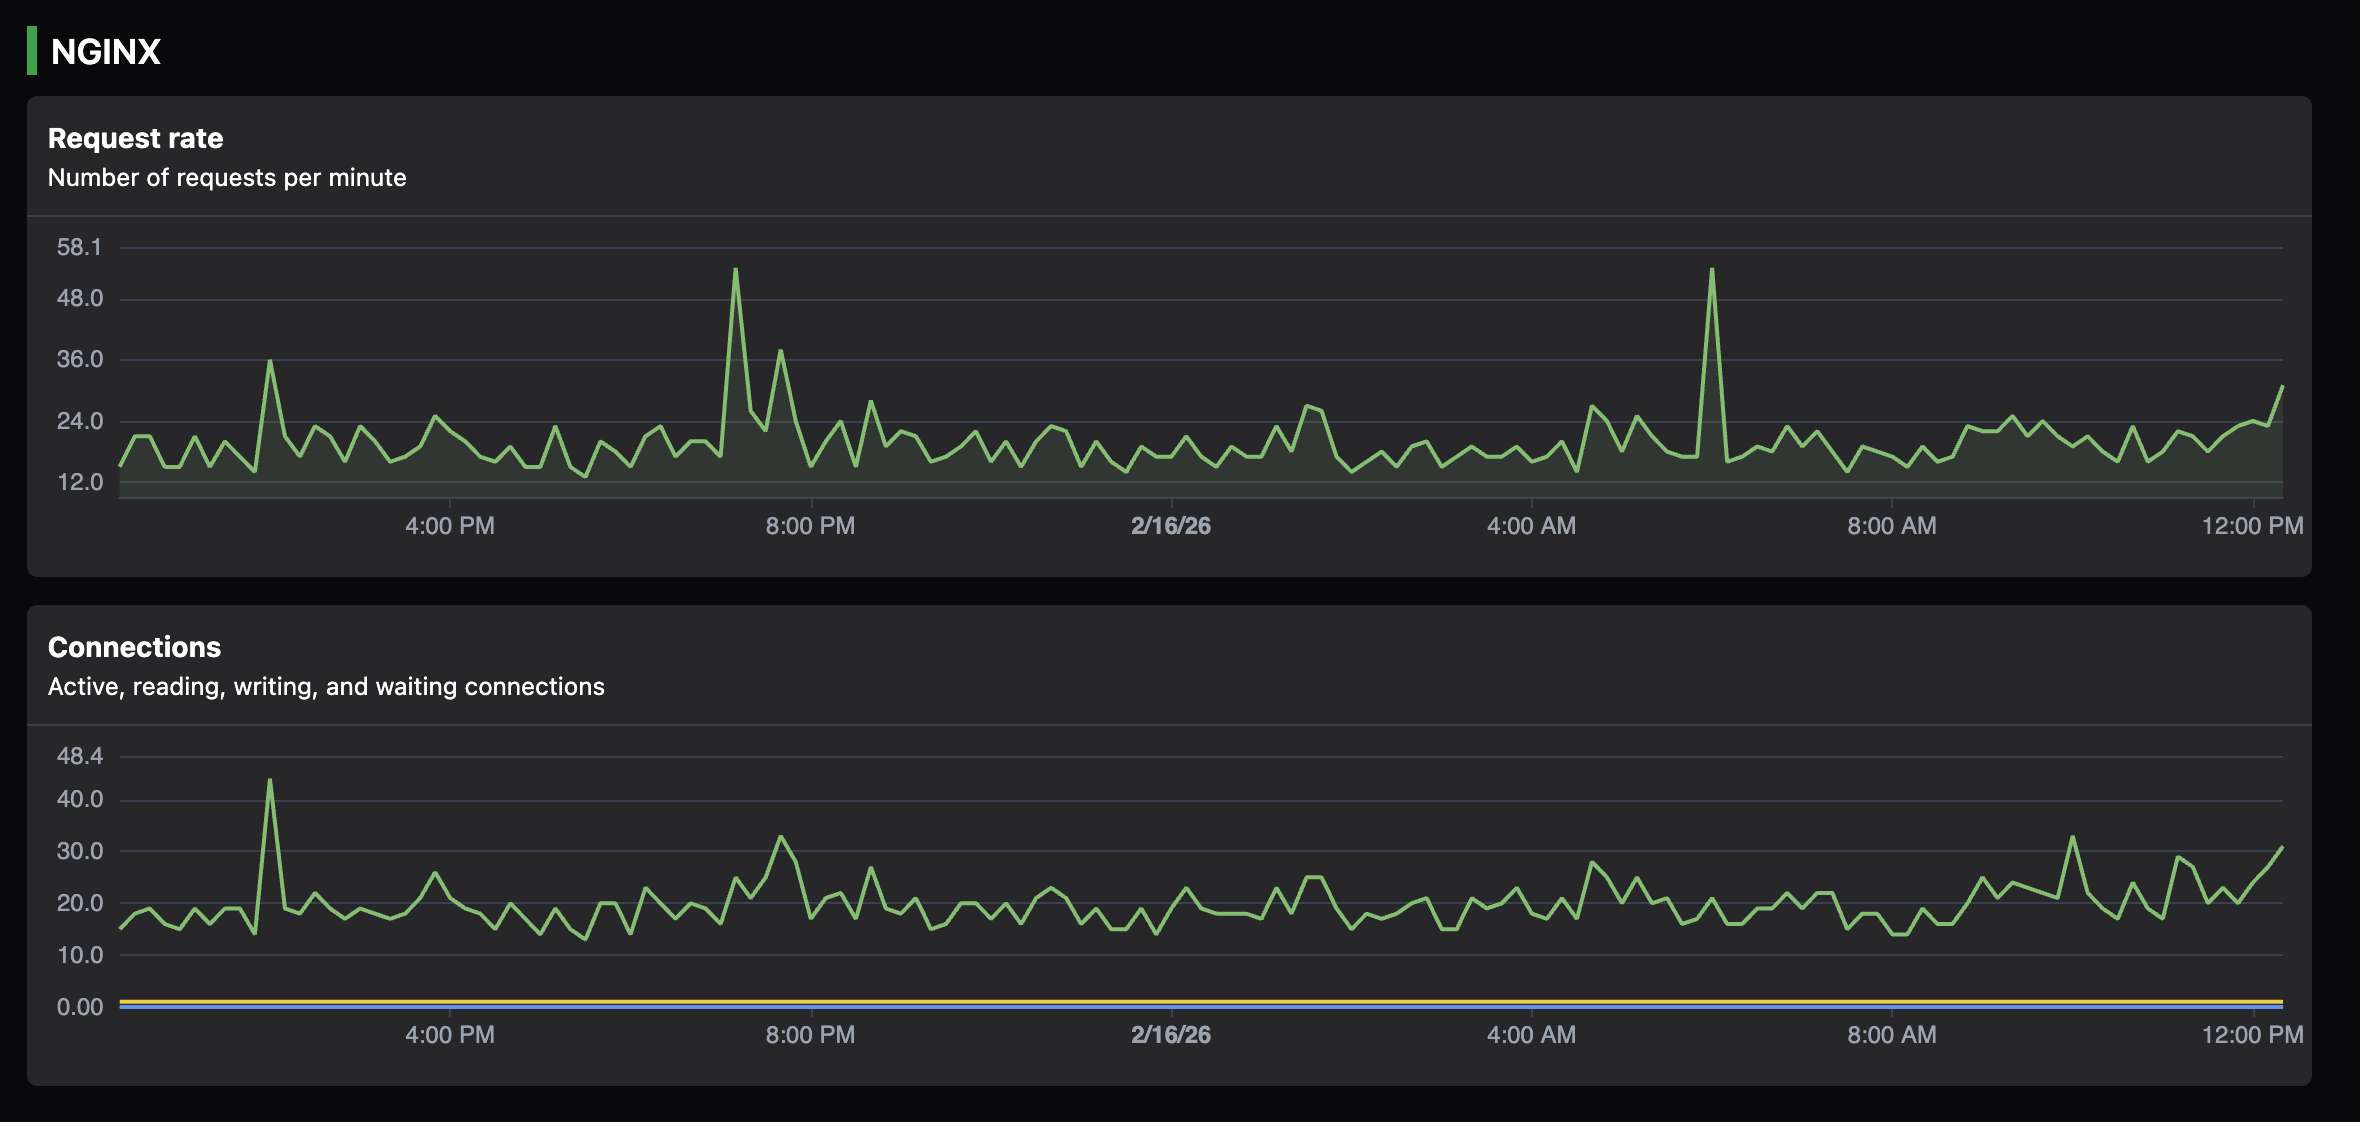
Während diese Rohwerte für Skripte nützlich sind, gibt Ihnen die Visualisierung unmittelbaren Einblick in Traffic-Muster:
Was diese Metriken bedeuten
Das Verstehen dieser Zähler ist der erste Schritt im NGINX-Monitoring. Jeder erzählt einen bestimmten Teil der Geschichte:
- Active connections: Die Gesamtzahl der aktuell offenen Client-Verbindungen. Dies umfasst Verbindungen, die aktiv Daten übertragen, und solche, die leer sind.
- server accepts: Die Gesamtzahl der akzeptierten Client-Verbindungen seit dem Start von NGINX.
- handled: Die Gesamtzahl der behandelten Verbindungen. In einem gesunden System sollte dies gleich
acceptssein. Wennhandledniedriger ist alsaccepts, bedeutet das, dass NGINX Verbindungen verwirft, oft weil dasworker_connections-Limit erreicht wurde. - requests: Die Gesamtzahl der Client-Anforderungen. Wegen Keep-Alive-Verbindungen kann eine einzelne Verbindung viele Anforderungen bedienen. Das Verhältnis von
requestszuhandled-Verbindungen ist ein gutes Maß für Ihre Keep-Alive-Effizienz. - Reading: NGINX liest gerade den Anforderungs-Header vom Client. Hohe Zahlen hier können auf langsame Clients oder potenzielle “Slowloris”-Angriffe hindeuten.
- Writing: NGINX schreibt gerade die Antwort an den Client zurück. Hier passiert die aktive Arbeit.
- Waiting: Dies sind Keep-Alive-Verbindungen, in denen NGINX darauf wartet, dass der Client eine weitere Anforderung sendet. Hohe Zahlen hier sind im Allgemeinen in Ordnung, sie verbrauchen jedoch Speicher und Verbindungs-Slots.
Einschränkungen von stub_status
Während stub_status hervorragend für das Tracking grundlegender Sättigung geeignet ist, hat es erhebliche blinde Flecken, deren sich jeder Engineer bewusst sein sollte:
- Nur globaler Kontext: Sie können nicht sehen, welche spezifische Domain (Server Name) die Last verursacht. Wenn Sie zehn verschiedene Sites auf einer NGINX-Instanz hosten, fasst
stub_statusalle zusammen. - Keine Status-Codes: Es sagt Ihnen nicht, ob Sie erfolgreiche 200er oder fehlerhafte 500er ausliefern.
- Keine Latenz-Einblicke: Es sagt Ihnen, wie viele Anforderungen passieren, aber gibt keinen Hinweis darauf, wie lange ihre Verarbeitung dauert.
- Kumulative Zähler: Dies sind absolute Zahlen seit Prozessstart. Um eine “pro Sekunde”-Rate zu erhalten, benötigen Sie ein Monitoring-Tool, das die Daten in Intervallen abruft und die Änderung über Zeit berechnet.
Überwachung über die NGINX Plus API
Für Teams, die tiefere Transparenz benötigen und die Kosten rechtfertigen können, bietet NGINX Plus eine RESTful JSON-API. Das ist kein bloßes Upgrade von stub_status, sondern eine völlig andere Ebene der Telemetrie.
Die NGINX Plus-API liefert Echtzeitdaten für:
- HTTP-Upstreams: Sehen Sie genau, welcher Backend-Server langsam ist oder ausfällt.
- Server-Zonen: Erhalten Sie Traffic- und Fehlerstatistiken für jeden einzelnen
server-Block. - Caches: Überwachen Sie Cache-Hit-Raten und Kapazität.
- Resolver: Prüfen Sie Gesundheit und Latenz der DNS-Auflösung.
Ausdrücklich: Diese API ist in Open-Source-NGINX nicht verfügbar. Sie erfordert eine kommerzielle Lizenz von F5. Da es sich um eine spezialisierte Funktion handelt, unterstützen viele allgemeine Monitoring-Tools, einschließlich Simple Observability, sie nicht. Stattdessen konzentrieren sie sich darauf, ähnliche Erkenntnisse aus Logs zu extrahieren, was sowohl bei OSS als auch bei Plus funktioniert. Wenn Sie Open-Source-NGINX verwenden, sind die folgenden Abschnitte über Logs Ihr primärer Weg zu granularer Transparenz.
NGINX über Logs überwachen
Wenn stub_status der “Puls” ist, dann sind Logs die “Erzählung”. Sie sind die kritischste Quelle für detaillierte Fehlersuche und das Verständnis der Nutzererfahrung.
Access-Logs vs. Error-Logs
- Access-Logs: Diese zeichnen jede Anforderung auf. Sie sind die primäre Quelle für die Berechnung von Latenz (p99), Status-Code-Verteilungen und Traffic-Mustern.
- Error-Logs: Diese zeichnen interne Probleme auf (z. B. “upstream timed out” oder “file not found”). Wenn eine Anforderung fehlschlägt, sagt Ihnen das Access-Log, dass sie fehlgeschlagen ist, aber das Error-Log sagt Ihnen meistens, warum. Zum Beispiel könnte ein Access-Log einen 502 Bad Gateway zeigen, aber das Error-Log spezifiziert, ob es sich um “connection refused” oder ein “read timeout” vom Upstream handelte.
Aufbau eines monitoring-freundlichen Access-Logs
Standardmäßig ist das NGINX combined-Log-Format für Menschen zum Lesen gedacht, nicht für Monitoring-Systeme zum Parsen. Für echte Observability sollten Sie ein benutzerdefiniertes log_format definieren, das Performance-Metriken enthält.
log_format monitoring_format '$remote_addr - $remote_user [$time_local] '
                             '"$request" $status $body_bytes_sent '
                             '"$http_referer" "$http_user_agent" '
                             'rt=$request_time urt=$upstream_response_time';

access_log /var/log/nginx/access.log monitoring_format;
Wichtige Felder für Observability:
- $status: Essentiell für die Berechnung von Fehlerraten. Achtenen Sie auf Spitzen bei 5xx (Serverfehler) oder 4xx (Clientfehler).
- $request_time: Die Gesamtzeit, die NGINX für die Anforderung benötigt hat, gemessen in Sekunden mit Millisekundenauflösung. Dies beginnt, wenn NGINX die ersten Bytes vom Client liest, und endet, wenn die letzten Bytes der Antwort gesendet wurden. Dies ist Ihre primäre “Latenz”-Metrik.
- $upstream_response_time: Die Zeit, die die Backend-Anwendung zur Antwort benötigte, ebenfalls in Sekunden mit Millisekundenauflösung. Dies misst vom Aufbau der Upstream-Verbindung bis zum Empfang des letzten Bytes der Antwort. Wenn Sie dies mit
$request_timevergleichen, können Sie feststellen, ob eine Verlangsamung in NGINX selbst oder in Ihrem Anwendungscode passiert. - $body_bytes_sent: Verwendet, um Bandbreite zu verfolgen und ungewöhnlich große (oder kleine) Antworten zu identifizieren.
Warum Logs für Metriken essenziell sind
Sie können keine p99-Latenzmetrik von einem Status-Endpunkt erhalten. Sie erhalten sie nur, indem Sie die Verteilung individueller Anforderungszeiten in den Logs betrachten. Ebenso erfordert die Berechnung einer “Erfolgsrate” (2xx/3xx vs. Gesamt) das Betrachten von Status-Codes. Deshalb muss jede ernsthafte NGINX-Monitoring-Strategie Log-Analyse umfassen. Während Metriken Ihnen das Alert geben, liefern Logs die Diagnose.
Wie Monitoring-Tools diese Signale erfassen
Monitoring-Systeme nutzen im Allgemeinen eines von drei konzeptionellen Mustern, um NGINX-Signale zu erfassen. Das Verstehen dieser Muster hilft Ihnen bei der Wahl des richtigen Tools für Ihre Skalierung und Komplexität.
1. Polling (Pull-Methode)
Das Monitoring-Tool oder ein Agent (wie ein Telegraf-Plugin oder ein Custom-Skript) macht periodisch eine HTTP-Anforderung an /nginx_status. Es parst den Text, berechnet die Raten (Deltas) und sendet die Daten an eine Datenbank. Das ist einfach und funktioniert gut für grundlegende Metriken, ist aber durch die Polling-Frequenz limitiert.
2. Scraping (Prometheus-Stil)
Ein “Exporter”-Prozess sitzt neben NGINX, konvertiert die rohen Status- und Log-Daten in ein Format, das Prometheus versteht (OpenMetrics), und wartet darauf, dass der zentrale Prometheus-Server ihn “scrappt”. Das ist der Standard in Kubernetes-Umgebungen, erfordert aber das Verwalten des Exporter-Lebenszyklus.
3. Tailing und Parsen
Das ist die leistungsstärkste Methode für hochauflösende Observability. Ein Agent bleibt an den Log-Dateien hängen (Tailing). Jedes Mal, wenn eine neue Zeile geschrieben wird, parst der Agent sie in Echtzeit. Er kann diese dann zu Metriken aggregieren, durchschnittliche Latenz, Fehlerraten und Anforderungszahlen berechnen, ohne jemals einen HTTP-Status-Endpunkt zu benötigen. Das bietet die granularste Sicht, erfordert aber mehr CPU-Ressourcen für die Parsing-Arbeit.
Wie Simple Observability mit NGINX integriert
Simple Observability bietet einen einheitlichen Ansatz für das NGINX-Monitoring, indem es die Stärken von Status-Endpunkten und Logs kombiniert. Es wurde für Engineers entwickelt, die produktionsgerechte Transparenz ohne die Komplexität wünschen, komplexe Exporter oder manuelle Log-Parser einzurichten.
Der Integrationsmechanismus
Simple Observability nutzt einen hybriden Ansatz, um die Transparenz zu maximieren und die Konfiguration zu minimieren:
- Metrik-Discovery: Der Simple Observability-Agent sucht automatisch nach einem konfigurierten
stub_status-Endpunkt auflocalhost. Sobald gefunden, beginnt er mit dem Polling von verbindungsbezogenen Metriken (Active, Reading, Writing etc.). - Log-Tailing: Der Agent verfolgt die Standard-NGINX-Log-Verzeichnisse (z. B.
/var/log/nginx/). Er ist vorkonfiguriert, Standard-NGINX-Log-Formate zu verstehen, und kann an einzeilige Custom-Formate angepasst werden, wodurch Ihre Logs durchsuchbar und zugänglich werden. - Keine NGINX-Plus-Voraussetzung: Simple Observability arbeitet mit den in der Open-Source-Version verfügbaren Signalen. Es verwendet nicht die NGINX-Plus-API, was es für alle Nutzer zugänglich macht.
Was das erreicht
Durch die Kombination dieser beiden Streams gibt Ihnen Simple Observability Transparenz über Ihren NGINX-Server:
- Ist der Server gesättigt? (über stub_status-Metriken)
- Was passiert in meinen Logs? (über durchsuchbare Access- und Error-Logs)
Sie erhalten verbindungsbezogene Metriken und durchsuchbare Logs, alles verwaltet über einen einzigen, leichtgewichtigen Agenten. Das bietet Transparenz über die allgemeine Gesundheit Ihrer NGINX-Instanz sowie die Fähigkeit, spezifische Anforderungen zu untersuchen, wenn Probleme auftreten.
NGINX-Monitoring-Best Practices
Um das Meiste aus Ihrem Monitoring-Setup herauszuholen, behalten Sie diese drei Prinzipien im Kopf:
- Isolieren Sie Ihren Status-Endpunkt: Niemals auf öffentlichen Interfaces lauschen. Verwenden Sie
127.0.0.1und beschränken Sie den Zugriff überallow/deny-Direktiven. Monitoring-Daten sind sensible Informationen über Ihren Traffic. - Überwachen Sie sowohl NGINX als auch das Backend: Nehmen Sie immer
$upstream_response_timein Ihre Logs auf. Wenn Sie nur NGINX-Latenz überwachen, wissen Sie nicht, ob das Problem die NGINX-Konfiguration oder eine langsame Datenbankabfrage in Ihrer Anwendung ist. - Alarmieren auf Sättigung und Fehler, nicht nur auf “Up/Down”: Ein laufender NGINX-Prozess, der 50 % seiner Verbindungen verwirft, ist effektiv down, selbst wenn der Prozess “läuft.” Setzen Sie Alerts auf Ihr
handled/accepts-Verhältnis und Ihre 5xx-Fehlerrate. - Verwenden Sie Keep-Alive: Überwachen Sie das Verhältnis von
requestszuhandled-Verbindungen. Wenn es nahe an 1:1 liegt, profitieren Sie nicht von Keep-Alive, was die Latenz für Ihre Nutzer erhöht.
Fazit
NGINX legt begrenzte, aber extrem nützliche native Signale offen. Durch das Aktivieren von stub_status und die ordnungsgemäße Konfiguration Ihrer Access-Logs schalten Sie die primären Signale frei, die nötig sind, um Durchsatz, Latenz und Fehler zu verstehen.
Effektives Monitoring ist der Schlüssel zur Aufrechterhaltung einer hochleistungsfähigen Web-Infrastruktur. Es schlägt die Brücke zwischen rohen Daten und verwertbaren Erkenntnissen und ermöglicht es Ihnen, Probleme zu erkennen, bevor sie Ihre Nutzer beeinträchtigen. Ob Sie ein manuelles Setup oder ein einheitliches Tool wie Simple Observability verwenden, das Ziel ist dasselbe: Transparenz über den kritischen Pfad Ihres Traffics.
Monitoring sollte kein Afterthought sein, sondern von Tag eins an in Ihre Konfiguration eingebaut werden. Mit den richtigen Signalen wird NGINX mehr als nur ein Proxy, es wird Ihr leistungsstärkstes Tool für operative Exzellenz.