



NGINX agit comme la « porte d’entrée » de votre infrastructure, mais il n’est pas livré avec des tableaux de bord intégrés. Pour le superviser efficacement, vous reposez généralement sur deux signaux natifs : le module stub_status pour les métriques de saturation en temps réel, et les journaux d’accès pour le suivi de la latence au niveau des requêtes. Ce guide explique comment configurer les deux. Si vous utilisez Apache à la place, consultez notre guide de supervision Apache. Pour une perspective plus large, notre guide de supervision des serveurs web couvre les deux serveurs.
Ce que NGINX expose nativement pour la supervision
Avant de vous tourner vers un outil de supervision, vous devez comprendre les trois surfaces principales par lesquelles NGINX expose son état interne. Ces surfaces diffèrent par leur granularité, le type de données qu’elles fournissent et la façon dont elles sont consommées par les systèmes externes.
- Endpoints de statut : ils fournissent des compteurs globaux en temps réel. Ils sont mis à jour en mémoire et sont extrêmement légers à interroger. Ils sont idéaux pour suivre la « saturation » globale de l’instance NGINX.
- API (NGINX Plus) : disponibles uniquement dans la version commerciale, ces API fournissent des données JSON haute résolution. Elles permettent une visibilité par service, par upstream et par cache, indisponible dans la version open source.
- Journaux : c’est là que résident les données les plus granulaires. Les journaux d’accès enregistrent chaque interaction entre un client et NGINX, tandis que les journaux d’erreurs enregistrent les problèmes internes. Les journaux sont la seule source de vérité pour la latence au niveau des requêtes et les codes de statut individuels.
Il est important de distinguer les deux versions de NGINX : NGINX Open Source (OSS) et NGINX Plus. Bien que NGINX OSS soit le fondement d’Internet, ses capacités de supervision natives sont volontairement centrées sur les métriques globales. NGINX Plus offre une profondeur bien supérieure grâce à son API dynamique, essentielle pour les environnements à grande échelle nécessitant une télémétrie précise pour des centaines de services différents.
Dans les sections suivantes, nous explorerons en détail comment exploiter ces surfaces, en commençant par l’omniprésent module stub_status.
Superviser NGINX avec stub_status
Le module stub_status est la source principale (et souvent unique) de métriques en temps réel pour NGINX Open Source. Il fournit une sortie simple en texte brut qui révèle l’état interne des connexions de votre serveur.
Qu’est-ce que stub_status ?
Le ngx_http_stub_status_module suit un petit ensemble de compteurs globaux qui mesurent la charge sur le serveur et l’état de ses processus worker. Il n’examine pas les requêtes individuelles ; il regarde plutôt les connexions sur lesquelles ces requêtes transitent. S’il n’offre pas de métriques par virtual-host ou par route, il est vital pour comprendre si votre instance NGINX devient saturée ou s’il y a un problème avec le cycle de vie des connexions.
Comment activer stub_status
Pour utiliser stub_status, il doit être activé dans votre configuration. La plupart des versions de NGINX gérées par paquet incluent ce module par défaut.
Exemple de configuration
Vous devriez créer un bloc location dédié. Pour des raisons de sécurité, il est critique de restreindre l’accès. Exposer vos métriques de statut à l’Internet public est un risque de sécurité car cela peut révéler des schémas de trafic aux attaquants.
server {
    listen 127.0.0.1:80;
    server_name localhost;

    location /nginx_status {
        stub_status;
        allow 127.0.0.1;   # Autoriser l'accès local
        allow ::1;         # Autoriser l'accès local IPv6
        deny all;          # Interdire tout le reste
    }
}
Ce bloc de configuration va généralement dans un fichier séparé dans /etc/nginx/sites-enabled/ ou directement dans le bloc http de nginx.conf.
Appliquer les changements
Après avoir mis à jour votre configuration, validez toujours la syntaxe avant de recharger pour éviter toute interruption de service :
sudo nginx -tSi le test réussit, rechargez NGINX. Cela signale au processus maître de démarrer de nouveaux processus worker avec la nouvelle configuration et d’arrêter proprement les anciens :
sudo systemctl reload nginxTester et comprendre la sortie
Vous pouvez vérifier que l’endpoint fonctionne avec curl :
curl http://127.0.0.1/nginx_statusLa sortie est minimaliste par conception :
Active connections: 291
server accepts handled requests
 16630948 16630948 31070465
Reading: 6 Writing: 179 Waiting: 106
Bien que ces nombres bruts soient utiles pour les scripts, les visualiser vous donne un aperçu immédiat des schémas de trafic :
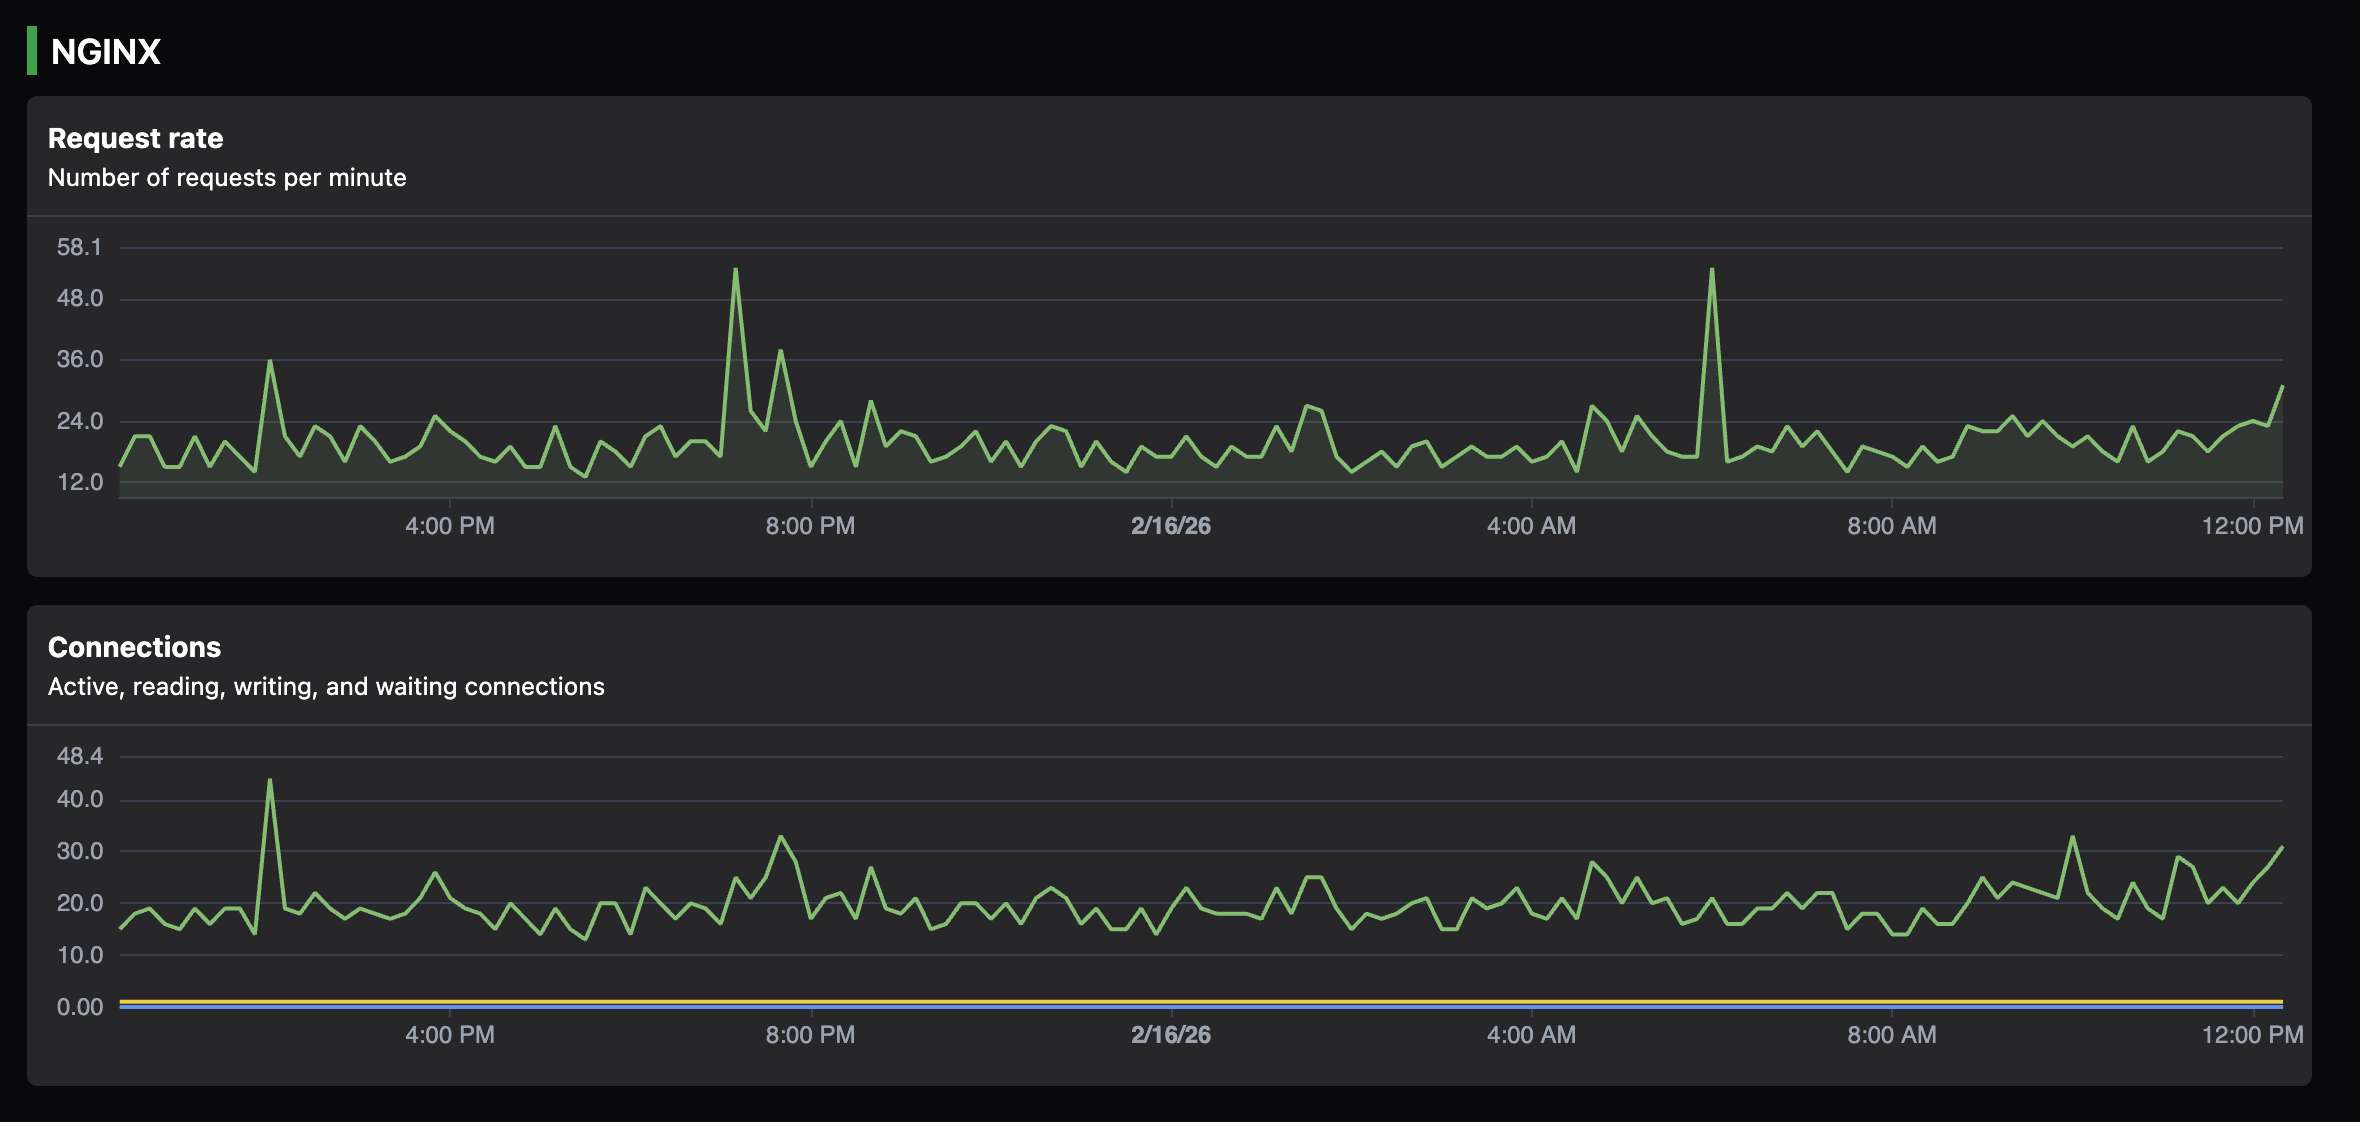
Ce que ces métriques signifient
Comprendre ces compteurs est la première étape de la supervision NGINX. Chacun raconte une partie spécifique de l’histoire :
- Active connections : le nombre total de connexions client actuellement ouvertes. Cela inclut les connexions qui transmettent activement des données et celles qui sont inactives.
- server accepts : le nombre total de connexions client acceptées depuis le démarrage de NGINX.
- handled : le nombre total de connexions traitées. Sur un système sain, cela doit être égal à
accepts. Sihandledest inférieur àaccepts, cela signifie que NGINX abandonne des connexions, souvent parce qu’il a atteint la limiteworker_connections. - requests : le nombre total de requêtes client. En raison des connexions keep-alive, une seule connexion peut servir plusieurs requêtes. Le ratio entre
requestset les connexionshandledest une bonne mesure de votre efficacité keep-alive. - Reading : NGINX lit actuellement l’en-tête de requête depuis le client. Des nombres élevés ici peuvent indiquer des clients lents ou des attaques potentielles de type « Slowloris ».
- Writing : NGINX écrit actuellement la réponse vers le client. C’est là que le travail actif se fait.
- Waiting : ce sont des connexions keep-alive où NGINX attend que le client envoie une autre requête. Des nombres élevés ici sont généralement corrects, mais ils consomment de la mémoire et des slots de connexion.
Limites de stub_status
Bien que stub_status soit excellent pour suivre la saturation de base, il présente des angles morts significatifs dont tout ingénieur doit être conscient :
- Contexte global uniquement : vous ne pouvez pas voir quel domaine spécifique (Server Name) cause la charge. Si vous hébergez dix sites différents sur une instance NGINX,
stub_statusles agrège tous. - Pas de codes de statut : il ne vous dit pas si vous servez des 200 réussis ou si vous échouez avec des 500.
- Pas d’informations sur la latence : il vous dit combien de requêtes ont lieu mais ne donne aucune indication sur leur durée de traitement.
- Compteurs cumulés : ce sont des nombres absolus depuis le démarrage du processus. Pour obtenir un taux « par seconde », vous avez besoin d’un outil de supervision qui extrait les données à intervalles réguliers et calcule la variation dans le temps.
Supervision avec l’API NGINX Plus
Pour les équipes qui nécessitent une visibilité plus profonde et peuvent en justifier le coût, NGINX Plus fournit une API RESTful JSON. Ce n’est pas qu’une amélioration de stub_status ; c’est un niveau de télémétrie entièrement différent.
L’API NGINX Plus fournit des données en temps réel pour :
- Upstreams HTTP : voir exactement quel serveur backend est lent ou en échec.
- Zones serveur : obtenir des statistiques de trafic et d’erreurs pour chaque bloc
serverindividuel. - Caches : superviser les taux de réussite de cache et la capacité.
- Resolvers : vérifier la santé et la latence de la résolution DNS.
Précisons-le clairement : cette API n’est pas disponible dans NGINX open source. Elle nécessite une licence commerciale de F5. Parce qu’il s’agit d’une fonctionnalité spécialisée, de nombreux outils de supervision généralistes, y compris Simple Observability, ne la prennent pas en charge. Ils se concentrent plutôt sur l’extraction d’informations similaires à partir des journaux, ce qui fonctionne aussi bien sur les versions OSS que Plus. Si vous utilisez NGINX Open Source, les sections suivantes sur les journaux seront votre voie principale vers une visibilité granulaire.
Superviser NGINX via les journaux
Si stub_status est le « pouls », les journaux sont le « récit ». Ils sont la source la plus critique pour le dépannage détaillé et la compréhension de l’expérience utilisateur.
Journaux d’accès vs journaux d’erreurs
- Journaux d’accès : ils enregistrent chaque requête. Ils sont la source principale pour calculer la latence (p99), les distributions de codes de statut et les schémas de trafic.
- Journaux d’erreurs : ils enregistrent les problèmes internes (par ex. « upstream timed out » ou « file not found »). Si une requête échoue, le journal d’accès vous dit *qu’*elle a échoué, mais le journal d’erreurs vous dit généralement pourquoi. Par exemple, un journal d’accès peut afficher un 502 Bad Gateway, mais le journal d’erreurs précisera s’il s’agissait d’un « connection refused » ou d’un « read timeout » depuis l’upstream.
Construire un journal d’accès adapté à la supervision
Par défaut, le format de journal combined de NGINX est conçu pour être lu par des humains, pas pour être analysé par des systèmes de supervision. Pour obtenir une véritable observabilité, vous devriez définir un log_format personnalisé qui inclut des métriques de performance.
log_format monitoring_format '$remote_addr - $remote_user [$time_local] '
                             '"$request" $status $body_bytes_sent '
                             '"$http_referer" "$http_user_agent" '
                             'rt=$request_time urt=$upstream_response_time';

access_log /var/log/nginx/access.log monitoring_format;
Champs clés pour l’observabilité :
- $status : essentiel pour calculer les taux d’erreur. Surveillez les pics en 5xx (erreurs serveur) ou 4xx (erreurs client).
- $request_time : le temps total que NGINX a passé sur la requête, mesuré en secondes avec une résolution à la milliseconde. Cela commence quand NGINX lit les premiers octets du client et se termine quand les derniers octets de la réponse sont envoyés. C’est votre métrique de « latence » principale.
- $upstream_response_time : le temps que l’application backend a mis pour répondre, également en secondes avec une résolution à la milliseconde. Cela mesure depuis l’établissement de la connexion upstream jusqu’à la réception du dernier octet de la réponse. En comparant cette valeur à
$request_time, vous pouvez déterminer si un ralentissement se produit dans NGINX lui-même ou dans votre code applicatif. - $body_bytes_sent : utilisé pour suivre la bande passante et identifier les réponses anormalement grandes (ou petites).
Pourquoi les journaux sont essentiels pour les métriques
Vous ne pouvez pas obtenir une métrique de latence p99 depuis un endpoint de statut. Vous ne pouvez l’obtenir qu’en examinant la distribution des temps de requête individuels dans les journaux. De même, calculer un « Taux de succès » (2xx/3xx vs Total) nécessite d’examiner les codes de statut. C’est pourquoi toute stratégie sérieuse de supervision NGINX doit inclure l’analyse des journaux. Tandis que les métriques vous donnent l’alerte, les journaux vous donnent le diagnostic.
Comment les outils de supervision collectent ces signaux
Les systèmes de supervision utilisent généralement l’un de trois modèles conceptuels pour ingérer les signaux NGINX. Comprendre ces modèles vous aide à choisir le bon outil selon votre échelle et votre complexité.
1. Polling (méthode pull)
L’outil de supervision ou un agent (comme un plugin Telegraf ou un script personnalisé) fait périodiquement une requête HTTP à /nginx_status. Il analyse le texte, calcule les taux (delta) et envoie les données à une base. C’est simple et fonctionne bien pour les métriques de base, mais c’est limité par la fréquence de polling.
2. Scraping (style Prometheus)
Un processus « exporter » se trouve à côté de NGINX, convertit les données brutes de statut et de journal dans un format que Prometheus comprend (OpenMetrics), et attend que le serveur Prometheus central le « scrape ». C’est le standard dans les environnements Kubernetes, mais il nécessite de maintenir le cycle de vie de l’exporter.
3. Tailing et parsing
C’est la méthode la plus puissante pour une observabilité haute fidélité. Un agent reste attaché aux fichiers de journal (tailing). Chaque fois qu’une nouvelle ligne est écrite, l’agent l’analyse en temps réel. Il peut ensuite agréger ces données en métriques, en calculant la latence moyenne, les taux d’erreur et les compteurs de requêtes, sans jamais avoir besoin d’un endpoint de statut HTTP. Cela fournit la vue la plus granulaire mais nécessite plus de ressources CPU pour le travail de parsing.
Comment Simple Observability s’intègre à NGINX
Simple Observability fournit une approche unifiée de la supervision NGINX en combinant les atouts des endpoints de statut et des journaux. Il est conçu pour les ingénieurs qui veulent une visibilité de niveau production sans la complexité de la mise en place d’exporters compliqués ou de parseurs de journaux manuels.
Le mécanisme d’intégration
Simple Observability utilise une approche hybride pour maximiser la visibilité tout en minimisant la configuration :
- Découverte des métriques : l’agent Simple Observability recherche automatiquement un endpoint
stub_statusconfiguré surlocalhost. Une fois trouvé, il commence à interroger les métriques au niveau des connexions (Active, Reading, Writing, etc.). - Tailing des journaux : l’agent suit les répertoires de journaux NGINX standard (par ex.
/var/log/nginx/). Il est préconfiguré pour comprendre les formats de journaux NGINX standards et peut être adapté à des formats personnalisés sur une seule ligne, rendant vos journaux consultables et accessibles. - Aucun besoin de NGINX Plus : Simple Observability fonctionne avec les signaux disponibles dans la version open source. Il n’utilise pas l’API NGINX Plus, ce qui le rend accessible à tous les utilisateurs.
Ce que cela permet
En combinant ces deux flux, Simple Observability vous donne une visibilité sur votre serveur NGINX :
- Le serveur est-il saturé ? (via les métriques stub_status)
- Que se passe-t-il dans mes journaux ? (via les journaux d’accès et d’erreurs consultables)
Vous obtenez des métriques au niveau des connexions et des journaux consultables, le tout géré via un agent unique et léger. Cela fournit une visibilité à la fois sur la santé globale de votre instance NGINX et sur la capacité d’examiner des requêtes spécifiques quand des problèmes surviennent.
Bonnes pratiques pour la supervision NGINX
Pour tirer le meilleur parti de votre configuration de supervision, gardez ces trois principes à l’esprit :
- Isolez votre endpoint de statut : n’écoutez jamais sur des interfaces publiques. Utilisez
127.0.0.1et restreignez l’accès via les directivesallow/deny. Les données de supervision sont des informations sensibles sur votre trafic. - Supervisez à la fois NGINX et le backend : incluez toujours
$upstream_response_timedans vos journaux. Si vous ne supervisez que la latence NGINX, vous ne saurez pas si le problème vient de la configuration de NGINX ou d’une requête de base de données lente dans votre application. - Alertez sur la saturation et les erreurs, pas seulement sur le « up/down » : un processus NGINX en cours d’exécution qui abandonne 50 % de ses connexions est effectivement en panne, même si le processus « tourne ». Configurez des alertes sur votre ratio
handled/acceptset votre taux d’erreurs 5xx. - Utilisez le keep-alive : surveillez le ratio entre
requestset les connexionshandled. S’il est proche de 1:1, vous ne bénéficiez pas du keep-alive, ce qui augmente la latence pour vos utilisateurs.
Conclusion
NGINX expose des signaux natifs limités mais extrêmement utiles. En activant stub_status et en configurant correctement vos journaux d’accès, vous débloquez les signaux primaires nécessaires pour comprendre le débit, la latence et les erreurs.
Une supervision efficace est la clé pour maintenir une infrastructure web haute performance. Elle fait le pont entre les données brutes et les informations actionnables, vous permettant d’attraper les problèmes avant qu’ils n’impactent vos utilisateurs. Que vous utilisiez une configuration manuelle ou un outil unifié comme Simple Observability, le but est le même : la visibilité sur le chemin critique de votre trafic.
La supervision ne devrait pas être une réflexion après coup ; elle devrait être intégrée dans votre configuration dès le premier jour. Avec les bons signaux, NGINX devient bien plus qu’un simple proxy : il devient votre outil le plus puissant pour l’excellence opérationnelle.