


NGINX 是基础设施的”前门”,但它本身不带仪表盘。要做好监控,通常依赖两个原生信号:用 stub_status 模块获取实时的饱和度指标,用 access log 追踪单请求级别的延迟。本指南讲解两者的配置方法。如果你用的是 Apache,可以参阅我们的 Apache 监控指南;想了解更宏观的内容,Web 服务器监控指南同时覆盖了两种服务器。
NGINX 原生提供哪些监控信号
在选监控工具之前,先要搞清楚 NGINX 暴露内部状态的三种主要途径。它们在粒度、数据类型以及外部系统消费方式上各有不同。
- 状态端点:提供实时全局计数器,数据驻留在内存中,查询开销极低,最适合追踪 NGINX 实例整体的”饱和度”。
- API(NGINX Plus):仅商业版提供,输出高分辨率 JSON,能按服务、按 upstream、按缓存分别查看,开源版不具备这种能力。
- 日志:粒度最细。access log 记录客户端与 NGINX 之间的每一次交互,error log 记录内部问题。请求级别的延迟和具体状态码,只能从日志获取。
有必要区分 NGINX 的两个版本:NGINX Open Source (OSS) 和 NGINX Plus。NGINX OSS 是互联网的基石,但它的原生监控能力刻意聚焦在全局指标上。NGINX Plus 通过动态 API 提供显著更深的可见性,对需要为成百上千个不同服务采集精确遥测数据的大规模环境来说不可或缺。
接下来几节深入讲解如何利用这三种途径,先从最常见的 stub_status 模块开始。
用 stub_status 监控 NGINX
stub_status 模块是 NGINX Open Source 主要的(往往也是唯一的)实时指标来源,输出一段简洁的纯文本,揭示服务器内部的连接状态。
stub_status 是什么
ngx_http_stub_status_module 追踪一组全局计数器,衡量服务器负载和 worker 进程的状态。它不关注单个请求,关注的是请求所依赖的连接。虽然拿不到按虚拟主机或按路由细分的指标,但要判断 NGINX 实例是否趋于饱和、连接生命周期是否出问题,它至关重要。
如何启用 stub_status
要使用 stub_status,必须在配置中开启。大多数包管理方式安装的 NGINX 默认就带这个模块。
配置示例
应当单独建一个 location 块。出于安全考虑,必须限制访问。把状态指标暴露到公网上有风险,会让攻击者看到你的流量模式。
server {
    listen 127.0.0.1:80;
    server_name localhost;

    location /nginx_status {
        stub_status;
        allow 127.0.0.1;   # Allow local access
        allow ::1;         # Allow local IPv6 access
        deny all;          # Deny everyone else
    }
}
这段配置通常放进 /etc/nginx/sites-enabled/ 下的独立文件,或者直接写在 nginx.conf 的 http 块里。
应用改动
改完配置后,重载前一定要先校验语法,避免停机:
sudo nginx -t测试通过就重载 NGINX。这会让 master 进程用新配置启动新的 worker 进程,并优雅地关掉旧的:
sudo systemctl reload nginx测试并理解输出
用 curl 验证端点是否生效:
curl http://127.0.0.1/nginx_status输出刻意做得极简:
Active connections: 291
server accepts handled requests
 16630948 16630948 31070465
Reading: 6 Writing: 179 Waiting: 106
这些原始数字给脚本用没问题,但要把流量模式一眼看明白,还是得可视化:
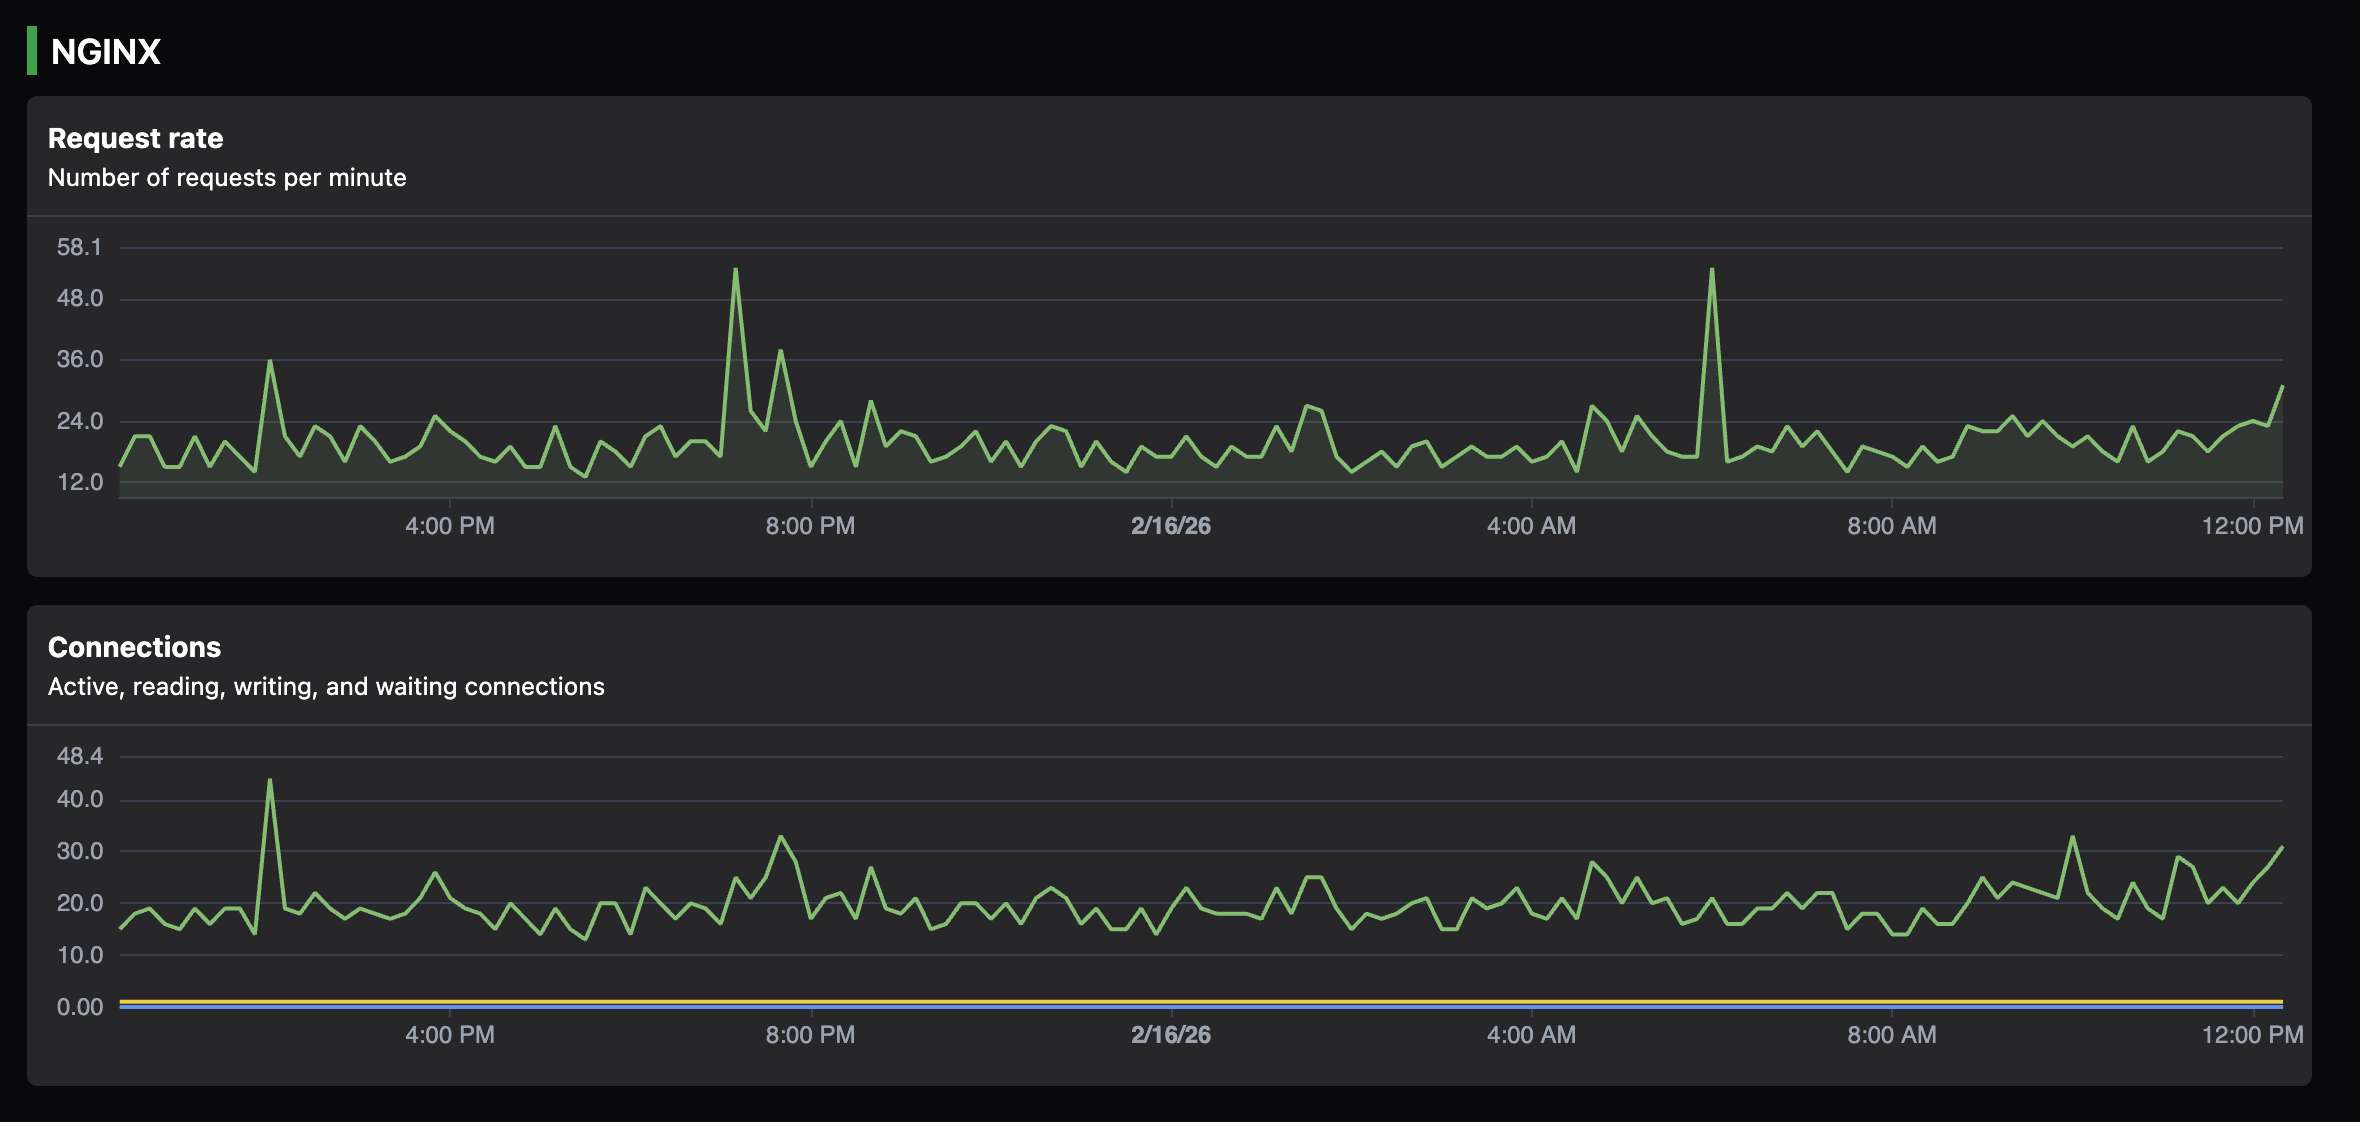
这些指标的含义
看懂这些计数器是 NGINX 监控的第一步。每个指标都讲述故事的一段:
- Active connections:当前打开的客户端连接总数,既包括正在传输数据的,也包括空闲的。
- server accepts:自 NGINX 启动以来接受的客户端连接总数。
- handled:已处理的连接总数。健康的系统里应当等于
accepts。如果handled低于accepts,说明 NGINX 在丢连接,常常是达到了worker_connections上限。 - requests:客户端请求总数。因为有 keep-alive,一条连接可以承载多个请求。
requests与handled的比值能反映 keep-alive 的效率。 - Reading:NGINX 正在读取客户端请求头。数值偏高可能意味着客户端慢,或者遭遇 Slowloris 类攻击。
- Writing:NGINX 正在把响应写回客户端,是真正干活的地方。
- Waiting:处于 keep-alive 的连接,NGINX 在等客户端发下一个请求。数值偏高通常无妨,但会占用内存和连接槽。
stub_status 的局限
stub_status 适合追踪基础饱和度,但有几个明显的盲区,每位工程师都该知道:
- 只有全局视角:看不出是哪个域名(Server Name)在造成负载。一台 NGINX 上挂十个站,
stub_status全部合在一起统计。 - 没有状态码:看不出你返回的是成功的 200 还是失败的 500。
- 没有延迟信息:告诉你发生了多少请求,对处理耗时只字不提。
- 累计计数器:都是进程启动以来的绝对值。要算”每秒”速率,得靠监控工具定时拉取并计算差值。
用 NGINX Plus API 监控
对需要更深可见性、也能承担费用的团队,NGINX Plus 提供 RESTful JSON API。这不只是 stub_status 的升级,而是完全不同级别的遥测。
NGINX Plus API 提供以下实时数据:
- HTTP upstream:精确看到哪台后端慢或失败。
- Server zone:每个
server块的流量和错误统计。 - 缓存:命中率与容量。
- Resolver:DNS 解析的健康状况和延迟。
需要明确的是,这个 API 在开源 NGINX 里没有,需要向 F5 购买商业授权。因为是个专门特性,很多通用监控工具(包括 Simple Observability)并不支持它,转而从日志中提取类似的洞察,这种方式在 OSS 和 Plus 上都能用。如果你用的是开源 NGINX,后面关于日志的几节就是你获取细粒度可见性的主要途径。
通过日志监控 NGINX
如果说 stub_status 是”脉搏”,日志就是”叙事”。在细致排查、理解用户体验方面,日志是最关键的来源。
Access log 与 error log 的区别
- Access log:记录每一次请求,是计算 p99 延迟、状态码分布和流量模式的主要来源。
- Error log:记录内部问题(比如 “upstream timed out” 或 “file not found”)。一个请求失败时,access log 告诉你它失败了,error log 通常告诉你为什么。比如 access log 里看到 502 Bad Gateway,error log 会写明是 upstream “connection refused” 还是 “read timeout”。
构建便于监控的 access log
NGINX 默认的 combined 日志格式是给人看的,不是给监控系统解析的。要真正可观测,应该自定义 log_format,把性能指标写进去。
log_format monitoring_format '$remote_addr - $remote_user [$time_local] '
                             '"$request" $status $body_bytes_sent '
                             '"$http_referer" "$http_user_agent" '
                             'rt=$request_time urt=$upstream_response_time';

access_log /var/log/nginx/access.log monitoring_format;
关键可观测字段:
- $status:算错误率必备。留意 5xx(服务器错误)或 4xx(客户端错误)的突增。
- $request_time:NGINX 处理这个请求的总耗时,以秒为单位、毫秒精度。从 NGINX 读取客户端第一个字节开始,到响应最后一个字节发完为止,这是你的主延迟指标。
- $upstream_response_time:后端应用的响应耗时,同样以秒为单位、毫秒精度。从建立 upstream 连接到收到响应最后一个字节为止。拿它和
$request_time对比,就能判断慢在 NGINX 自身还是你的应用代码。 - $body_bytes_sent:用来追踪带宽,识别异常大或异常小的响应。
为什么指标离不开日志
从状态端点拿不到 p99 延迟指标,只能从日志里看单请求耗时的分布。算”成功率”(2xx/3xx 占总请求的比例)也要看状态码。所以任何认真的 NGINX 监控策略都必须包含日志分析。指标给你报警,日志给你诊断。
监控工具如何采集这些信号
监控系统采集 NGINX 信号通常走三种模式之一。理解这三种模式,有助于根据自身规模和复杂度选对工具。
1. 轮询(Pull 模式)
监控工具或 agent(比如 Telegraf 插件或自写脚本)定期向 /nginx_status 发 HTTP 请求,解析文本、算出速率(差值),再把数据写入数据库。方式简单,适合基础指标,但受限于轮询频率。
2. 抓取(Prometheus 模式)
在 NGINX 旁边跑一个 “exporter” 进程,把原始的状态和日志数据转成 Prometheus 认识的格式(OpenMetrics),等中心的 Prometheus 服务器来 “scrape”。这是 Kubernetes 环境的标准做法,但需要维护 exporter 的生命周期。
3. Tailing 与解析
这是高保真可观测最强大的方式。一个 agent 持续跟随日志文件(tailing),每写入新的一行就实时解析,再把这些聚合为指标,算平均延迟、错误率、请求数,完全不依赖 HTTP 状态端点。粒度最细,但解析会消耗更多 CPU。
Simple Observability 如何与 NGINX 集成
Simple Observability 把状态端点和日志两者的长处合到一起,提供统一的 NGINX 监控方案。它面向那些想要生产级可见性、又不想折腾复杂 exporter 或手写日志解析的工程师。
集成机制
Simple Observability 用混合模式,在最小化配置的同时最大化可见性:
- 指标发现:Simple Observability agent 自动在
localhost上查找配置好的stub_status端点,找到后开始轮询连接级指标(Active、Reading、Writing 等)。 - 日志 Tailing:agent 跟随 NGINX 标准日志目录(如
/var/log/nginx/)。预置了对标准 NGINX 日志格式的识别,也能适配自定义的单行格式,让你的日志可搜索、可访问。 - 不依赖 NGINX Plus:Simple Observability 用的是开源版就能拿到的信号,不用 NGINX Plus API,所有用户都能用。
带来的效果
两条数据流合在一起,Simple Observability 让你对 NGINX 服务器有了这样的可见性:
- 服务器饱和了吗?(通过 stub_status 指标)
- 日志里发生了什么?(通过可搜索的 access log 和 error log)
连接级指标和可搜索的日志,全靠一个轻量 agent 管理。既看得见 NGINX 实例的整体健康,又能在出问题时追查到具体请求。
NGINX 监控最佳实践
想让监控发挥最大作用,记住这几条原则:
- 隔离状态端点:绝不要监听公网接口。用
127.0.0.1,配合allow/deny指令限制访问。监控数据是你流量的敏感信息。 - NGINX 和后端一起监控:日志里务必带上
$upstream_response_time。只盯 NGINX 延迟,你分不清问题出在 NGINX 配置,还是应用里慢的数据库查询。 - 针对饱和和错误报警,而不是只看”起没起”:一个 NGINX 进程在跑却在丢掉 50% 的连接,即便进程”在运行”,实际上也等于挂了。给
handled/accepts比值和 5xx 错误率设告警。 - 用好 keep-alive:监控
requests与handled的比值。接近 1:1 说明没享受到 keep-alive 的好处,会让用户感到更高延迟。
结语
NGINX 原生暴露的信号虽然有限,但极为有用。开启 stub_status、配好 access log,你就解锁了理解吞吐、延迟和错误所需的核心信号。
有效的监控是维持高性能 Web 基础设施的关键。它在原始数据和可执行洞察之间搭起桥梁,让你在问题波及用户之前就抓住它。无论手动搭建还是用 Simple Observability 这类统一工具,目标一致:看清流量的关键路径。
监控不该是事后补丁,要从第一天就写进配置里。有了对的信号,NGINX 就不只是个代理,更是你实现卓越运维最有力的工具。