



NGINX actúa como la “puerta de entrada” de tu infraestructura, pero no incluye paneles integrados. Para monitorizarlo de forma efectiva, normalmente dependes de dos señales nativas: el módulo stub_status para métricas de saturación en tiempo real, y los logs de acceso para el seguimiento de latencia a nivel de petición. Esta guía cubre cómo configurar ambos. Si usas Apache en su lugar, consulta nuestra guía de monitorización de Apache. Para una perspectiva más amplia, nuestra guía de monitorización de servidores web cubre ambos servidores.
Lo que NGINX expone nativamente para monitorización
Antes de recurrir a una herramienta de monitorización, debes entender las tres superficies principales a través de las cuales NGINX expone su estado interno. Estas superficies difieren en su granularidad, en el tipo de datos que proporcionan y en cómo son consumidas por sistemas externos.
- Endpoints de estado: Proporcionan contadores globales en tiempo real. Se actualizan en memoria y son extremadamente ligeros de consultar. Son ideales para seguir la “saturación” general de la instancia de NGINX.
- APIs (NGINX Plus): Disponibles solo en la versión comercial, estas APIs proporcionan datos JSON de alta resolución. Permiten visibilidad por servicio, por upstream y por caché que no está disponible en la versión de código abierto.
- Logs: Aquí es donde residen los datos más granulares. Los logs de acceso registran cada interacción entre un cliente y NGINX, mientras que los logs de errores registran problemas internos. Los logs son la única fuente de verdad para la latencia a nivel de petición y los códigos de estado individuales.
Es importante distinguir entre las dos versiones de NGINX: NGINX Open Source (OSS) y NGINX Plus. Aunque NGINX OSS es la base de internet, sus capacidades nativas de monitorización se centran intencionalmente en métricas globales. NGINX Plus ofrece significativamente más profundidad a través de su API dinámica, que es esencial para entornos a gran escala que requieren telemetría precisa para cientos de servicios diferentes.
En las siguientes secciones, profundizaremos en cómo aprovechar estas superficies, empezando por el ubicuo módulo stub_status.
Monitorización de NGINX con stub_status
El módulo stub_status es la fuente principal (y a menudo la única) de métricas en tiempo real para NGINX Open Source. Proporciona una salida simple en texto plano que revela el estado interno de las conexiones de tu servidor.
¿Qué es stub_status?
El ngx_http_stub_status_module rastrea un pequeño conjunto de contadores globales que miden la carga del servidor y el estado de sus procesos worker. No examina peticiones individuales; en su lugar, observa las conexiones por las que viajan esas peticiones. Aunque no ofrece métricas por virtual-host o por ruta, es vital para entender si tu instancia de NGINX se está saturando o si hay un problema con el ciclo de vida de las conexiones.
Cómo activar stub_status
Para usar stub_status, debe estar activado en tu configuración. La mayoría de las versiones de NGINX gestionadas por paquetes incluyen este módulo por defecto.
Ejemplo de configuración
Debes crear un bloque location dedicado. Por seguridad, es crítico restringir el acceso. Exponer tus métricas de estado a internet pública es un riesgo de seguridad porque puede revelar patrones de tráfico a atacantes.
server {
    listen 127.0.0.1:80;
    server_name localhost;

    location /nginx_status {
        stub_status;
        allow 127.0.0.1;   # Allow local access
        allow ::1;         # Allow local IPv6 access
        deny all;          # Deny everyone else
    }
}
Este bloque de configuración normalmente va en un archivo separado en /etc/nginx/sites-enabled/ o directamente dentro del bloque http de nginx.conf.
Aplicar los cambios
Después de actualizar tu configuración, valida siempre la sintaxis antes de recargar para evitar tiempos de inactividad:
sudo nginx -tSi la prueba es exitosa, recarga NGINX. Esto señala al proceso master que inicie nuevos procesos worker con la nueva configuración y cierre los antiguos de forma elegante:
sudo systemctl reload nginxPrueba y comprensión de la salida
Puedes verificar que el endpoint funciona usando curl:
curl http://127.0.0.1/nginx_statusLa salida es minimalista por diseño:
Active connections: 291
server accepts handled requests
 16630948 16630948 31070465
Reading: 6 Writing: 179 Waiting: 106
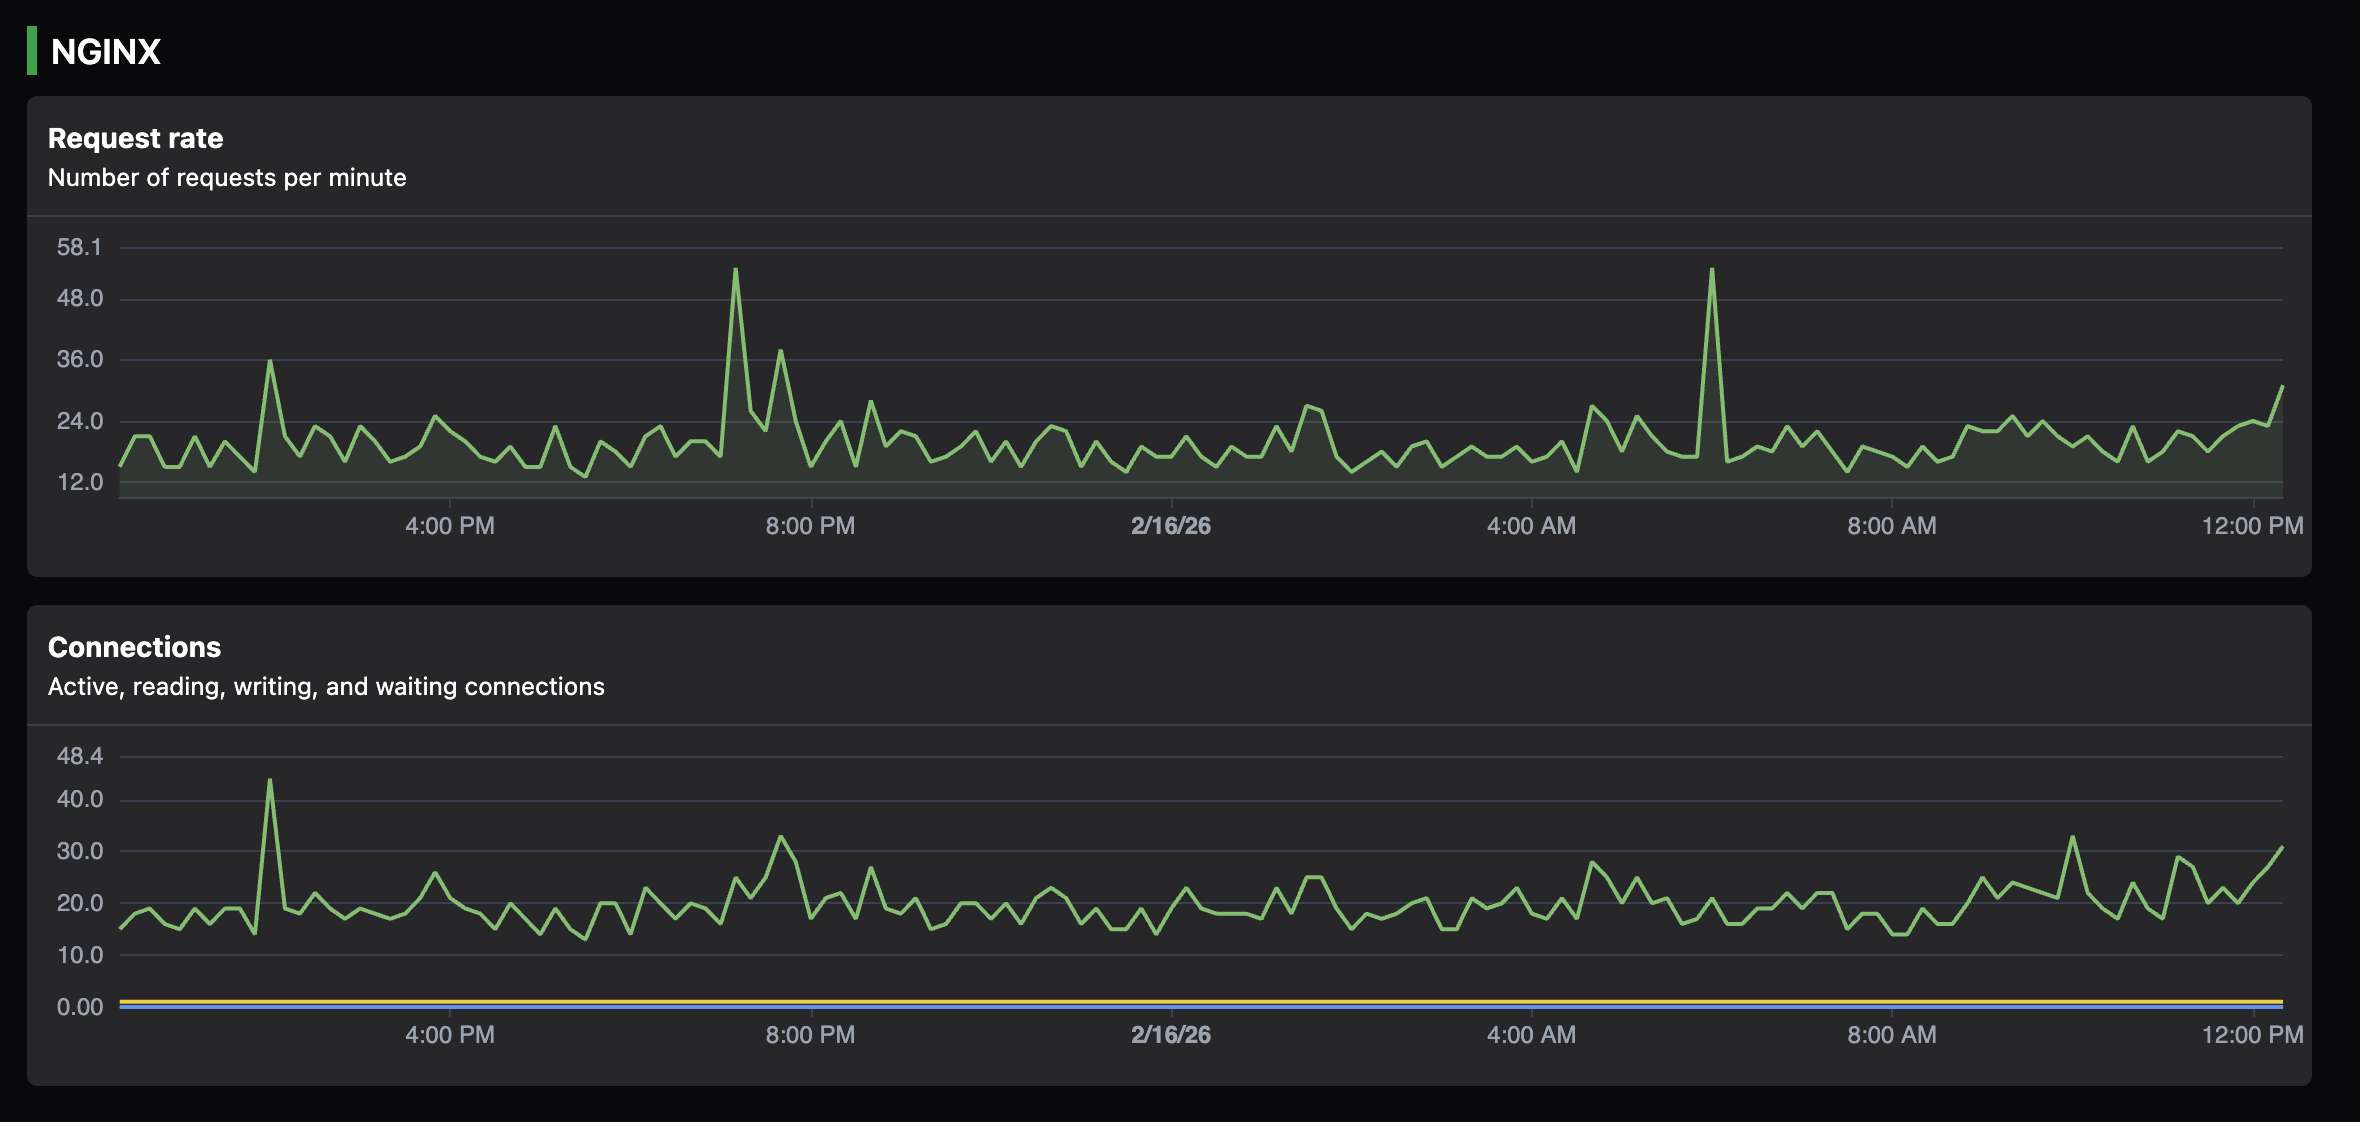
Aunque estos números en bruto son útiles para scripts, visualizarlos te da una visión inmediata de los patrones de tráfico:
Qué significan estas métricas
Entender estos contadores es el primer paso en la monitorización de NGINX. Cada uno cuenta una parte específica de la historia:
- Active connections: El número total de conexiones de cliente abiertas actualmente. Esto incluye conexiones que están transmitiendo datos activamente y las que están inactivas.
- server accepts: El número total de conexiones de cliente aceptadas desde que NGINX se inició.
- handled: El número total de conexiones gestionadas. En un sistema sano, esto debería ser igual a
accepts. Sihandledes menor queaccepts, significa que NGINX está descartando conexiones, a menudo porque ha alcanzado el límite deworker_connections. - requests: El número total de peticiones de cliente. Debido a las conexiones keep-alive, una sola conexión puede servir muchas peticiones. La proporción de
requestssobre conexioneshandledes una buena medida de tu eficiencia keep-alive. - Reading: NGINX está leyendo actualmente la cabecera de la petición del cliente. Números altos aquí pueden indicar clientes lentos o posibles ataques de tipo “Slowloris”.
- Writing: NGINX está escribiendo actualmente la respuesta de vuelta al cliente. Aquí es donde ocurre el trabajo activo.
- Waiting: Estas son conexiones keep-alive donde NGINX está esperando a que el cliente envíe otra petición. Números altos aquí generalmente están bien, pero consumen memoria y slots de conexión.
Limitaciones de stub_status
Aunque stub_status es excelente para seguir la saturación básica, tiene puntos ciegos significativos que todo ingeniero debería conocer:
- Solo contexto global: No puedes ver qué dominio específico (Server Name) está causando carga. Si alojas diez sitios diferentes en una instancia de NGINX,
stub_statuslos agrega a todos. - Sin códigos de estado: No te dice si estás sirviendo 200 exitosos o fallando con 500.
- Sin información de latencia: Te dice cuántas peticiones están ocurriendo pero no da ninguna indicación de cuánto tardan en procesarse.
- Contadores acumulativos: Son números absolutos desde que el proceso se inició. Para obtener una tasa “por segundo”, necesitas una herramienta de monitorización que extraiga los datos a intervalos y calcule el cambio a lo largo del tiempo.
Monitorización con la API de NGINX Plus
Para equipos que requieren mayor visibilidad y pueden justificar el coste, NGINX Plus proporciona una API RESTful en JSON. Esto no es solo una mejora de stub_status; es un nivel de telemetría completamente distinto.
La API de NGINX Plus proporciona datos en tiempo real para:
- HTTP upstreams: Ver exactamente qué servidor backend es lento o está fallando.
- Server zones: Obtener estadísticas de tráfico y errores para cada bloque
serverindividual. - Cachés: Monitorizar los ratios de aciertos de caché y la capacidad.
- Resolvers: Comprobar la salud y latencia de la resolución DNS.
Quede claro, esta API no está disponible en NGINX de código abierto. Requiere una licencia comercial de F5. Al ser una función especializada, muchas herramientas de monitorización de propósito general, incluyendo Simple Observability, no la soportan. En su lugar, se centran en extraer información similar de los logs, lo cual funciona tanto en la versión OSS como en Plus. Si usas NGINX Open Source, las siguientes secciones sobre logs serán tu camino principal hacia una visibilidad granular.
Monitorización de NGINX a través de logs
Si stub_status es el “pulso”, los logs son la “narrativa”. Son la fuente más crítica para la resolución de problemas detallada y para entender la experiencia del usuario.
Logs de acceso vs. logs de errores
- Logs de acceso: Registran cada petición. Son la fuente principal para calcular latencia (p99), distribuciones de códigos de estado y patrones de tráfico.
- Logs de errores: Registran problemas internos (por ejemplo, “upstream timed out” o “file not found”). Si una petición falla, el log de acceso te dice que falló, pero el log de errores normalmente te dice por qué. Por ejemplo, un log de acceso podría mostrar un 502 Bad Gateway, pero el log de errores especificará si fue un “connection refused” o un “read timeout” del upstream.
Construir un log de acceso apto para monitorización
Por defecto, el formato combined de NGINX está diseñado para que lo lean humanos, no para que lo analicen sistemas de monitorización. Para obtener observabilidad real, debes definir un log_format personalizado que incluya métricas de rendimiento.
log_format monitoring_format '$remote_addr - $remote_user [$time_local] '
                             '"$request" $status $body_bytes_sent '
                             '"$http_referer" "$http_user_agent" '
                             'rt=$request_time urt=$upstream_response_time';

access_log /var/log/nginx/access.log monitoring_format;
Campos clave para observabilidad:
- $status: Esencial para calcular tasas de error. Vigila los picos en 5xx (errores de servidor) o 4xx (errores de cliente).
- $request_time: El tiempo total que NGINX dedicó a la petición, medido en segundos con resolución de milisegundos. Esto comienza cuando NGINX lee los primeros bytes del cliente y termina cuando se envían los últimos bytes de la respuesta. Esta es tu métrica principal de “latencia”.
- $upstream_response_time: El tiempo que tardó la aplicación backend en responder, también en segundos con resolución de milisegundos. Esto mide desde el establecimiento de la conexión upstream hasta la recepción del último byte de la respuesta. Comparando esto con
$request_time, puedes determinar si una ralentización está ocurriendo en el propio NGINX o en el código de tu aplicación. - $body_bytes_sent: Se usa para seguir el ancho de banda e identificar respuestas inusualmente grandes (o pequeñas).
Por qué los logs son esenciales para las métricas
No puedes obtener una métrica de latencia p99 desde un endpoint de estado. Solo puedes obtenerla analizando la distribución de los tiempos individuales de petición en los logs. De forma similar, calcular una “tasa de éxito” (2xx/3xx vs. total) requiere mirar los códigos de estado. Por eso, cualquier estrategia seria de monitorización de NGINX debe incluir análisis de logs. Mientras que las métricas te dan la alerta, los logs te dan el diagnóstico.
Cómo las herramientas de monitorización recopilan estas señales
Los sistemas de monitorización generalmente usan uno de tres patrones conceptuales para ingerir señales de NGINX. Entender estos patrones te ayuda a elegir la herramienta adecuada para tu escala y complejidad.
1. Polling (método pull)
La herramienta de monitorización o un agente (como un plugin de Telegraf o un script personalizado) realiza periódicamente una petición HTTP a /nginx_status. Analiza el texto, calcula las tasas (deltas) y envía los datos a una base de datos. Es simple y funciona bien para métricas básicas, pero está limitado por la frecuencia de polling.
2. Scraping (estilo Prometheus)
Un proceso “exporter” se sitúa junto a NGINX, convierte los datos de estado y de log en bruto en un formato que Prometheus entiende (OpenMetrics), y espera a que el servidor central de Prometheus lo “scrapee”. Es el estándar en entornos Kubernetes pero requiere mantener el ciclo de vida del exporter.
3. Tailing y parseo
Este es el método más potente para una observabilidad de alta fidelidad. Un agente se mantiene adjunto a los archivos de log (tailing). Cada vez que se escribe una nueva línea, el agente la analiza en tiempo real. Luego puede agregar estos datos en métricas, calculando latencia media, tasas de error y recuentos de peticiones, sin necesidad de un endpoint de estado HTTP. Proporciona la vista más granular pero requiere más recursos de CPU para el trabajo de parseo.
Cómo Simple Observability se integra con NGINX
Simple Observability proporciona un enfoque unificado para la monitorización de NGINX combinando las fortalezas de los endpoints de estado y de los logs. Está diseñado para ingenieros que quieren visibilidad de nivel producción sin la complejidad de configurar exporters complejos o analizadores de logs manuales.
El mecanismo de integración
Simple Observability usa un enfoque híbrido para maximizar la visibilidad minimizando la configuración:
- Descubrimiento de métricas: El agente de Simple Observability busca automáticamente un endpoint
stub_statusconfigurado enlocalhost. Una vez encontrado, comienza a extraer métricas a nivel de conexión (Active, Reading, Writing, etc.). - Tailing de logs: El agente hace tail de los directorios estándar de logs de NGINX (por ejemplo,
/var/log/nginx/). Viene preconfigurado para entender los formatos estándar de log de NGINX y puede adaptarse a formatos personalizados de una sola línea, haciendo que tus logs sean buscables y accesibles. - Sin requisito de NGINX Plus: Simple Observability funciona con las señales disponibles en la versión de código abierto. No usa la API de NGINX Plus, haciéndola accesible para todos los usuarios.
Qué esto consigue
Al combinar estos dos flujos, Simple Observability te da visibilidad sobre tu servidor NGINX:
- ¿Está el servidor saturado? (mediante métricas stub_status)
- ¿Qué está pasando en mis logs? (mediante logs de acceso y errores buscables)
Obtienes métricas a nivel de conexión y logs buscables, todo gestionado mediante un único agente ligero. Esto proporciona visibilidad tanto de la salud general de tu instancia de NGINX como de la capacidad de investigar peticiones específicas cuando surgen problemas.
Mejores prácticas de monitorización de NGINX
Para sacar el máximo provecho de tu configuración de monitorización, ten en cuenta estos tres principios:
- Aísla tu endpoint de estado: Nunca escuches en interfaces públicas. Usa
127.0.0.1y restringe el acceso mediante directivasallow/deny. Los datos de monitorización son información sensible sobre tu tráfico. - Monitoriza tanto NGINX como el backend: Incluye siempre
$upstream_response_timeen tus logs. Si solo monitorizas la latencia de NGINX, no sabrás si el problema es la configuración de NGINX o una consulta lenta a la base de datos en tu aplicación. - Alerta sobre saturación y errores, no solo sobre “up/down”: Un proceso de NGINX en ejecución que está descartando el 50% de sus conexiones está efectivamente caído, aunque el proceso esté “running”. Configura alertas sobre tu ratio
handled/acceptsy tu tasa de errores 5xx. - Usa keep-alive: Monitoriza la proporción de
requestssobre conexioneshandled. Si está cerca de 1:1, no te estás beneficiando del keep-alive, lo que aumenta la latencia para tus usuarios.
Conclusión
NGINX expone señales nativas limitadas pero extremadamente útiles. Al activar stub_status y configurar correctamente tus logs de acceso, desbloqueas las señales principales necesarias para entender throughput, latencia y errores.
Una monitorización efectiva es la clave para mantener una infraestructura web de alto rendimiento. Cierra la brecha entre los datos en bruto y la información accionable, permitiéndote detectar problemas antes de que afecten a tus usuarios. Ya sea que uses una configuración manual o una herramienta unificada como Simple Observability, el objetivo es el mismo: visibilidad sobre la ruta crítica de tu tráfico.
La monitorización no debería ser un pensamiento tardío; debería estar integrada en tu configuración desde el primer día. Con las señales correctas, NGINX se convierte en más que un simple proxy, en tu herramienta más poderosa para la excelencia operativa.