



Encontrar uma ferramenta de monitoramento que cubra toda a sua stack sem virar um segundo emprego para a sua equipe é mais difícil do que parece. Aqui estão as 10 melhores soluções comparadas. Para contexto sobre o que você está monitorando, confira nosso guia de infraestrutura de servidores e as melhores práticas de dashboard de monitoramento de infraestrutura.
A maioria dos projetos de monitoramento de infraestrutura falha não porque a ferramenta tinha poucos recursos, mas porque a equipe não tinha tempo para mantê-la. Em 2026, a distância entre sistemas cloud-native e hardware legado on-prem é maior do que nunca. Você precisa de uma solução que faça a ponte entre esses dois mundos mantendo a configuração no mínimo.
O mercado está dividido entre gigantes enterprise que custam uma fortuna e ferramentas open-source que exigem esforço manual significativo. Esta lista foca nas ferramentas que oferecem o melhor “tempo até visibilidade” em ambientes híbridos.
O que faz uma solução moderna de monitoramento de infraestrutura de TI?
Uma solução moderna precisa ir além de simples pings ICMP. Ela precisa correlacionar métricas, logs e traces em uma única visão para reduzir o tempo médio até a resolução (MTTR).
Em 2026, os requisitos não negociáveis são auto-discovery, agentes leves e suporte híbrido. Se você precisa atualizar seu monitoramento manualmente toda vez que sobe uma instância na nuvem, sua solução já está defasada.
Resumo rápido
| Ferramenta | Melhor para | Modelo de preço |
|---|---|---|
| Simple Observability | Simplicidade e zero config | $3 / mês / servidor |
| Datadog | Enterprise / Cloud | $15+ / host / mês |
| Prometheus & Grafana | Cloud native / K8s | Grátis (OSS) / Gerenciado pago |
| Zabbix | Rede / On-prem | $50 / mês (Cloud) |
| New Relic | Performance de app (APM) | Baseado em uso ($0,30/GB) |
| LogicMonitor | Híbrido / Mid-market | Sob consulta |
| Checkmk | TI complexa / Híbrido | ~$6 / host / mês |
| Site24x7 | PMEs / SaaS | A partir de $9 / mês |
| Netdata | Troubleshooting em tempo real | Grátis (OSS) / Cloud pago |
| Nagios XI | Ambientes legados | $2.495+ (licença) |
10 melhores soluções de monitoramento de infraestrutura de TI
1. Simple Observability
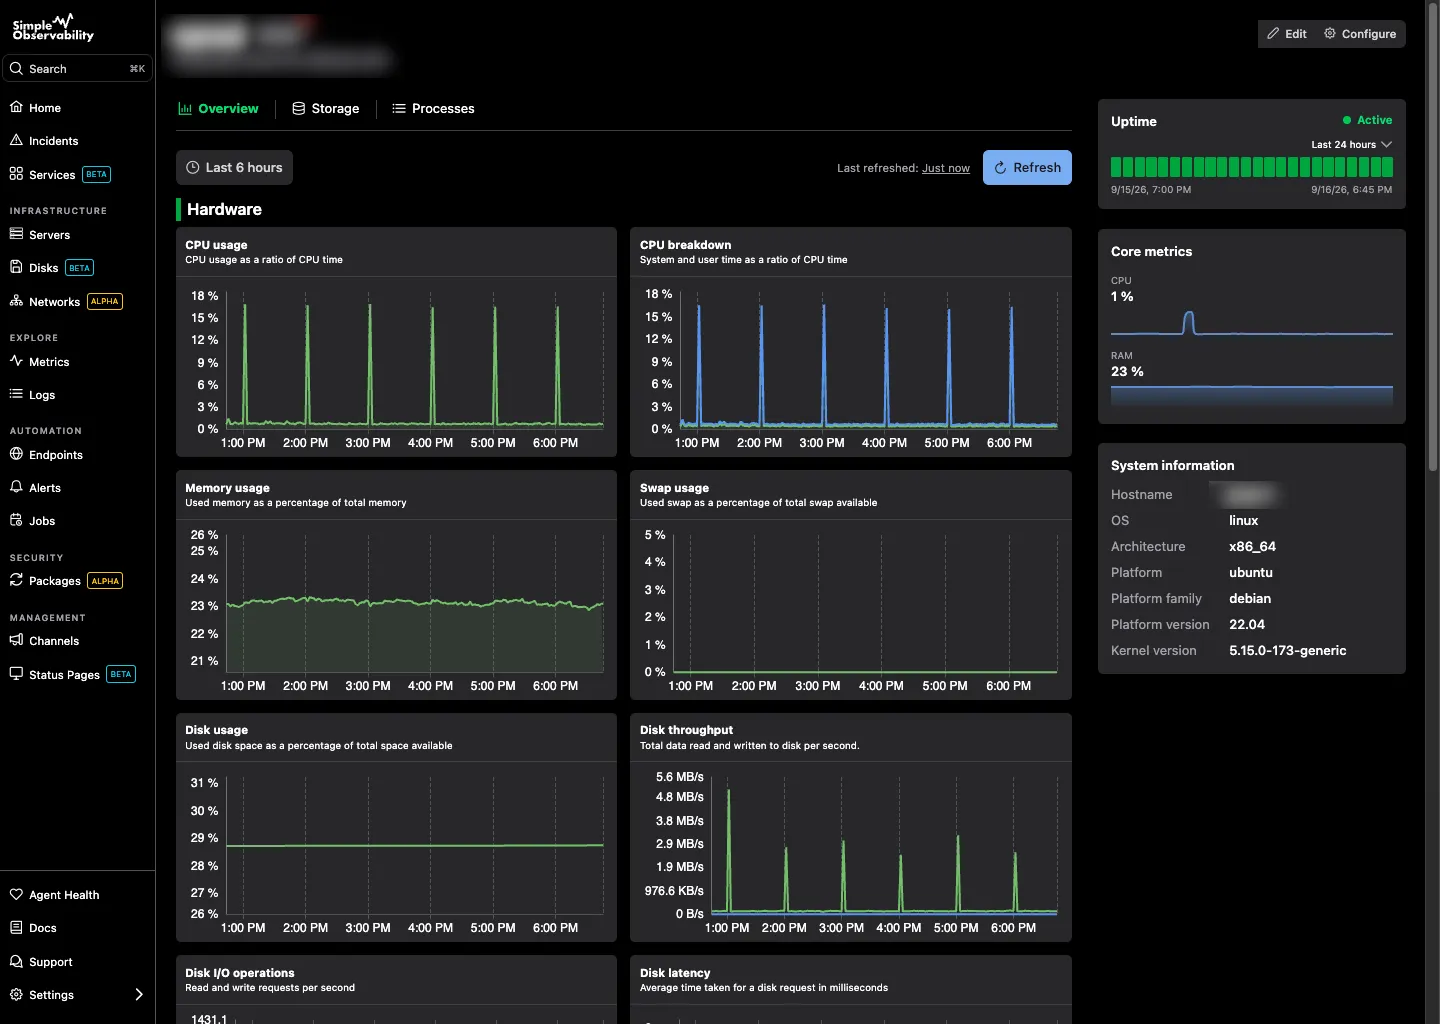
A Simple Observability é feita para equipes que querem visibilidade de nível enterprise sem a configuração de nível enterprise. Um único agente binário leve faz auto-discovery de serviços e começa a reportar dados imediatamente, sem necessidade de brigar com YAML.
Principais recursos
- Instalação com um comando: Sem configuração complexa de agente. Você tem monitoramento de CPU, memória, disco e uptime instantaneamente.
- Logs e métricas unificados: Veja logs de aplicações junto com métricas de servidor no mesmo dashboard.
- Alertas sem configuração: Defaults sensíveis out-of-the-box para que você esteja protegido desde o primeiro dia.
- Conveniência SaaS: Sem banco de dados de métricas ou stack de retenção para hospedar.
Prós
- Setup extremamente rápido: Visibilidade imediata sem configuração manual de dashboard.
- Preço previsível: Valor fixo por servidor, sem surpresas de “por milhão de métricas customizadas”.
- Correlaciona logs e métricas por padrão: Sem precisar costurar ferramentas separadas.
Contras
- Menos plugins especializados: Gigantes legados como Nagios têm um ecossistema de plugins maior.
Melhor para: Equipes que precisam de visibilidade imediata em ativos híbridos de cloud e on-prem.
Preço
- Grátis: $0 por 1 servidor.
- Pago: $3/mês por servidor para servidores ilimitados.
- Personalizado: Descontos por volume para grandes frotas.
2. Datadog
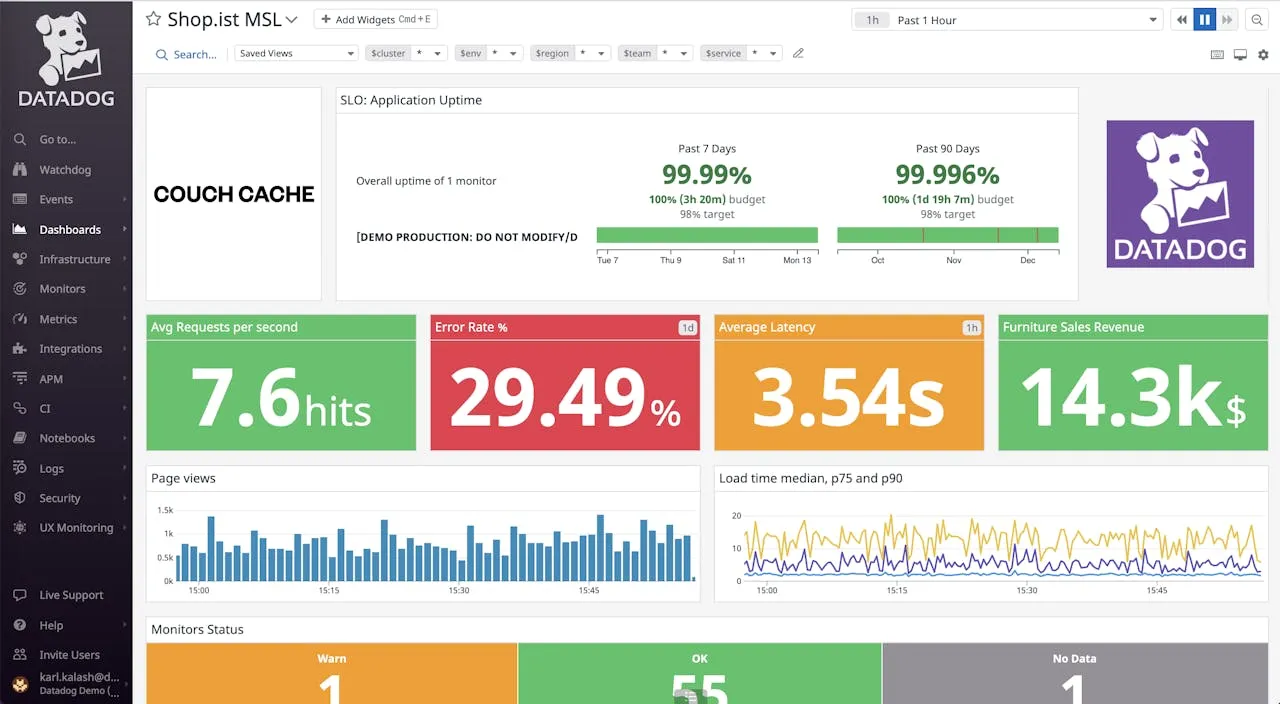
A Datadog continua sendo a plataforma mais abrangente para observabilidade em grande escala. Oferece mais de 600 integrações e consegue monitorar tudo, de um servidor físico no seu escritório a uma função serverless na nuvem.
Principais recursos
- Observabilidade full-stack: Correlação fluida entre métricas, traces e logs.
- Watchdog AI: Detecção de anomalias automatizada que frequentemente identifica problemas antes de você.
- 600+ integrações: Integrações point-and-click para AWS, Azure, GCP e ferramentas SaaS.
Prós
- Conjunto de recursos inigualável: APM profundo, segurança, RUM e monitoramento de rede sob o mesmo teto.
- Correlação excelente: Conectar um pico de latência a um trace ou linha de log específico é genuinamente rápido.
- UI polida: Intuitiva, rápida e genuinamente agradável de usar.
Contras
- Muito cara em escala: O preço por host é só a entrada; métricas customizadas, ingestão de logs e retenção somam rápido.
- Cobrança imprevisível: Telemetria de alto volume pode causar choque de preço se você não tomar cuidado.
Melhor para: Grandes empresas e tech companies de alto crescimento onde a velocidade de engenharia importa mais do que otimizar a conta de monitoramento.
Preço Infraestrutura começa em $15/host/mês. APM, logs ($0,10/GB indexados) e métricas customizadas são cobrados separadamente, muitas vezes dobrando o custo base em produção.
3. Prometheus & Grafana
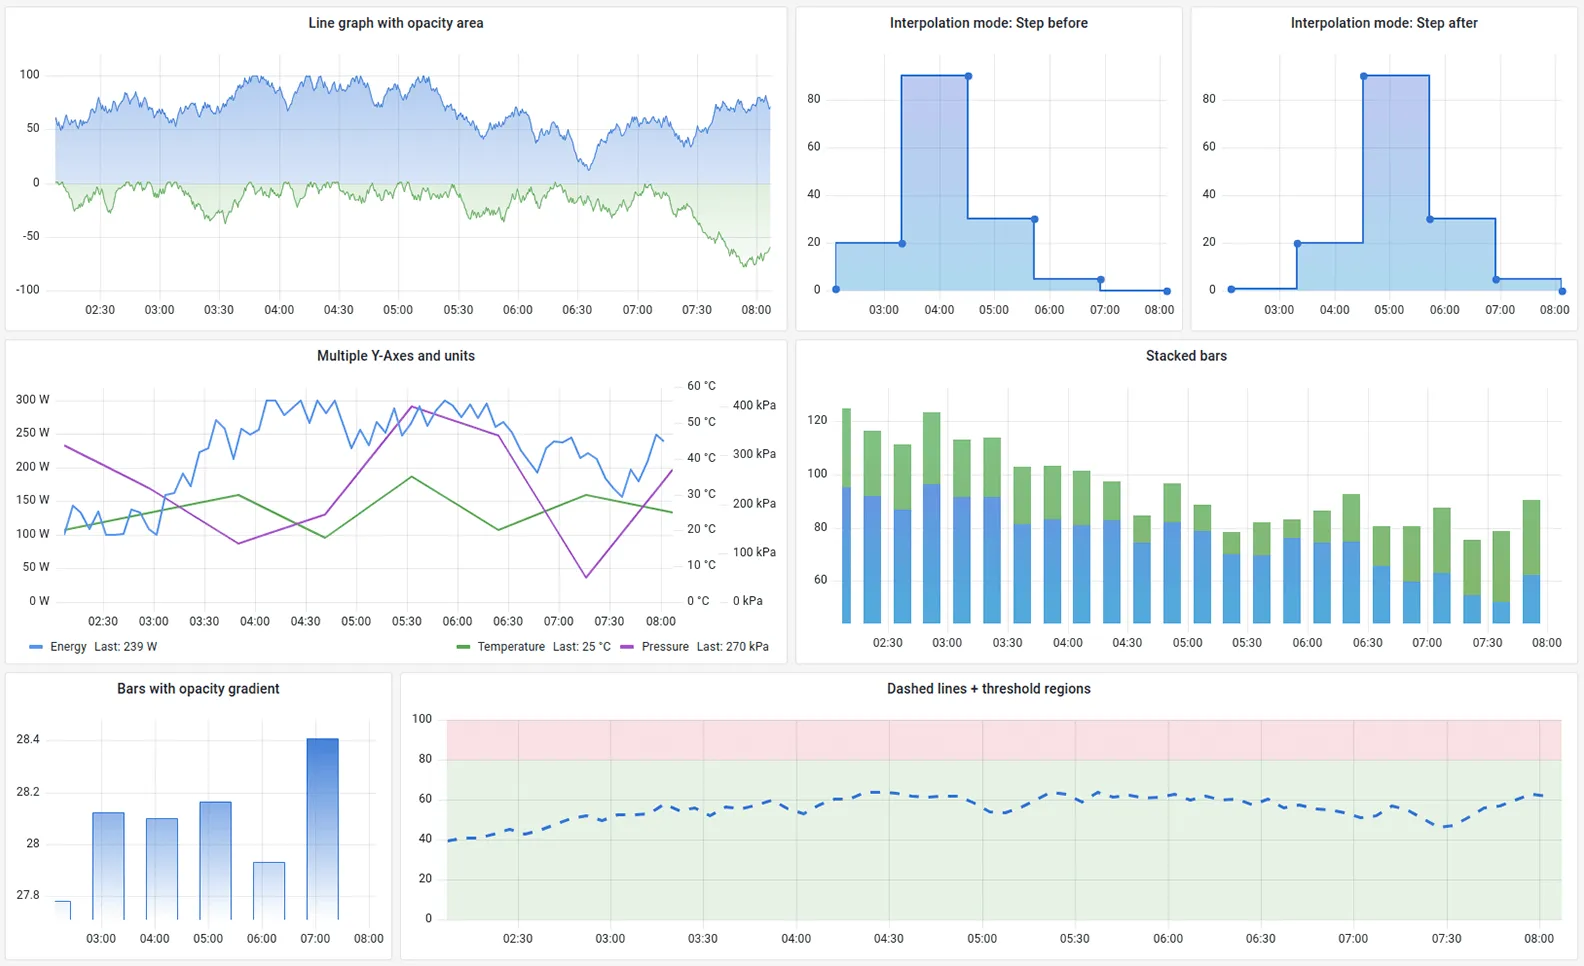
Prometheus combinado com Grafana é o padrão da indústria para monitoramento cloud-native. O Prometheus coleta métricas usando um modelo de pull, e o Grafana as visualiza por meio de uma poderosa camada de dashboards totalmente customizável.
Principais recursos
- PromQL: Uma poderosa linguagem de consulta multidimensional feita para infraestrutura moderna.
- Ecossistema enorme: Exporters disponíveis para quase qualquer software (Redis, Postgres, Nginx, etc.).
- Alertmanager: Lida com alertas com lógica sofisticada de roteamento e agrupamento.
Prós
- Padrão da indústria: A escolha de fato para monitoramento de Kubernetes.
- Open source: Totalmente gratuito para usar se self-hosted.
- Flexibilidade: Você constrói qualquer dashboard imaginável no Grafana.
Contras
- Alta carga de manutenção: Você precisa gerenciar armazenamento e escala (frequentemente exige Thanos ou Cortex).
- Sem suporte nativo a logs: O Prometheus é só métricas; você precisa adicionar Loki ou outra ferramenta para logs.
- Curva de aprendizado íngreme: PromQL leva tempo para dominar comparado a interfaces point-and-click.
Melhor para: Equipes com forte bagem DevOps que querem controle total sobre seus dados, especialmente em ambientes Kubernetes.
Preço Grátis (open source). Rodar em escala geralmente exige extensões de armazenamento pagas ou serviços gerenciados como Grafana Cloud ou Amazon Managed Prometheus, que são baseados em uso.
4. Zabbix
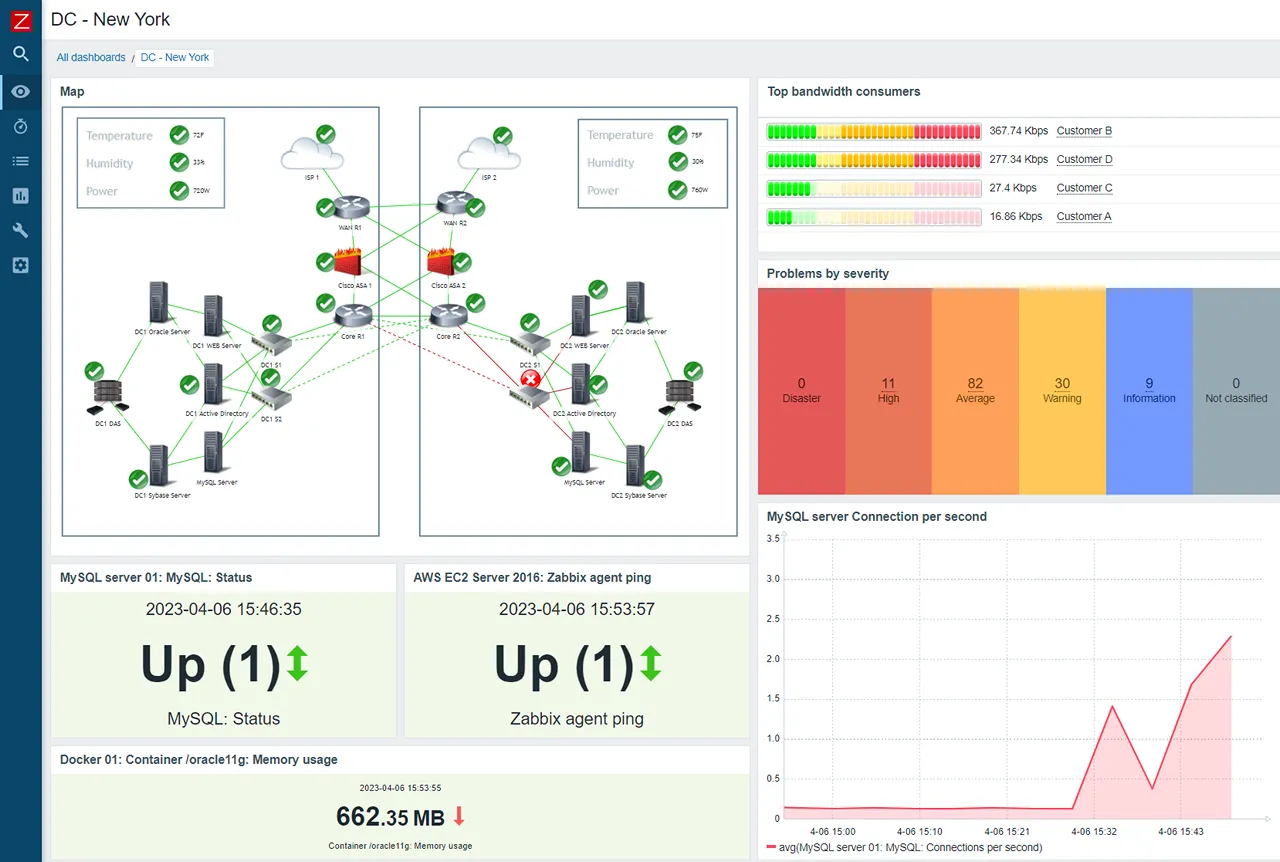
O Zabbix é uma plataforma open-source madura e de nível enterprise que se destaca em monitorar hardware de rede e servidores on-prem. É altamente escalável e consegue lidar com dezenas de milhares de dispositivos a partir de um único console.
Principais recursos
- Com e sem agente: Monitora via SNMP, JMX, IPMI e seu próprio agente leve.
- Push e pull: Suporta tanto polling quanto trapping como métodos de coleta de dados.
- Permissões granulares: Excelente multi-tenancy e controles de permissão de usuário.
Prós
- Completamente gratuito: O software em si não tem custo de licenciamento.
- Motor de alertas robusto: Expressões de trigger flexíveis e políticas de escalonamento.
- Comprovado em escala: Testado em batalha em ambientes enormes por décadas.
Contras
- UI defasada: A interface parece software enterprise de meados dos anos 2000.
- Alta sobrecarga de manutenção: Gerenciar o banco de dados subjacente (PostgreSQL/MySQL) pode virar um trabalho em tempo integral.
- Suporte limitado a cloud-native: Auto-scaling groups e pods efêmeros exigem regras de descoberta trabalhosas.
Melhor para: Data centers tradicionais, centros de operações de rede (NOCs) e ambientes pesados em rede.
Preço O software é open source. Implantações profissionais frequentemente usam o Zabbix Cloud, que começa em $50/mês. Suporte enterprise também é um serviço pago.
5. New Relic
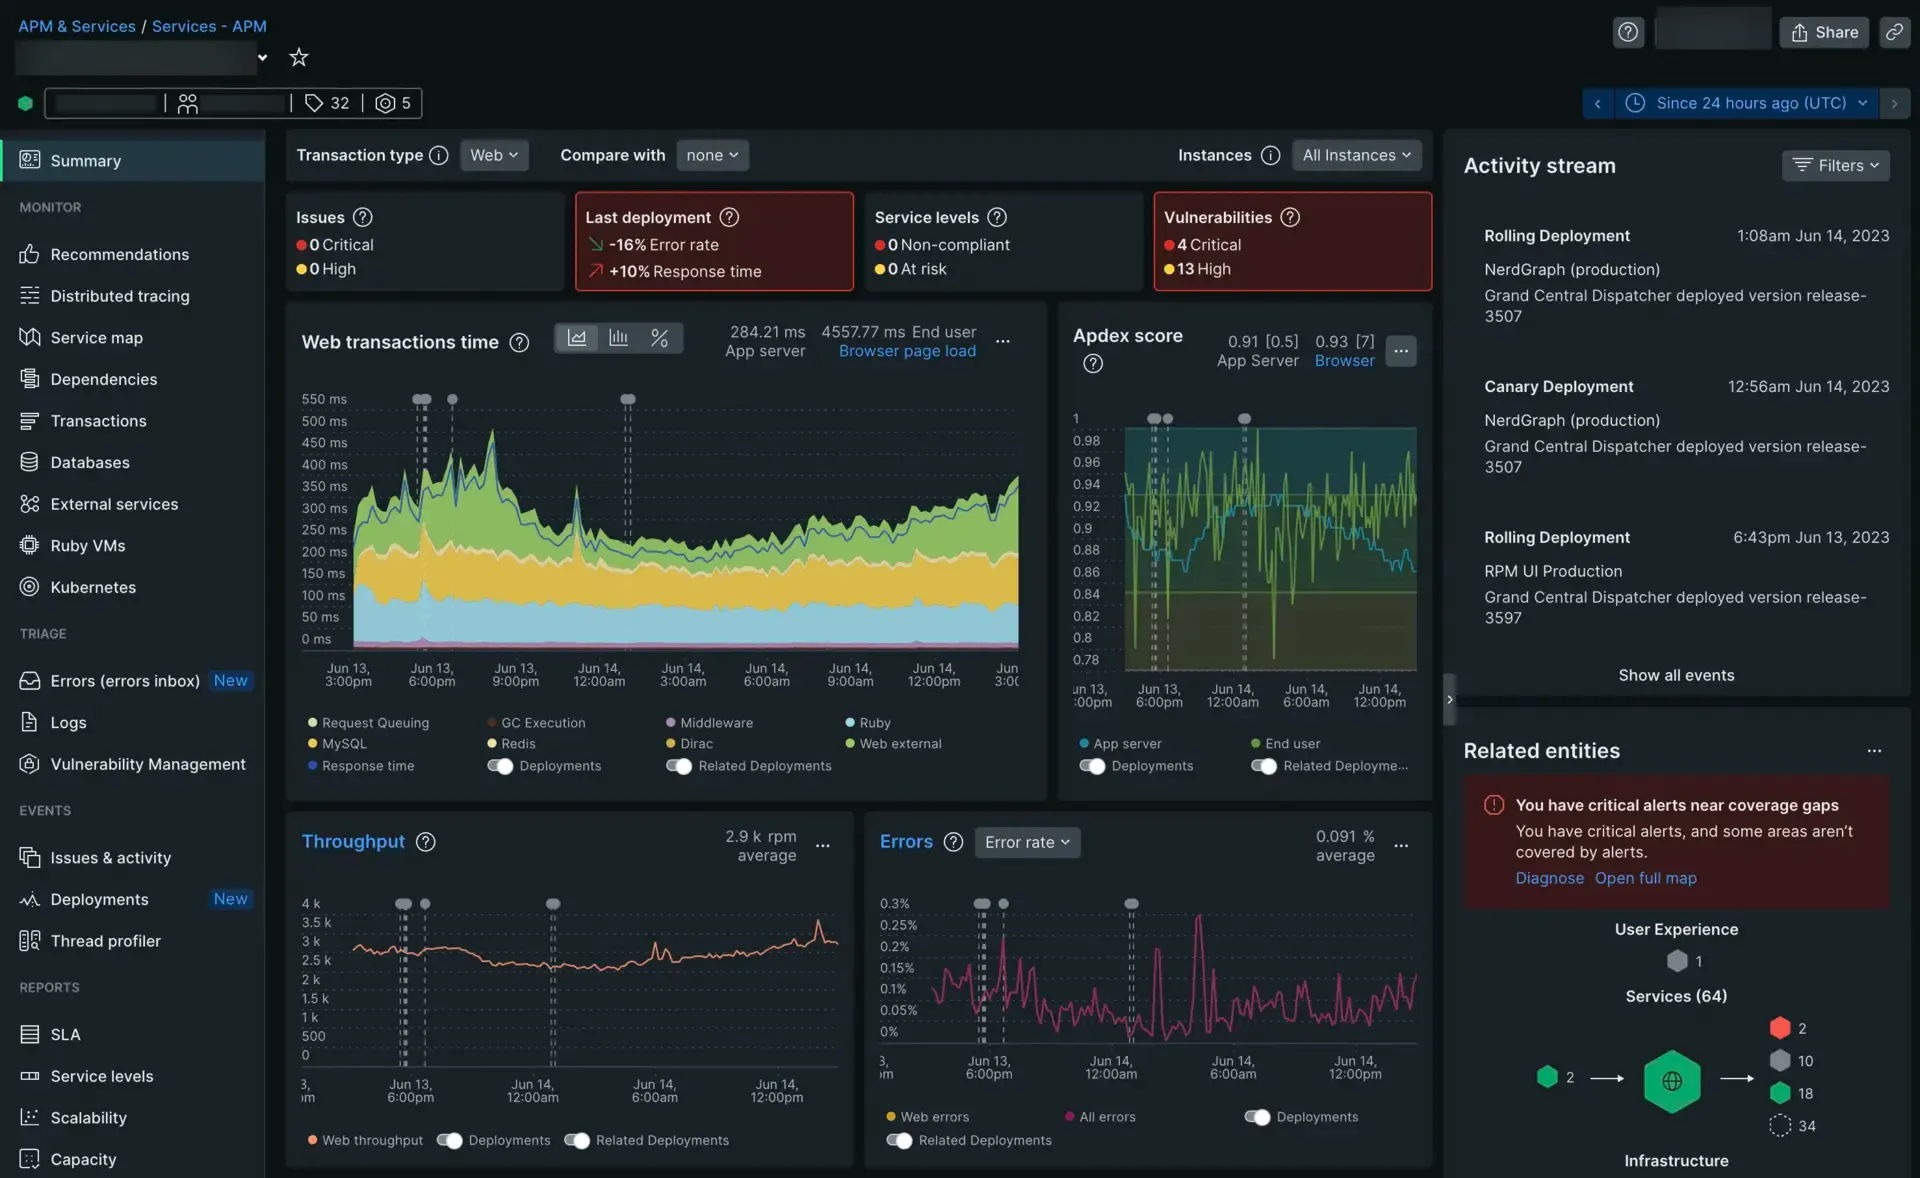
A New Relic migrou para um modelo de “plataforma de dados unificada”. Embora tenha começado como uma ferramenta de performance de aplicações, seu monitoramento de infraestrutura agora é tightly integrado, permitindo ver como a saúde do servidor afeta a latência do app diretamente.
Principais recursos
- APM profundo: Tracing em nível de código para identificar queries de banco lentas ou funções ineficientes.
- Browser e mobile: Suporte nativo para rastrear a experiência do usuário final em apps web e mobile.
- Inteligência aplicada: Insights orientados por IA para detectar anomalias e correlacionar eventos na sua stack.
Prós
- Visibilidade all-in-one: Métricas, logs e traces armazenados num só lugar.
- Free tier generoso: 100 GB/mês grátis para equipes pequenas.
- Capacidades de query fortes: NRQL é poderoso e acessível.
Contras
- UI esmagadora: A plataforma é vasta, e navegar nela pode ser frustrante para necessidades simples.
- Preço por usuário: Assentos de Platform User completos ficam caros conforme sua equipe cresce.
Melhor para: Equipes focadas em aplicações que querem uma única ferramenta para a stack inteira, especialmente onde APM importa.
Preço Baseado em uso: grátis para 100 GB/mês. Planos pagos começam em $0,30/GB ingeridos mais taxas de assento por usuário ($99/mês para Core, $549/mês para Full Platform).
6. LogicMonitor
O LogicMonitor é uma plataforma de monitoramento SaaS, sem agente. É feita para ser fácil de implantar em ambientes híbridos, usando um “Collector” que fica na sua rede e escaneia dispositivos automaticamente.
Principais recursos
- Deploy sem agente: Um único Collector por segmento de rede cuida de descoberta e coleta.
- Dashboards out-of-the-box: Dashboards pré-construídos para a maioria dos componentes comuns de infraestrutura.
- Detecção inteligente de anomalias: Thresholds dinâmicos que se adaptam aos padrões da sua carga de trabalho.
Prós
- Deploy conveniente: Sem instalação de agente por host.
- Ótimos dashboards OOTB: Tempo até valor mais rápido que a maioria das alternativas self-hosted.
- Forte suporte híbrido: Lida com ativos on-prem e cloud no mesmo console.
Contras
- Cara para ambientes menores: O preço é difícil de justificar abaixo de uma certa escala.
- Customização limitada: Menos flexível que ferramentas open-source para requisitos específicos.
Melhor para: Empresas do mid-market com um mix de infraestrutura cloud e física que querem a conveniência SaaS sem proliferação de agentes.
Preço Preço sob consulta. Contate a LogicMonitor para um orçamento.
7. Checkmk
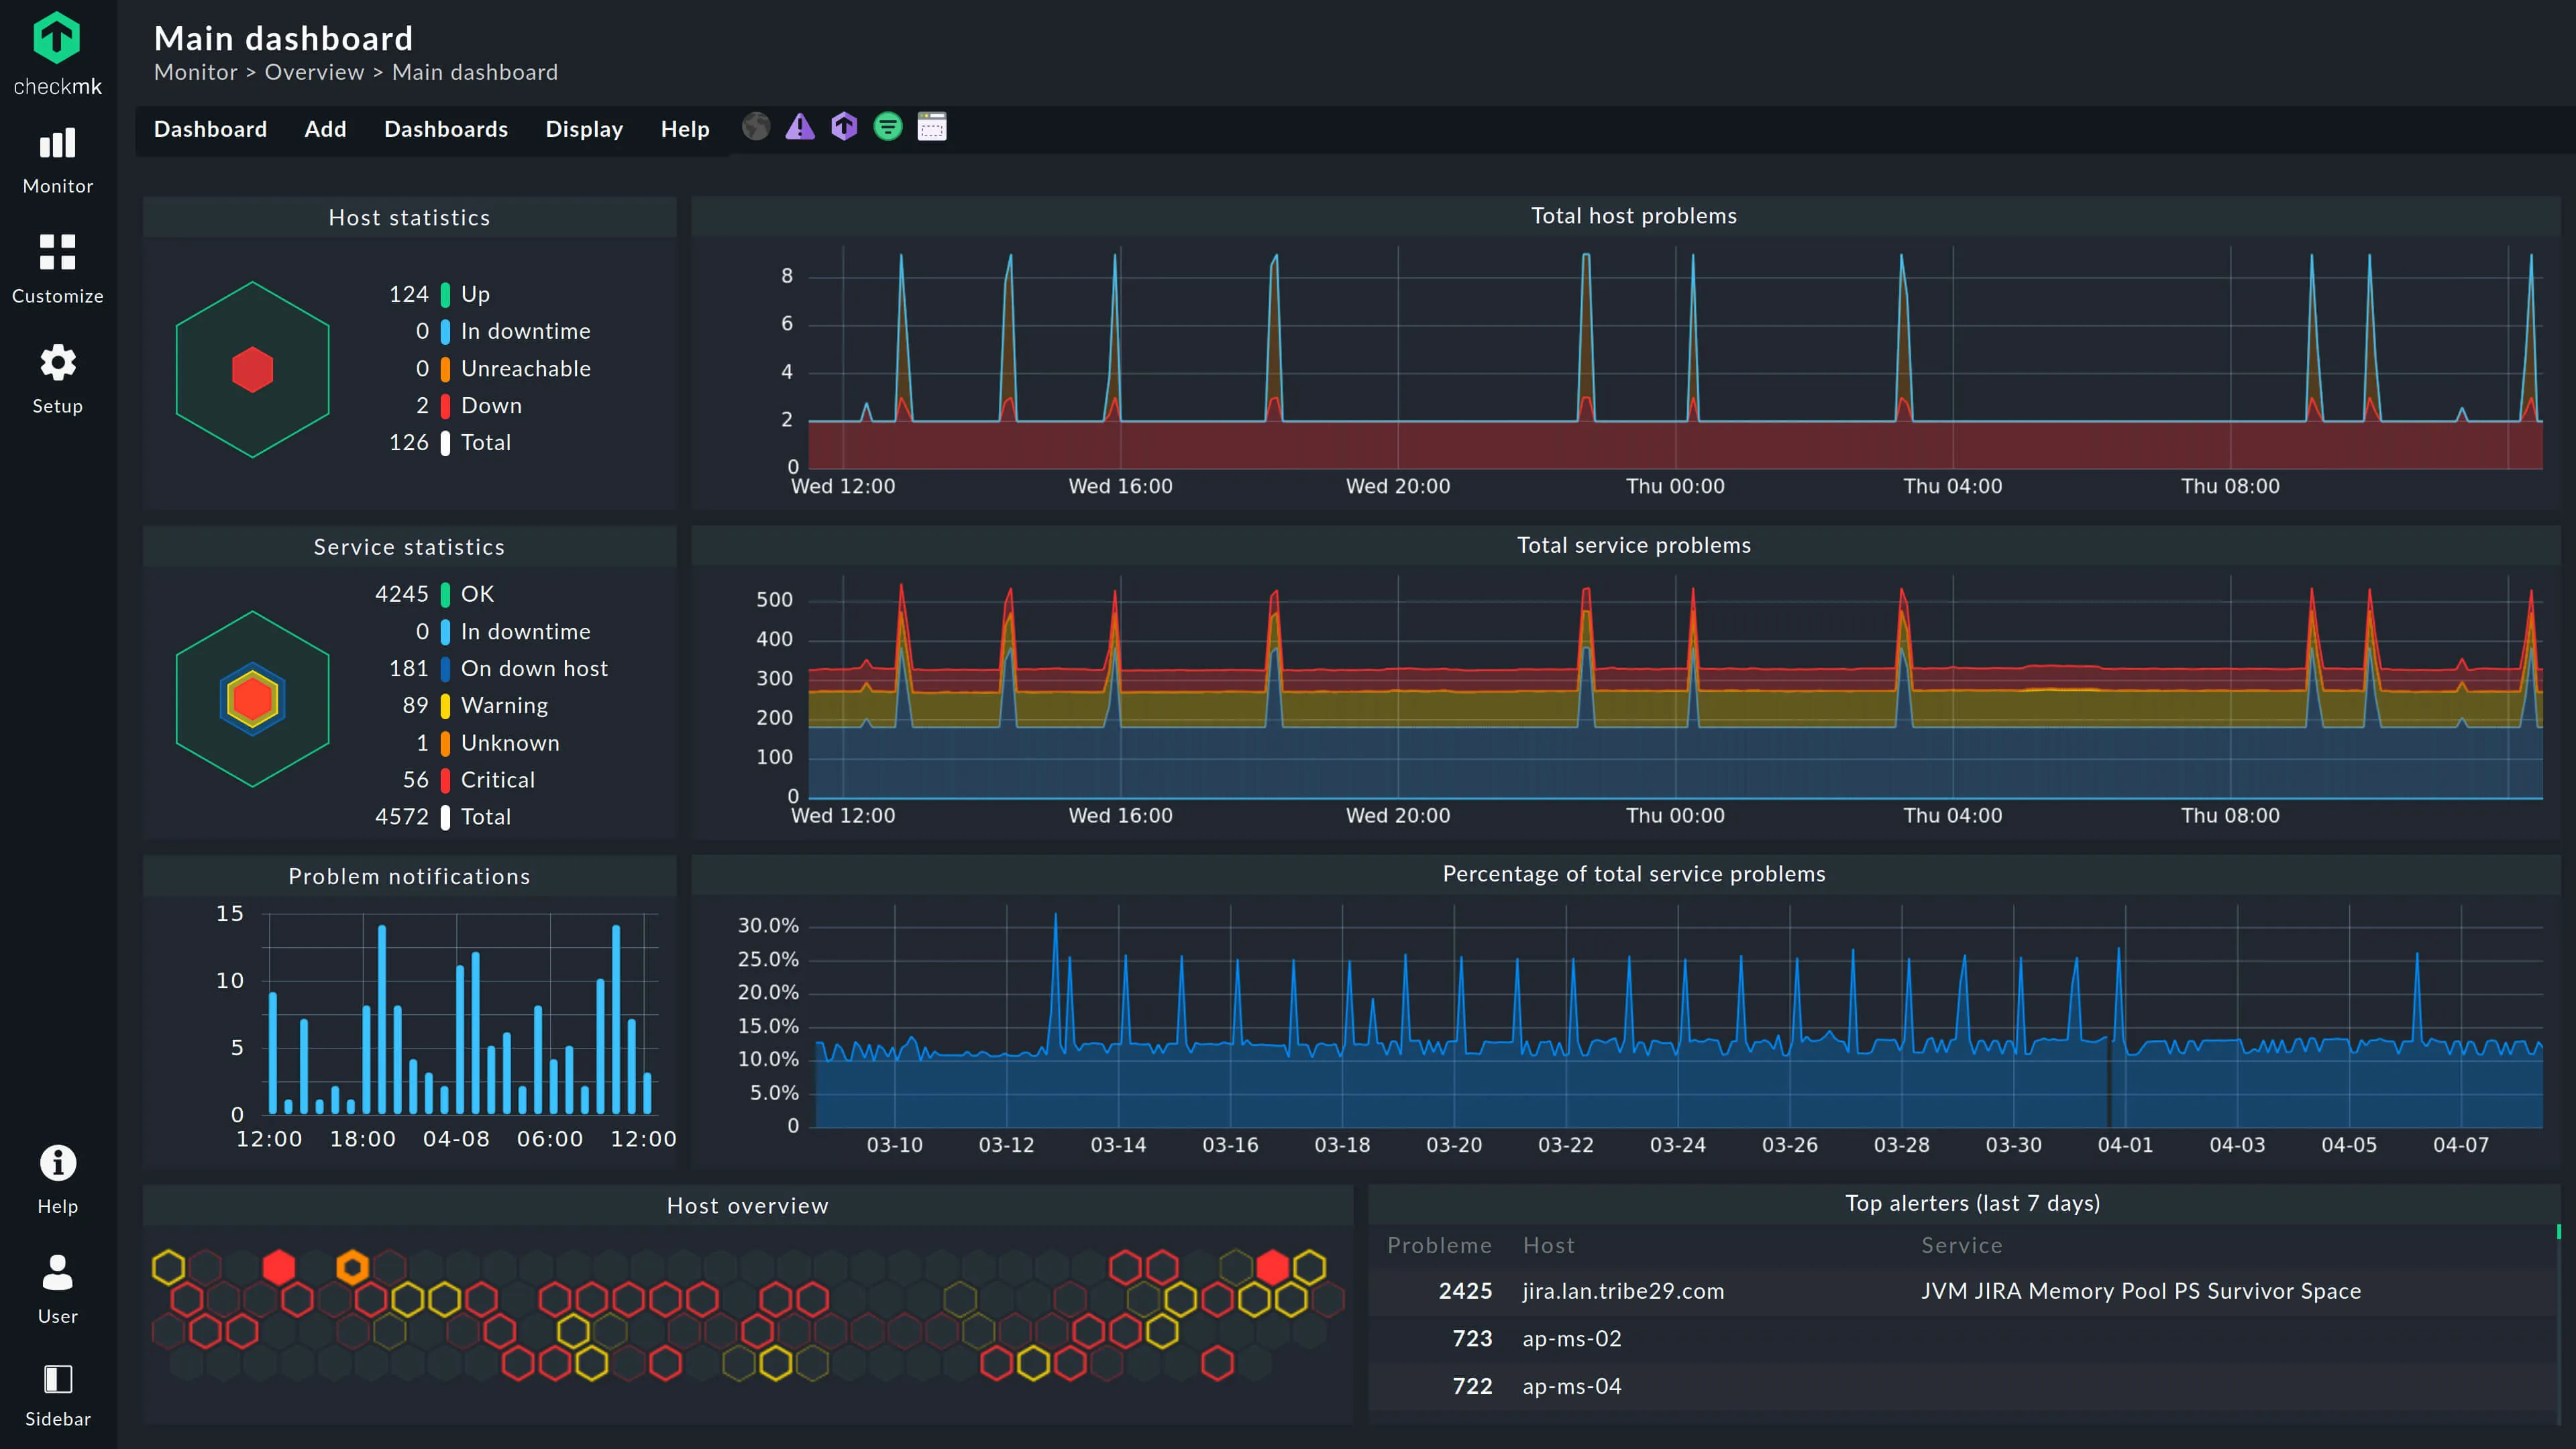
O Checkmk é conhecido pelo seu motor de monitoramento incrivelmente eficiente. Consegue monitorar milhares de serviços com uso de CPU muito baixo e é particularmente popular em ambientes em conformidade com ITIL na Europa.
Principais recursos
- Descoberta automática de serviços: Escaneia hosts para encontrar serviços em execução e configurar checks automaticamente.
- 2.000+ plugins: Biblioteca gigante de integrações incluindo hardware, portas de switch e sistemas SAP.
- Monitoramento híbrido: Igualmente bom em bare metal, containers e instâncias cloud.
Prós
- Núcleo eficiente: Muito menos intensivo em recursos que Nagios ou Zabbix no mesmo volume de checks.
- All-in-one: Lida tanto com monitoramento baseado em estado (Up/Down) quanto em performance de métricas.
- Comunidade ativa: O Checkmk Exchange oferece centenas de extensões da comunidade.
Contras
- UI defasada: Funcional, mas parece congestionada comparada a ferramentas SaaS modernas.
- Curva de aprendizado íngreme: O modelo de configuração baseado em regras leva tempo para internalizar.
Melhor para: Monitoramento de alta densidade onde eficiência é a prioridade, e sysadmins que gerenciam um mix de hardware legado e containers modernos.
Preço A edição open source é gratuita. Enterprise começa em ~$2.100/ano para 3.000 serviços. Edições SaaS começam em ~$6/host/mês.
8. Site24x7
O Site24x7 (da Zoho) oferece um amplo conjunto de ferramentas de monitoramento: uptime de sites, monitoramento de servidores, rastreamento de rede e mais. É uma solução cloud-based muito fácil de começar a usar.
Principais recursos
- Cobertura ampla: Monitora servidores, sites (Synthetics), redes e apps mobile a partir de um só lugar.
- RUM e Synthetics: Monitoramento de usuário real e checks de transações sintéticas embutidos.
- Bundles acessíveis: Preço estruturado em bundles em vez de cobrança por métrica.
Prós
- Muito acessível: Uma das opções all-in-one mais custo-efetivas do mercado.
- Fácil de configurar: Configuração mínima para começar.
- Conjunto amplo de recursos: Cobrem muito terreno sem precisar de várias ferramentas.
Contras
- Menos profundidade: Não tão especializada ou customizável quanto ferramentas dedicadas de monitoramento.
- UI congestionada: A interface pode parecer esmagadora dada a amplitude de recursos.
Melhor para: Pequenas e médias empresas que precisam de uma solução SaaS simples e acessível cobrindo múltiplas necessidades de monitoramento.
Preço Planos começam a partir de $9/mês. O preço depende do número de monitores e da retenção de dados escolhida.
9. Netdata
O Netdata é único porque oferece granularidade por segundo out-of-the-box. É feito para ser instalado em cada servidor para dar a você uma visão imediata e de alta resolução do que está acontecendo agora.
Principais recursos
- Resolução de 1 segundo: Métricas em tempo real com quase nenhuma latência da coleta à visualização.
- ML não supervisionado: Detecção de anomalias embutida que sinaliza outliers sem thresholds manuais.
- Auto-discovery: Detecta automaticamente serviços e apps rodando no host.
Prós
- Zero configuração: Instale e receba gráficos em tempo real lindos imediatamente.
- Sobrecarga incrivelmente baixa: Leve o suficiente para rodar em hardware restrito.
- Grátis e open source: O produto principal não custa nada para self-host.
Contras
- Centrado em nó por design: Historicamente melhor em monitorar nós individuais do que fornecer uma visão global da infraestrutura (embora o Netdata Cloud esteja melhorando isso).
- Sem tracing nativo: Principalmente uma ferramenta de métricas; logs são uma adição mais recente, ainda em maturação.
Melhor para: Troubleshooting em tempo real e ajuste fino de performance de baixo nível em hosts individuais.
Preço Open source (grátis, self-hosted). O Netdata Cloud tem um free tier e planos pagos para gerenciamento centralizado.
10. Nagios XI
O Nagios é o “avô” do monitoramento. O Nagios XI é a versão comercial que adiciona uma interface web e configuração mais fácil ao motor principal, apoiado pelo maior ecossistema de plugins do mundo.
Principais recursos
- Biblioteca gigante de plugins: Se tem um endereço IP, quase certamente existe um plugin de Nagios para ele.
- Alertas de estado binário: Lógica de alerta OK/CRITICAL/WARNING sólida como rocha.
- Assistentes de configuração: O XI adiciona setup point-and-click sobre o motor Nagios principal.
Prós
- Compatibilidade universal: Monitora virtualmente qualquer dispositivo, protocolo ou serviço.
- Confiabilidade comprovada: Tecnologia extremamente estável com décadas de uso em produção.
Contras
- Exige expertise significativa: Configurar e manter o Nagios adequadamente é um desafio técnico.
- Arquitetura defasada: Parece antiquado comparado a ferramentas SaaS modernas ou cloud-native.
- Métricas em segundo plano: O Nagios é fundamentalmente uma ferramenta de checagem de status, não uma plataforma de gráficos.
Melhor para: Organizações com requisitos de monitoramento altamente específicos ou legados, ou ambientes onde só existe um plugin de Nagios para um determinado hardware.
Preço O Nagios Core é gratuito (open source). O Nagios XI começa em $2.495 para uma licença padrão (até 100 nós).
Como escolher a solução certa
A melhor solução de monitoramento de infraestrutura de TI é aquela que sua equipe vai realmente usar e manter. Comece auditando duas coisas: quantos nós cloud vs. on-prem você tem, e quanto tempo sua equipe consegue realisticamente dedicar à manutenção da ferramenta.
Se você tem um orçamento grande e uma equipe dedicada de observabilidade, Datadog ou Prometheus são excelentes escolhas. Se você é uma equipe menor, ou está cansado de gastar fins de semana consertando sua stack de monitoramento, incline-se para opções zero-config como a Simple Observability ou ferramentas SaaS como LogicMonitor ou Site24x7.
A ferramenta certa deve parecer um multiplicador de força, não mais uma tarefa na sua lista de afazeres.