



Encontrar una herramienta de monitorización que cubra todo tu stack sin crear un segundo trabajo para tu equipo es más difícil de lo que parece. Aquí están las 10 mejores soluciones comparadas. Para conocer el contexto de lo que estás monitorizando, consulta nuestra guía de infraestructura de servidores y las mejores prácticas de paneles de monitorización de infraestructura.
La mayoría de los proyectos de monitorización de infraestructura fracasan no porque a la herramienta le faltaran características, sino porque al equipo le faltó tiempo para mantenerla. En 2026, la brecha entre los sistemas cloud-native y el hardware legacy on-premise es más amplia que nunca. Necesitas una solución que cierre esta brecha manteniendo la configuración al mínimo.
El mercado está dividido entre gigantes enterprise que cuestan una fortuna y herramientas de código abierto que requieren un esfuerzo manual significativo. Esta lista se centra en las herramientas que ofrecen el mejor “tiempo hasta la visibilidad” en entornos híbridos.
¿Qué hace a una solución moderna de monitorización de infraestructura IT?
Una solución moderna debe ir más allá de los simples pings ICMP. Necesita correlacionar métricas, logs y trazas en una sola vista para reducir el tiempo medio hasta la resolución (MTTR).
En 2026, los requisitos imprescindibles son autodescubrimiento, agentes ligeros y soporte híbrido. Si tienes que actualizar manualmente tu monitorización cada vez que levantas una instancia en la nube, tu solución ya está desactualizada.
Resumen rápido
| Herramienta | Mejor para | Modelo de precio |
|---|---|---|
| Simple Observability | Simplicidad y sin configuración | $3 / mes / servidor |
| Datadog | Enterprise / Nube | $15+ / host / mes |
| Prometheus y Grafana | Cloud nativo / K8s | Gratis (OSS) / Gestionado de pago |
| Zabbix | Red / On-premise | $50 / mes (Cloud) |
| New Relic | Rendimiento de apps (APM) | Basado en uso ($0.30/GB) |
| LogicMonitor | Híbrido / Mid-market | Personalizado |
| Checkmk | IT complejo / Híbrido | ~$6 / host / mes |
| Site24x7 | PYME / SaaS | Desde $9 / mes |
| Netdata | Solución de problemas en tiempo real | Gratis (OSS) / Cloud de pago |
| Nagios XI | Entornos legacy | $2,495+ (licencia) |
10 mejores soluciones de monitorización de infraestructura IT
1. Simple Observability
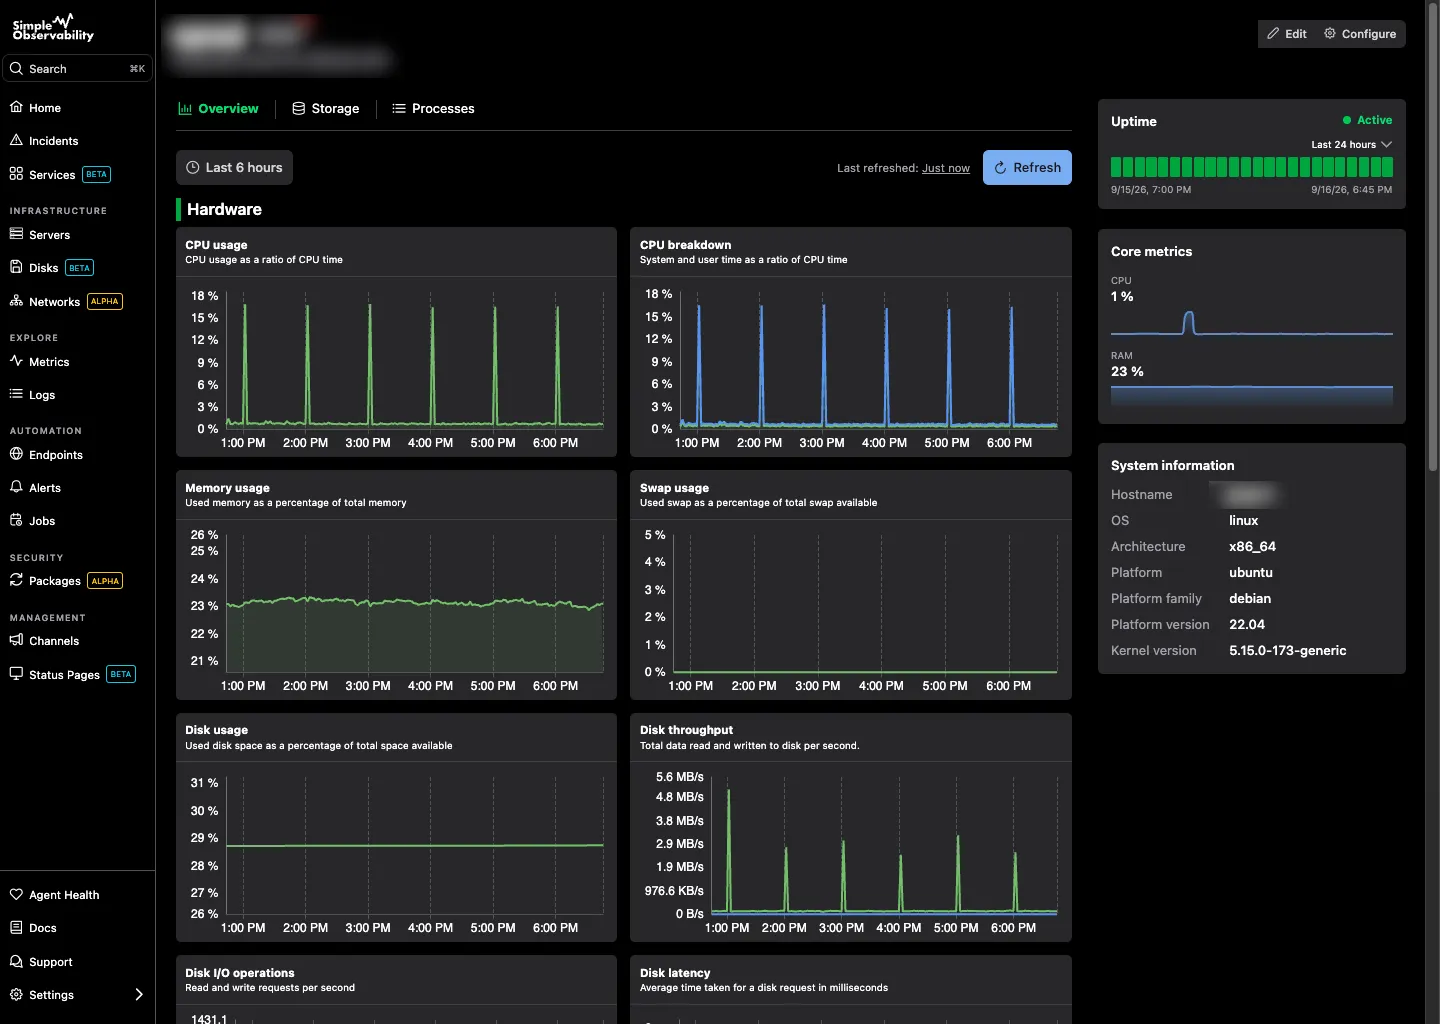
Simple Observability está construida para equipos que quieren visibilidad de nivel enterprise sin la configuración de nivel enterprise. Un único agente binario ligero autodescubre servicios y comienza a reportar datos inmediatamente, sin necesidad de pelearse con YAML.
Características clave
- Instalación con un comando: Sin configuración compleja del agente. Obtienes monitorización de CPU, memoria, disco y uptime al instante.
- Logs y métricas unificados: Visualiza logs de aplicación junto a métricas del servidor en el mismo panel.
- Alertas sin configuración: Valores predeterminados sensatos desde el inicio para que estés protegido desde el día uno.
- Conveniencia SaaS: Sin base de datos de métricas ni stack de retención que alojar.
Ventajas
- Configuración extremadamente rápida: Visibilidad inmediata sin configuración manual de paneles.
- Precio predecible: Tarifa plana por servidor, sin sorpresas de “por millón de métricas personalizadas”.
- Correlaciona logs y métricas por defecto: No necesitas coser herramientas separadas.
Desventajas
- Menos plugins especializados: Gigantes legacy como Nagios tienen un ecosistema de plugins más amplio.
Mejor para: Equipos que necesitan visibilidad inmediata en activos híbridos de nube y on-premise.
Precio
- Gratis: $0 por 1 servidor.
- De pago: $3/mes por servidor para servidores ilimitados.
- Personalizado: Descuentos por volumen para flotas grandes.
2. Datadog
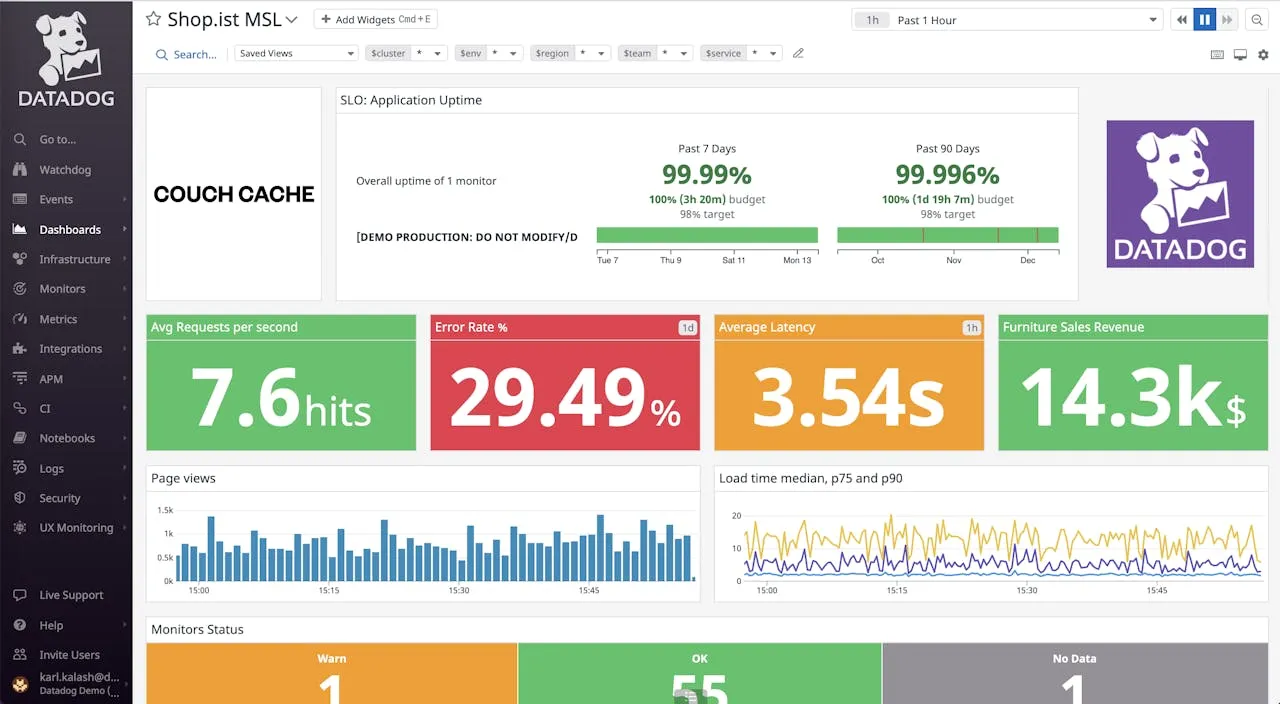
Datadog sigue siendo la plataforma más completa para observabilidad a gran escala. Ofrece más de 600 integraciones y puede monitorizar desde un servidor físico en tu oficina hasta una función serverless en la nube.
Características clave
- Observabilidad full-stack: Correlación fluida entre métricas, trazas y logs.
- Watchdog AI: Detección automatizada de anomalías que a menudo detecta problemas antes que tú.
- 600+ integraciones: Integraciones de apuntar y hacer clic para AWS, Azure, GCP y herramientas SaaS.
Ventajas
- Conjunto de características inigualable: APM profundo, seguridad, RUM y monitorización de red bajo un mismo techo.
- Excelente correlación: Conectar un pico de latencia con una traza o línea de log específica es genuinamente rápido.
- Interfaz pulida: Intuitiva, rápida y genuinamente agradable de usar.
Desventajas
- Muy caro a escala: El precio por host es solo el boleto de entrada; métricas personalizadas, ingesta de logs y retención se suman rápidamente.
- Facturación impredecible: La telemetría de alto volumen puede causar un susto en la factura si no tienes cuidado.
Mejor para: Grandes empresas y compañías tecnológicas de alto crecimiento donde la velocidad de ingeniería importa más que optimizar la factura de monitorización.
Precio Infraestructura comienza en $15/host/mes. APM, logs ($0.10/GB indexados) y métricas personalizadas se facturan por separado, a menudo duplicando el coste base en producción.
3. Prometheus y Grafana
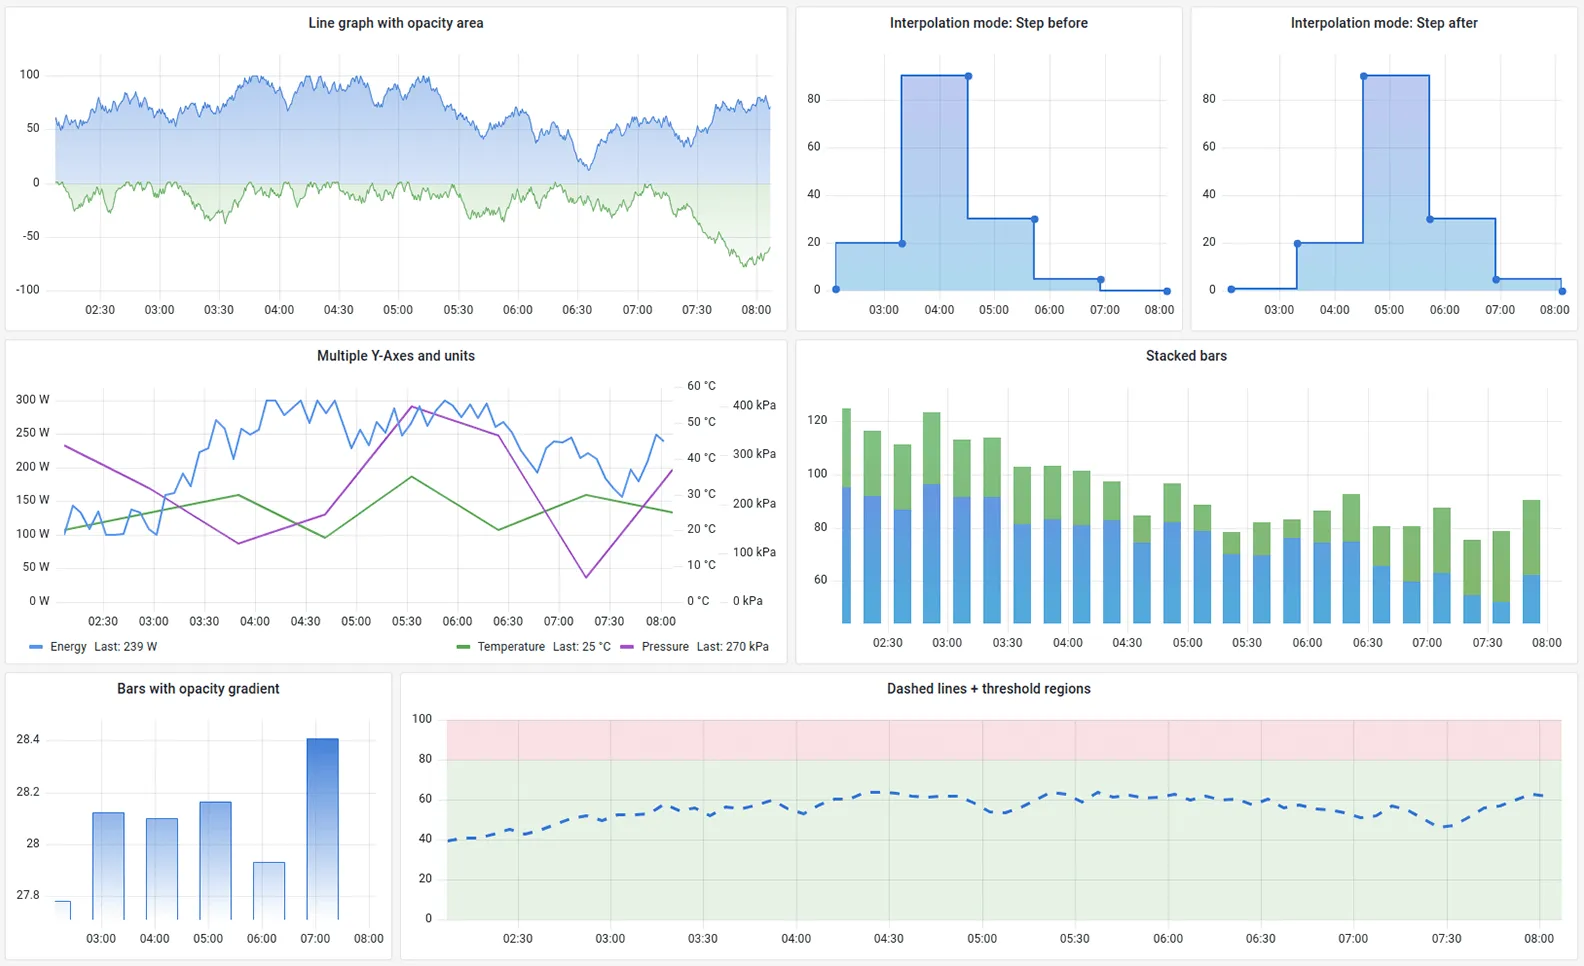
Prometheus junto con Grafana es el estándar de la industria para monitorización cloud-native. Prometheus recopila métricas usando un modelo pull y Grafana las visualiza a través de una capa de paneles potente y totalmente personalizable.
Características clave
- PromQL: Un lenguaje de consulta multidimensional potente construido para infraestructura moderna.
- Ecosistema enorme: Exportadores disponibles para casi cualquier software (Redis, Postgres, Nginx, etc.).
- Alertmanager: Maneja alertas con una lógica sofisticada de enrutamiento y agrupación.
Ventajas
- Estándar de la industria: La opción de facto para monitorización de Kubernetes.
- Código abierto: Completamente gratis si se autoaloja.
- Flexibilidad: Puedes construir cualquier panel imaginable en Grafana.
Desventajas
- Alta carga de mantenimiento: Debes gestionar el almacenamiento y la escalabilidad tú mismo (a menudo requiere Thanos o Cortex).
- Sin soporte nativo de logs: Prometheus es solo para métricas; necesitas añadir Loki u otra herramienta para logs.
- Curva de aprendizaje pronunciada: PromQL lleva tiempo dominarlo comparado con interfaces de apuntar y hacer clic.
Mejor para: Equipos con sólidas habilidades DevOps que quieren control total sobre sus datos, especialmente entornos Kubernetes.
Precio Gratis (código abierto). Ejecutar a escala usualmente requiere extensiones de almacenamiento de pago o servicios gestionados como Grafana Cloud o Amazon Managed Prometheus, que son basados en uso.
4. Zabbix
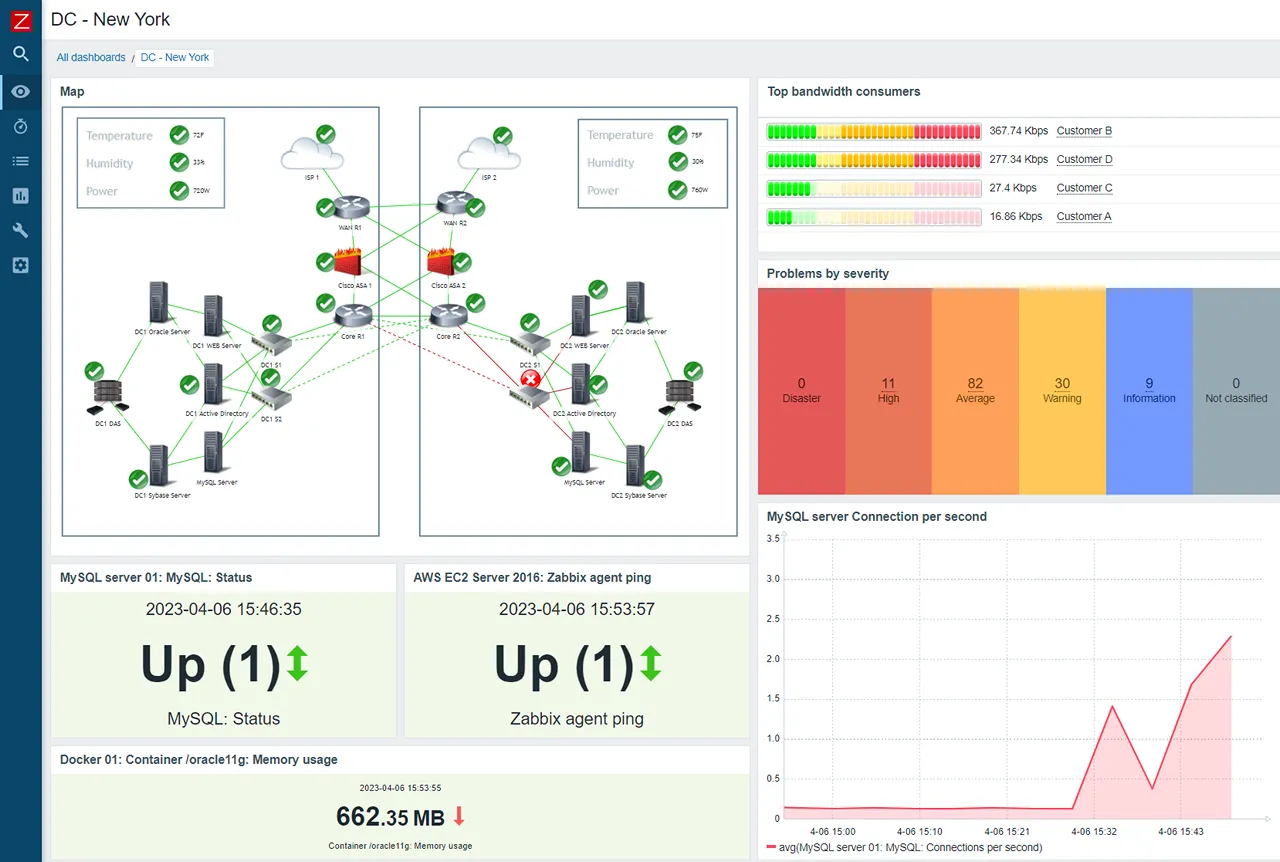
Zabbix es una plataforma de código abierto madura y de nivel empresarial que destaca en la monitorización de hardware de red y servidores on-premise. Es altamente escalable y puede manejar decenas de miles de dispositivos desde una sola consola.
Características clave
- Con agente y sin agente: Monitorización vía SNMP, JMX, IPMI y su propio agente ligero.
- Push y pull: Soporta tanto métodos de recopilación de datos por polling como por trapping.
- Permisos granulares: Excelente multi-tenencia y controles de permisos de usuario.
Ventajas
- Completamente gratis: El software en sí no tiene coste de licencia.
- Motor de alertas robusto: Expresiones de trigger flexibles y políticas de escalado.
- Probado a escala: Probado en batalla en entornos masivos durante décadas.
Desventajas
- Interfaz anticuada: La interfaz se siente como software enterprise de mediados de los 2000.
- Alta sobrecarga de mantenimiento: Gestionar la base de datos subyacente (PostgreSQL/MySQL) puede convertirse en un trabajo a tiempo completo.
- Soporte cloud-native limitado: Los grupos de autoescalado y pods efímeros requieren reglas de descubrimiento engorrosas.
Mejor para: Centros de datos tradicionales, centros de operaciones de red (NOCs) y entornos con mucha carga de red.
Precio El software es de código abierto. Los despliegues profesionales a menudo usan Zabbix Cloud, que comienza en $50/mes. El soporte enterprise también es un servicio de pago.
5. New Relic
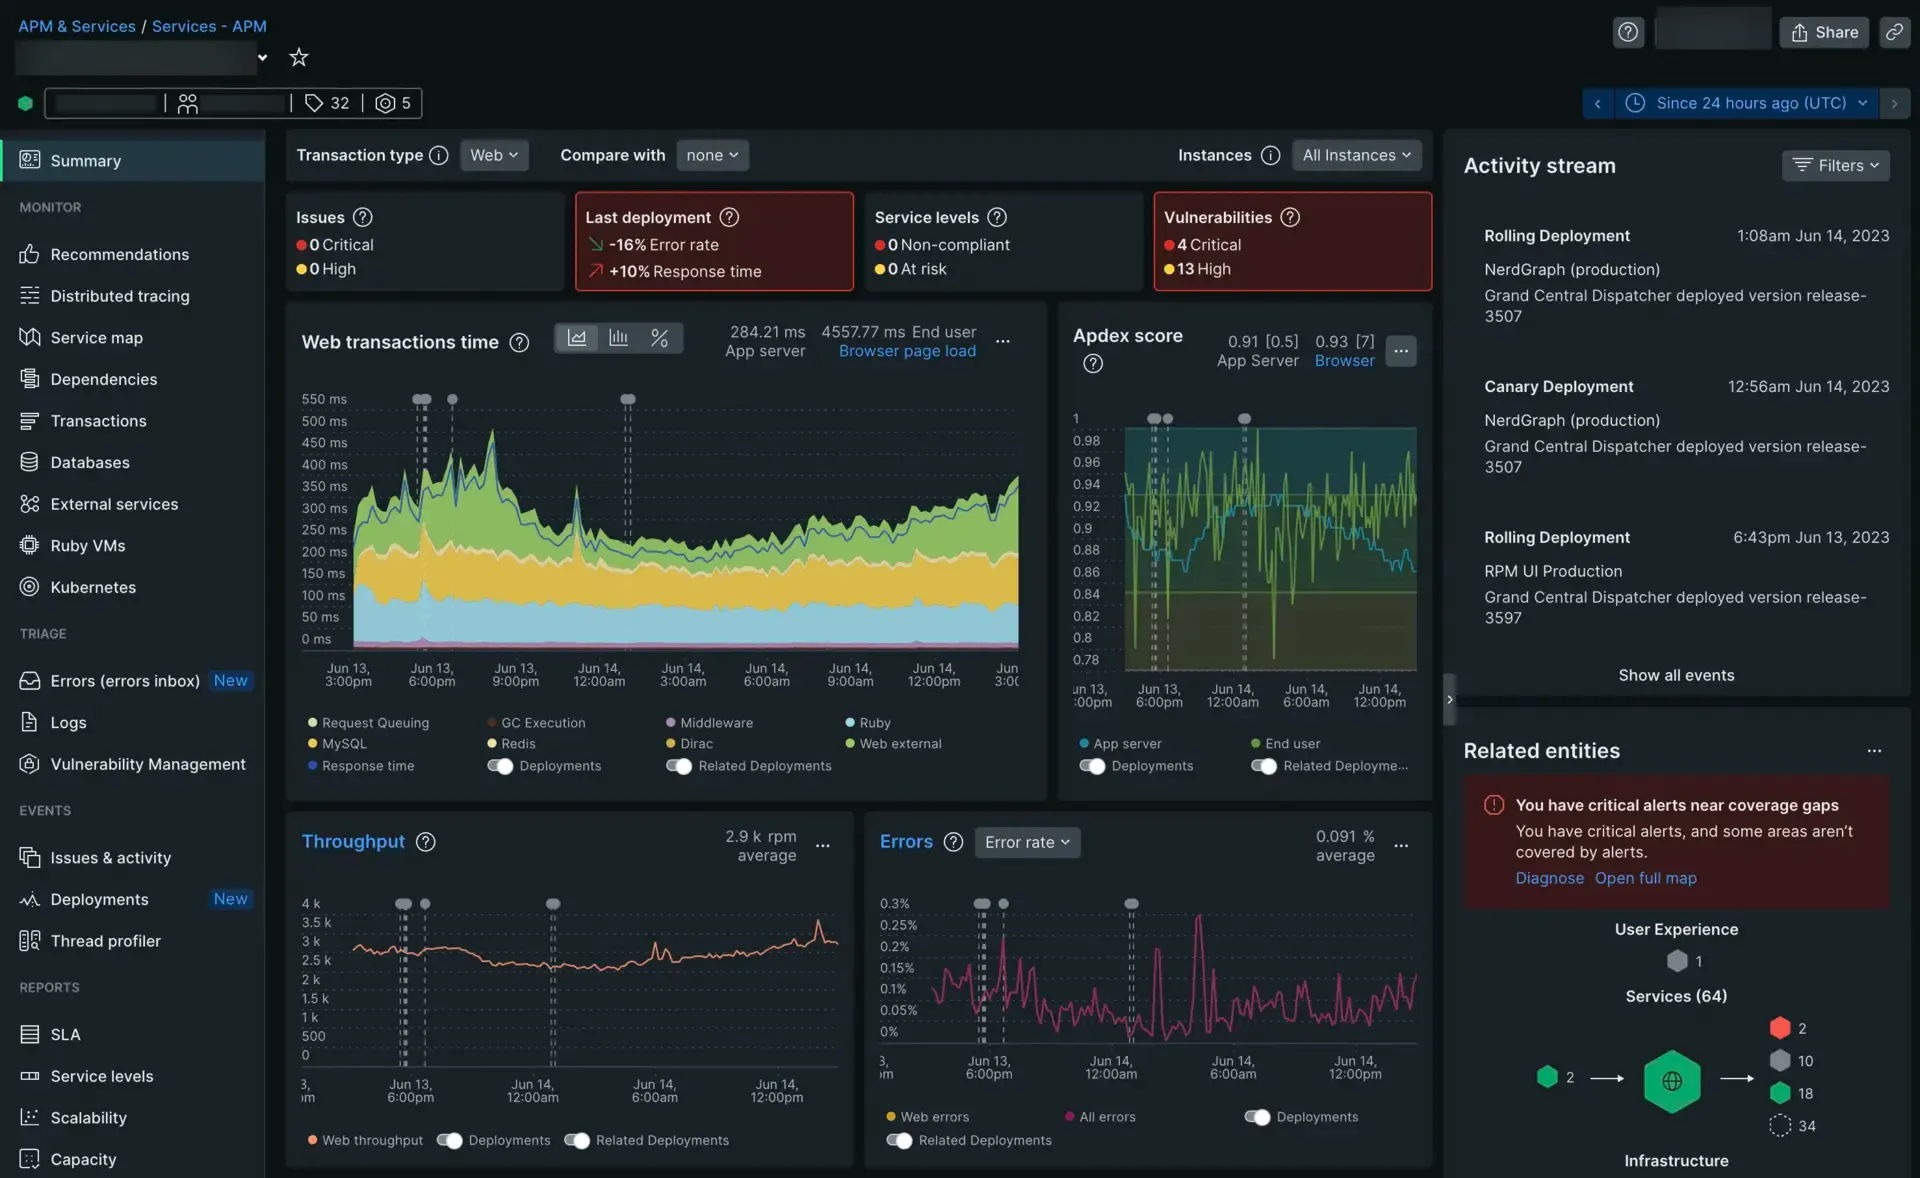
New Relic ha pasado a un modelo de “plataforma de datos unificada”. Aunque empezó como una herramienta de rendimiento de aplicaciones, su monitorización de infraestructura ahora está estrechamente integrada, permitiéndote ver cómo la salud del servidor afecta la latencia de la app directamente.
Características clave
- APM profundo: Trazado a nivel de código para identificar consultas de base de datos lentas o funciones ineficientes.
- Navegador y móvil: Soporte nativo para rastrear la experiencia del usuario final en apps web y móviles.
- Inteligencia aplicada: Información impulsada por IA para detectar anomalías y correlacionar eventos en todo tu stack.
Ventajas
- Visibilidad todo en uno: Métricas, logs y trazas almacenados en un solo lugar.
- Nivel gratuito generoso: 100 GB/mes gratis para equipos pequeños.
- Capacidades de consulta potentes: NRQL es potente y accesible.
Desventajas
- Interfaz abrumadora: La plataforma es vasta y navegarla puede ser frustrante para necesidades simples.
- Precio por usuario: Los asientos de Full Platform User son caros a medida que tu equipo crece.
Mejor para: Equipos enfocados en aplicaciones que quieren una sola herramienta para todo el stack, especialmente donde APM importa.
Precio Basado en uso: gratis para 100 GB/mes. Los planes de pago comienan en $0.30/GB ingeridos más tarifas por asiento de usuario ($99/mes para Core, $549/mes para Full Platform).
6. LogicMonitor
LogicMonitor es una plataforma de monitorización SaaS sin agente. Está diseñada para ser fácil de desplegar en entornos híbridos, usando un “Collector” que se ubica en tu red y escanea dispositivos automáticamente.
Características clave
- Despliegue sin agente: Un único Collector por segmento de red maneja el descubrimiento y la recopilación.
- Paneles listos para usar: Paneles preconstruidos para los componentes de infraestructura más comunes.
- Detección inteligente de anomalías: Umbrales dinámicos que se adaptan a los patrones de tu carga de trabajo.
Ventajas
- Despliegue conveniente: No requiere instalación de agente por host.
- Excelentes paneles OOTB: Menor tiempo hasta obtener valor que la mayoría de alternativas autohospedadas.
- Fuerte soporte híbrido: Maneja tanto activos on-premise como en la nube desde la misma consola.
Desventajas
- Caro para entornos pequeños: El precio puede ser difícil de justificar por debajo de cierta escala.
- Personalización limitada: Menos flexible que las herramientas de código abierto para requisitos a medida.
Mejor para: Empresas de mercado medio con una mezcla de infraestructura en la nube y física que quieren la conveniencia SaaS sin proliferación de agentes.
Precio Precio personalizado. Contacta con LogicMonitor para un presupuesto.
7. Checkmk
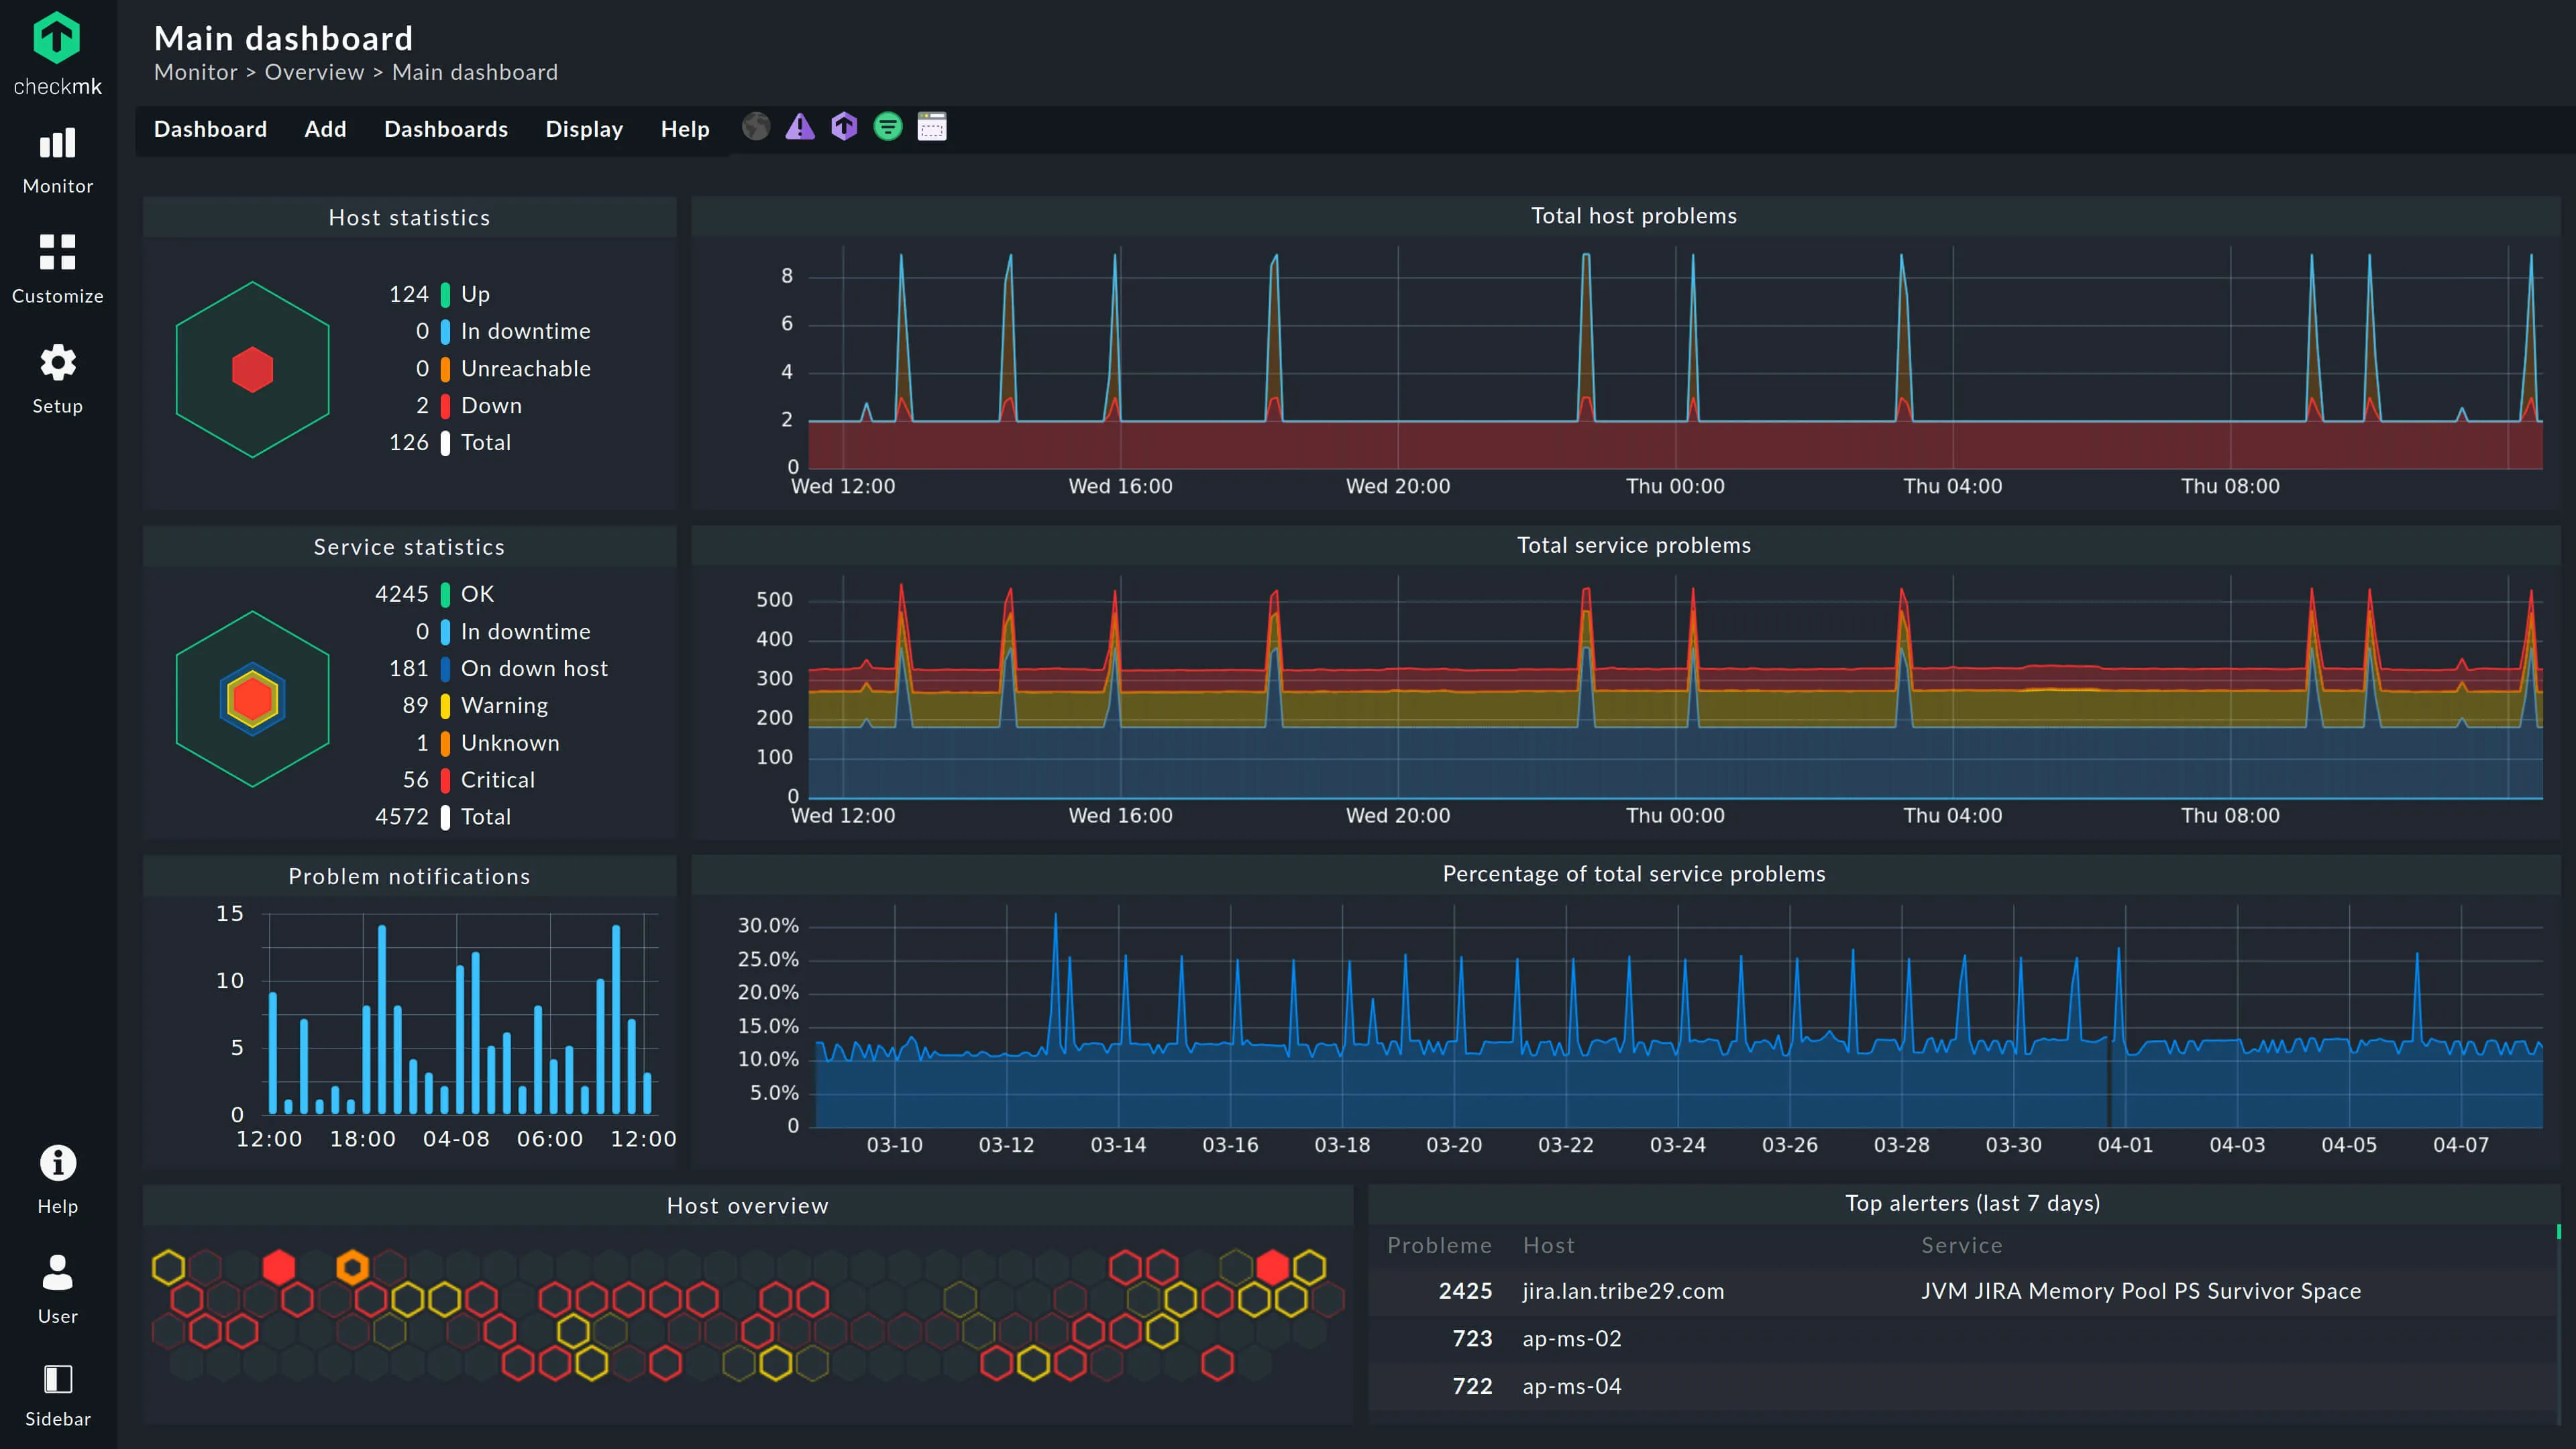
Checkmk es conocido por su motor de monitorización increíblemente eficiente. Puede monitorizar miles de servicios con un uso de CPU muy bajo, y es particularmente popular en entornos compatibles con ITIL en toda Europa.
Características clave
- Descubrimiento automático de servicios: Escanea hosts para encontrar automáticamente servicios en ejecución y configurar comprobaciones.
- Más de 2,000 plugins: Biblioteca masiva de integraciones que incluye hardware, puertos de switch y sistemas SAP.
- Monitorización híbrida: Igualmente bueno con bare metal, contenedores e instancias en la nube.
Ventajas
- Núcleo eficiente: Muchamente menos intensivo en recursos que Nagios o Zabbix con el mismo volumen de comprobaciones.
- Todo en uno: Maneja tanto monitorización basada en estados (Arriba/Abajo) como rendimiento de métricas.
- Comunidad activa: El Checkmk Exchange ofrece cientos de extensiones comunitarias.
Desventajas
- Interfaz anticuada: Funcional pero se siente desordenada comparada con herramientas SaaS modernas.
- Curva de aprendizaje pronunciada: El modelo de configuración basado en reglas lleva tiempo asimilarlo.
Mejor para: Monitorización de alta densidad donde la eficiencia es la máxima prioridad, y administradores de sistemas que gestionan una mezcla de hardware legacy y contenedores modernos.
Precio La edición de código abierto es gratuita. Enterprise comienza en ~$2,100/año para 3,000 servicios. Las ediciones SaaS comienzan en ~$6/host/mes.
8. Site24x7
Site24x7 (de Zoho) ofrece un amplio conjunto de herramientas de monitorización: uptime de sitios web, monitorización de servidores, seguimiento de red y más. Es una solución basada en la nube muy fácil de empezar a usar.
Características clave
- Amplia cobertura: Monitoriza servidores, sitios web (Synthetics), redes y apps móviles desde un solo lugar.
- RUM y Synthetics: Monitorización de usuario real integrada y comprobaciones de transacciones sintéticas.
- Paquetes asequibles: El precio se estructura en torno a paquetes en lugar de facturación por métrica.
Ventajas
- Muy asequible: Una de las opciones todo en uno más rentables del mercado.
- Fácil de configurar: Configuración mínima para empezar.
- Amplio conjunto de características: Cubre mucho terreno sin necesitar múltiples herramientas.
Desventajas
- Menos profundidad: No tan especializada ni personalizable como herramientas de monitorización dedicadas.
- Interfaz abultada: La interfaz puede sentirse abrumadora dada la amplitud de características.
Mejor para: Pequeñas y medianas empresas que necesitan una solución SaaS simple y asequible que cubra múltiples necesidades de monitorización.
Precio Los planes comienzan desde $9/mes. El precio depende del número de monitores y la retención de datos elegida.
9. Netdata
Netdata es único porque ofrece granularidad por segundo desde el inicio. Está diseñado para instalarse en cada servidor para darte una vista inmediata de alta resolución de lo que está pasando ahora mismo.
Características clave
- Resolución de 1 segundo: Métricas en tiempo real con casi ninguna latencia desde la recopilación hasta la visualización.
- ML no supervisado: Detección de anomalías integrada que marca valores atípicos sin umbrales manuales.
- Autodescubrimiento: Detecta automáticamente servicios y apps ejecutándose en el host.
Ventajas
- Sin configuración: Instala y obtén gráficos en tiempo real hermosos inmediatamente.
- Sobrecarga increíblemente baja: Lo suficientemente ligero para ejecutarse en hardware con recursos limitados.
- Gratis y de código abierto: El producto central no cuesta nada para autoalojar.
Desventajas
- Centrado en nodos por diseño: Históricamente mejor monitorizando nodos individuales que proporcionando una vista global de la infraestructura (aunque Netdata Cloud está mejorando esto).
- Sin trazado nativo: Principalmente una herramienta de métricas; los logs son una adición más nueva y aún en maduración.
Mejor para: Solución de problemas en tiempo real y ajuste de rendimiento de bajo nivel en hosts individuales.
Precio Código abierto (gratis, autoalojado). Netdata Cloud tiene un nivel gratuito y planes de pago para gestión centralizada.
10. Nagios XI
Nagios es el “abuelo” de la monitorización. Nagios XI es la versión comercial que añade una interfaz web y configuración más fácil al motor central, respaldado por el ecosistema de plugins más grande del mundo.
Características clave
- Biblioteca masiva de plugins: Si tiene una dirección IP, casi con seguridad hay un plugin de Nagios para ello.
- Alertas de estado binario: Lógica de alertas OK/CRÍTICO/ADVERTENCIA sólida como una roca.
- Asistentes de configuración: XI añade configuración de apuntar y hacer clic sobre el motor central de Nagios.
Ventajas
- Compatibilidad universal: Monitoriza virtualmente cualquier dispositivo, protocolo o servicio.
- Confiabilidad probada: Tecnología extremadamente estable con décadas de uso en producción.
Desventajas
- Experiencia significativa requerida: Configurar y mantener Nagios adecuadamente es un desafío técnico.
- Arquitectura anticuada: Se siente anticuado comparado con herramientas SaaS o cloud-native modernas.
- Las métricas son secundarias: Nagios es fundamentalmente una herramienta de comprobación de estado, no una plataforma de gráficos.
Mejor para: Organizaciones con requisitos de monitorización muy específicos o legacy, o entornos donde solo existe un plugin de Nagios para una pieza de hardware concreta.
Precio Nagios Core es gratis (código abierto). Nagios XI comienza en $2,495 para una licencia estándar (hasta 100 nodos).
Cómo elegir la solución adecuada
La mejor solución de monitorización de infraestructura IT es la que tu equipo realmente usará y mantendrá. Empieza auditando dos cosas: cuántos nodos tienes en la nube vs. on-premise y cuánto tiempo puede dedicar tu equipo realistamente al mantenimiento de la herramienta.
Si tienes un presupuesto grande y un equipo de observabilidad dedicado, Datadog o Prometheus son opciones excelentes. Si eres un equipo más pequeño, o estás cansado de pasar los fines de semana arreglando tu stack de monitorización, decántate por opciones sin configuración como Simple Observability o herramientas SaaS como LogicMonitor o Site24x7.
La herramienta adecuada debería sentirse como un multiplicador de fuerza, no otra tarea más en tu lista de pendientes.