



Trouver un outil de supervision qui couvre toute votre stack sans créer un deuxième emploi à temps plein pour votre équipe est plus difficile qu’il n’y paraît. Voici le comparatif des 10 meilleures solutions. Pour comprendre ce que vous supervisez, consultez notre guide sur l’infrastructure serveur et nos bonnes pratiques pour les tableaux de bord de supervision d’infrastructure.
La plupart des projets de supervision d’infrastructure échouent non pas parce que l’outil manquait de fonctionnalités, mais parce que l’équipe manquait de temps pour le maintenir. En 2026, le fossé entre les systèmes cloud-native et le matériel physique hérité est plus large que jamais. Il vous faut une solution qui comble ce fossé tout en limitant la configuration au strict minimum.
Le marché est partagé entre les géants d’entreprise qui coûtent une fortune et les outils open source qui exigent un effort manuel considérable. Cette liste se concentre sur les outils offrant le meilleur « temps de visibilité » dans des environnements hybrides.
Qu’est-ce qui fait une solution moderne de supervision d’infrastructure IT ?
Une solution moderne doit aller au-delà des simples pings ICMP. Elle doit corréler métriques, journaux et traces dans une vue unique pour réduire le temps moyen de résolution (MTTR).
En 2026, les incontournables sont la découverte automatique, les agents légers et le support hybride. Si vous devez mettre à jour manuellement votre supervision à chaque fois que vous lancez une instance cloud, votre solution est déjà dépassée.
Résumé rapide
| Outil | Idéal pour | Modèle de prix |
|---|---|---|
| Simple Observability | Simplicité & zéro config | $3 / mois / serveur |
| Datadog | Entreprise / Cloud | $15+ / hôte / mois |
| Prometheus & Grafana | Cloud native / K8s | Gratuit (OSS) / Managé payant |
| Zabbix | Réseau / On-prem | $50 / mois (Cloud) |
| New Relic | Perf applicative (APM) | À l’usage ($0.30/GB) |
| LogicMonitor | Hybride / Marché intermédiaire | Sur devis |
| Checkmk | IT complexe / Hybride | ~$6 / hôte / mois |
| Site24x7 | PME / SaaS | À partir de $9 / mois |
| Netdata | Dépannage temps réel | Gratuit (OSS) / Cloud payant |
| Nagios XI | Environnements hérités | $2,495+ (licence) |
10 meilleures solutions de supervision d’infrastructure IT
1. Simple Observability
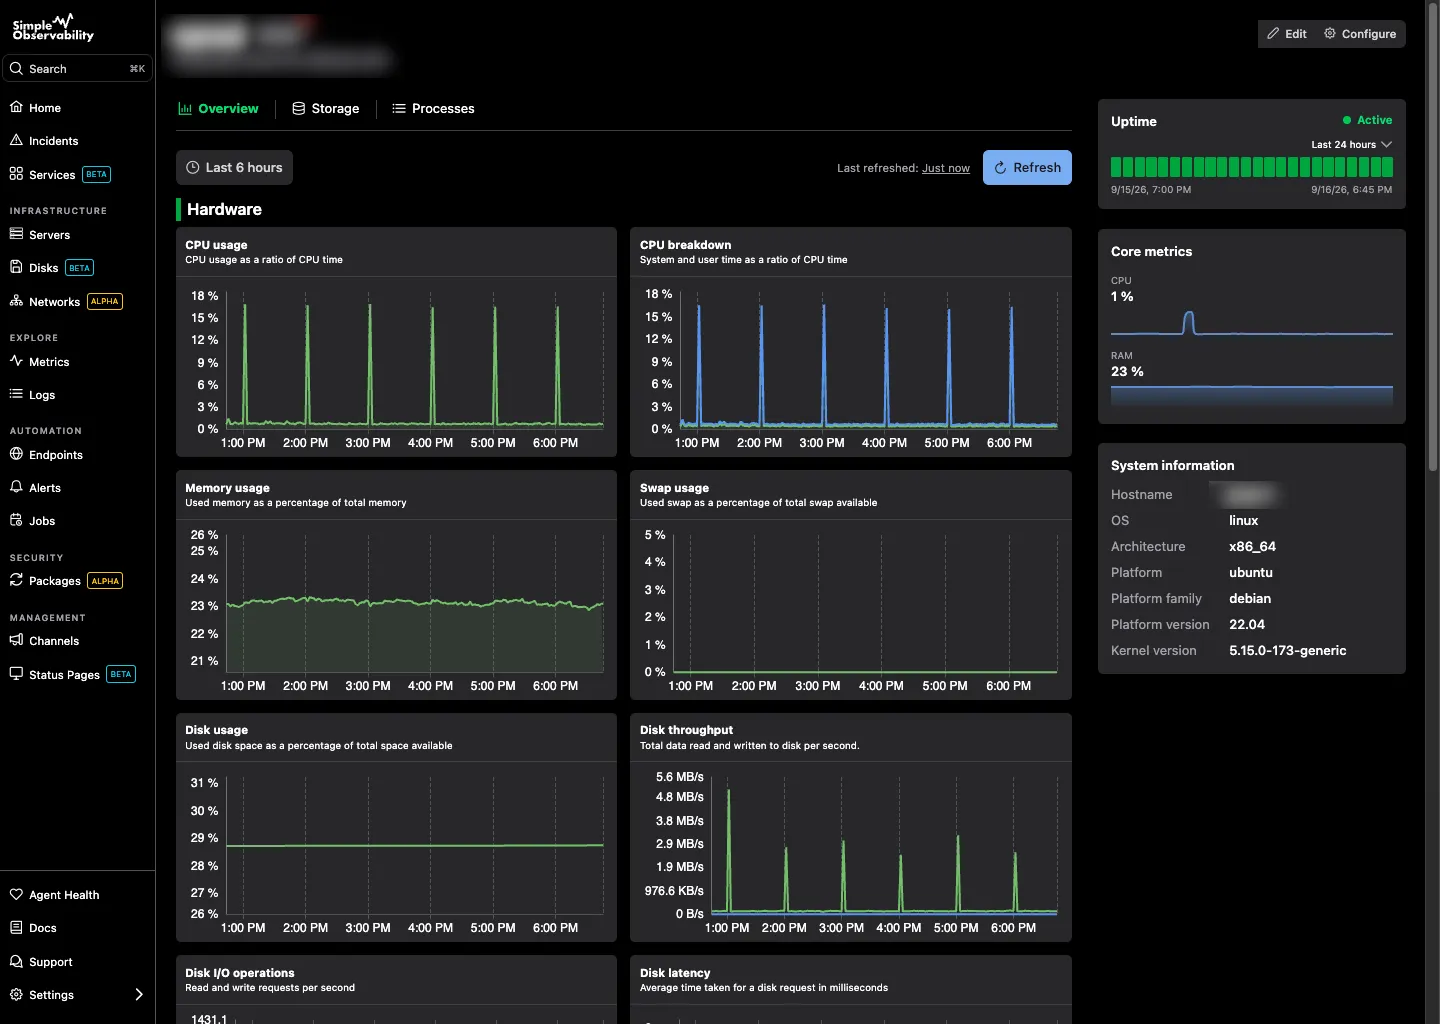
Simple Observability est conçu pour les équipes qui veulent une visibilité de niveau entreprise sans la configuration qui l’accompagne. Un agent binaire unique et léger découvre automatiquement les services et commence à remonter des données immédiatement, sans jongler avec du YAML.
Fonctionnalités clés
- Installation en une commande : Aucune configuration d’agent complexe. Vous obtenez la supervision CPU, mémoire, disque et uptime instantanément.
- Journaux & métriques unifiés : Consultez les journaux applicatifs à côté des métriques serveur dans le même tableau de bord.
- Alertes sans configuration : Des valeurs par défaut pertinentes dès l’installation pour une protection dès le premier jour.
- Confort SaaS : Aucune base de données de métriques ni pile de rétention à héberger.
Avantages
- Installation extrêmement rapide : Visibilité immédiate, sans configuration manuelle de tableau de bord.
- Tarification prévisible : Forfait fixe par serveur, pas de mauvaise surprise au million de métriques personnalisées.
- Corrélation journaux et métriques par défaut : Pas besoin de recoudre des outils séparés.
Inconvénients
- Moins de plugins spécialisés : Les vétérans comme Nagios disposent d’un écosystème de plugins plus vaste.
Idéal pour : Les équipes ayant besoin d’une visibilité immédiate sur des actifs hybrides cloud et on-prem.
Prix
- Gratuit : $0 pour 1 serveur.
- Payant : $3/mois par serveur pour un nombre illimité de serveurs.
- Sur mesure : Remises de volume pour les grandes flottes.
2. Datadog
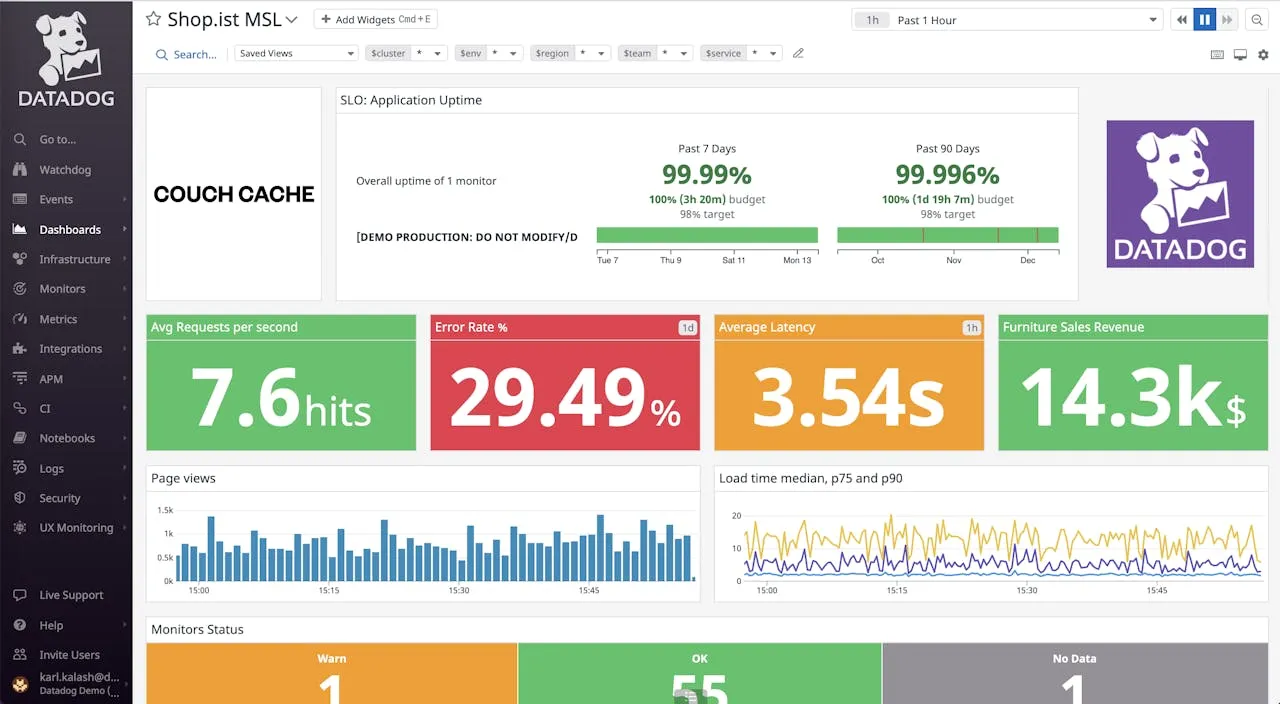
Datadog reste la plateforme la plus complète pour l’observabilité à grande échelle. Elle propose plus de 600 intégrations et peut superviser tout, depuis un serveur physique dans votre bureau jusqu’à une fonction serverless dans le cloud.
Fonctionnalités clés
- Observabilité full-stack : Corrélation fluide entre métriques, traces et journaux.
- Watchdog AI : Détection d’anomalies automatisée qui repère souvent les problèmes avant vous.
- 600+ intégrations : Intégrations au clic pour AWS, Azure, GCP et outils SaaS.
Avantages
- Couverture fonctionnelle inégalée : APM, sécurité, RUM et supervision réseau sous un même toit.
- Excellente corrélation : Relier un pic de latence à une trace ou une ligne de journal précise est réellement rapide.
- Interface soignée : Intuitive, rapide et agréable à utiliser.
Inconvénients
- Très onéreux à grande échelle : Le prix par hôte n’est que le ticket d’entrée ; les métriques personnalisées, l’ingestion de journaux et la rétention s’additionnent vite.
- Facturation imprévisible : La télémétrie à haut volume peut provoquer une douche froide si vous ne faites pas attention.
Idéal pour : Les grandes entreprises et les sociétés tech à forte croissance où la vélocité d’ingénierie compte plus que l’optimisation de la facture de supervision.
Prix L’infrastructure démarre à $15/hôte/mois. L’APM, les journaux ($0.10/GB indexés) et les métriques personnalisées sont facturés séparément, doublant souvent le coût de base en production.
3. Prometheus & Grafana
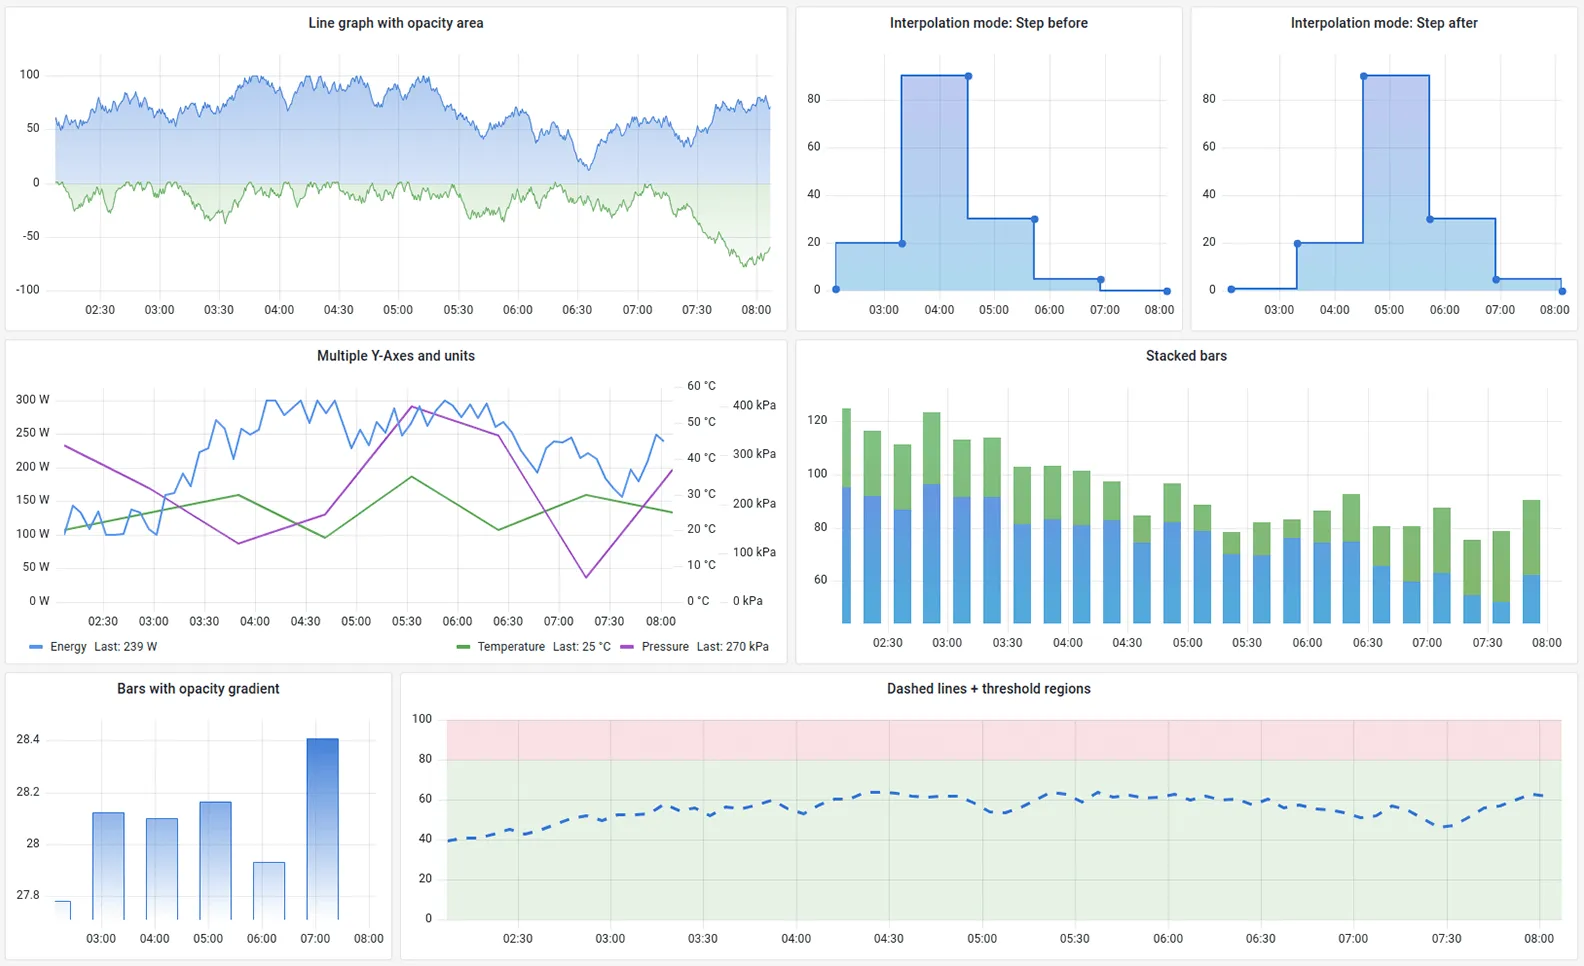
Le couple Prometheus et Grafana est le standard de l’industrie pour la supervision cloud-native. Prometheus collecte les métriques via un modèle pull, et Grafana les visualise à travers une couche de tableaux de bord puissante et entièrement personnalisable.
Fonctionnalités clés
- PromQL : Un langage de requête multidimensionnel puissant, conçu pour l’infrastructure moderne.
- Vaste écosystème : Exporters disponibles pour presque tous les logiciels (Redis, Postgres, Nginx, etc.).
- Alertmanager : Gère les alertes avec une logique de routage et de regroupement sophistiquée.
Avantages
- Standard de l’industrie : Le choix de facto pour la supervision Kubernetes.
- Open source : Entièrement gratuit en auto-hébergement.
- Flexibilité : Vous pouvez construire n’importe quel tableau de bord imaginables dans Grafana.
Inconvénients
- Charge de maintenance élevée : Vous devez gérer le stockage et le passage à l’échelle vous-même (nécessite souvent Thanos ou Cortex).
- Pas de support natif des journaux : Prometheus ne gère que les métriques ; il faut ajouter Loki ou un autre outil pour les journaux.
- Courbe d’apprentissage abrupte : Maîtriser PromQL demande du temps par rapport aux interfaces au clic.
Idéal pour : Les équipes avec de solides compétences DevOps qui veulent un contrôle total sur leurs données, particulièrement les environnements Kubernetes.
Prix Gratuit (open source). Le faire tourner à grande échelle nécessite généralement des extensions de stockage payantes ou des services managés comme Grafana Cloud ou Amazon Managed Prometheus, facturés à l’usage.
4. Zabbix
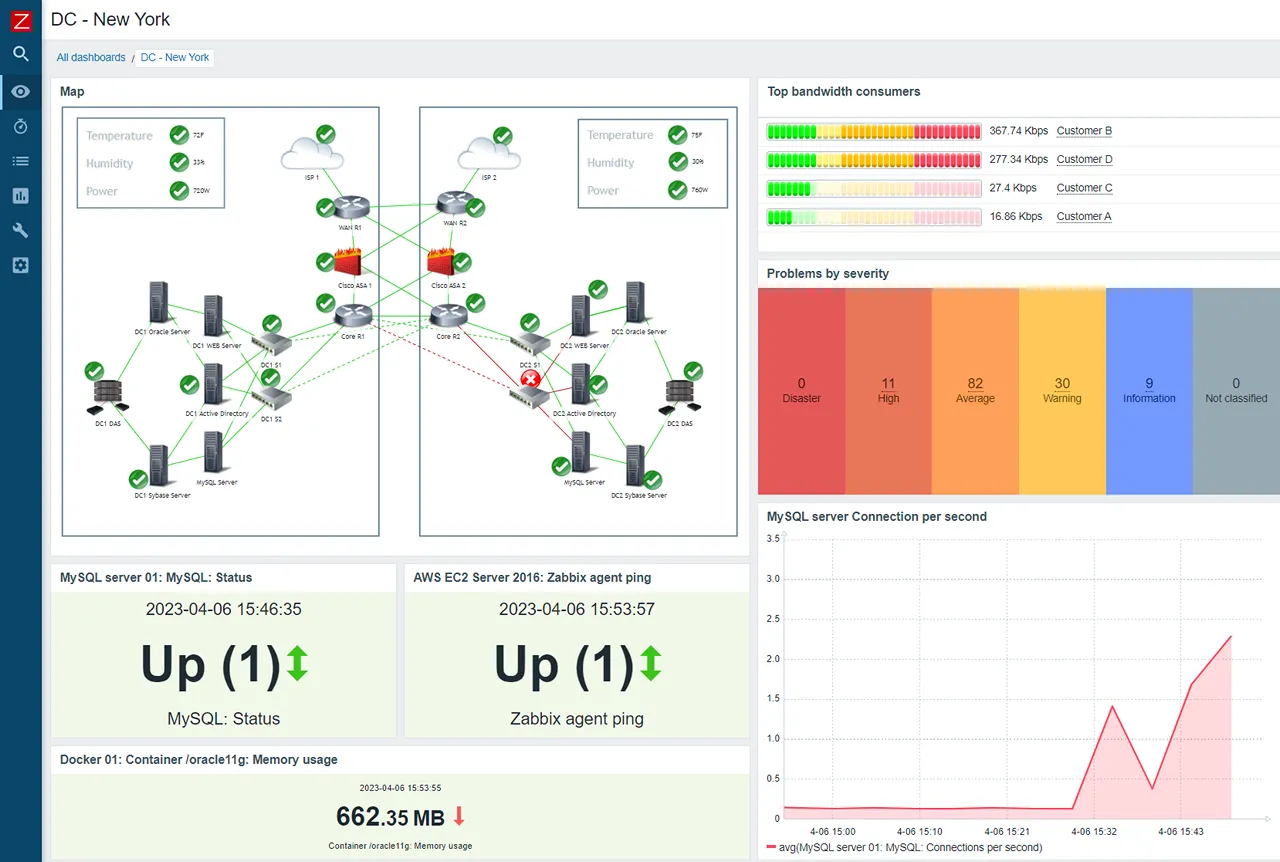
Zabbix est une plateforme open source mature, de niveau entreprise, qui excelle dans la supervision du matériel réseau et des serveurs on-prem. Elle est hautement scalable et peut gérer des dizaines de milliers d’équipements depuis une console unique.
Fonctionnalités clés
- Agent & sans agent : Supervision via SNMP, JMX, IPMI et son propre agent léger.
- Push & pull : Supporte les méthodes de collecte par interrogation et par trapping.
- Permissions granulaires : Excellente multi-tenantité et contrôles d’accès utilisateurs.
Avantages
- Entièrement gratuit : Le logiciel lui-même n’a aucun coût de licence.
- Moteur d’alertes robuste : Expressions de déclencheurs flexibles et politiques d’escalade.
- Éprouvé à grande échelle : Testé au combat dans des environnements massifs depuis des décennies.
Inconvénients
- Interface datée : L’interface ressemble à un logiciel d’entreprise du milieu des années 2000.
- Charge de maintenance élevée : Gérer la base de données sous-jacente (PostgreSQL/MySQL) peut devenir un travail à temps plein.
- Support cloud-native limité : Les auto-scaling groups et pods éphémères nécessitent des règles de découverte complexes.
Idéal pour : Les datacenters traditionnels, les NOC (centres d’opérations réseau) et les environnements axés sur le réseau.
Prix Le logiciel est open source. Les déploiements professionnels utilisent souvent Zabbix Cloud, qui démarre à $50/mois. Le support entreprise est également un service payant.
5. New Relic
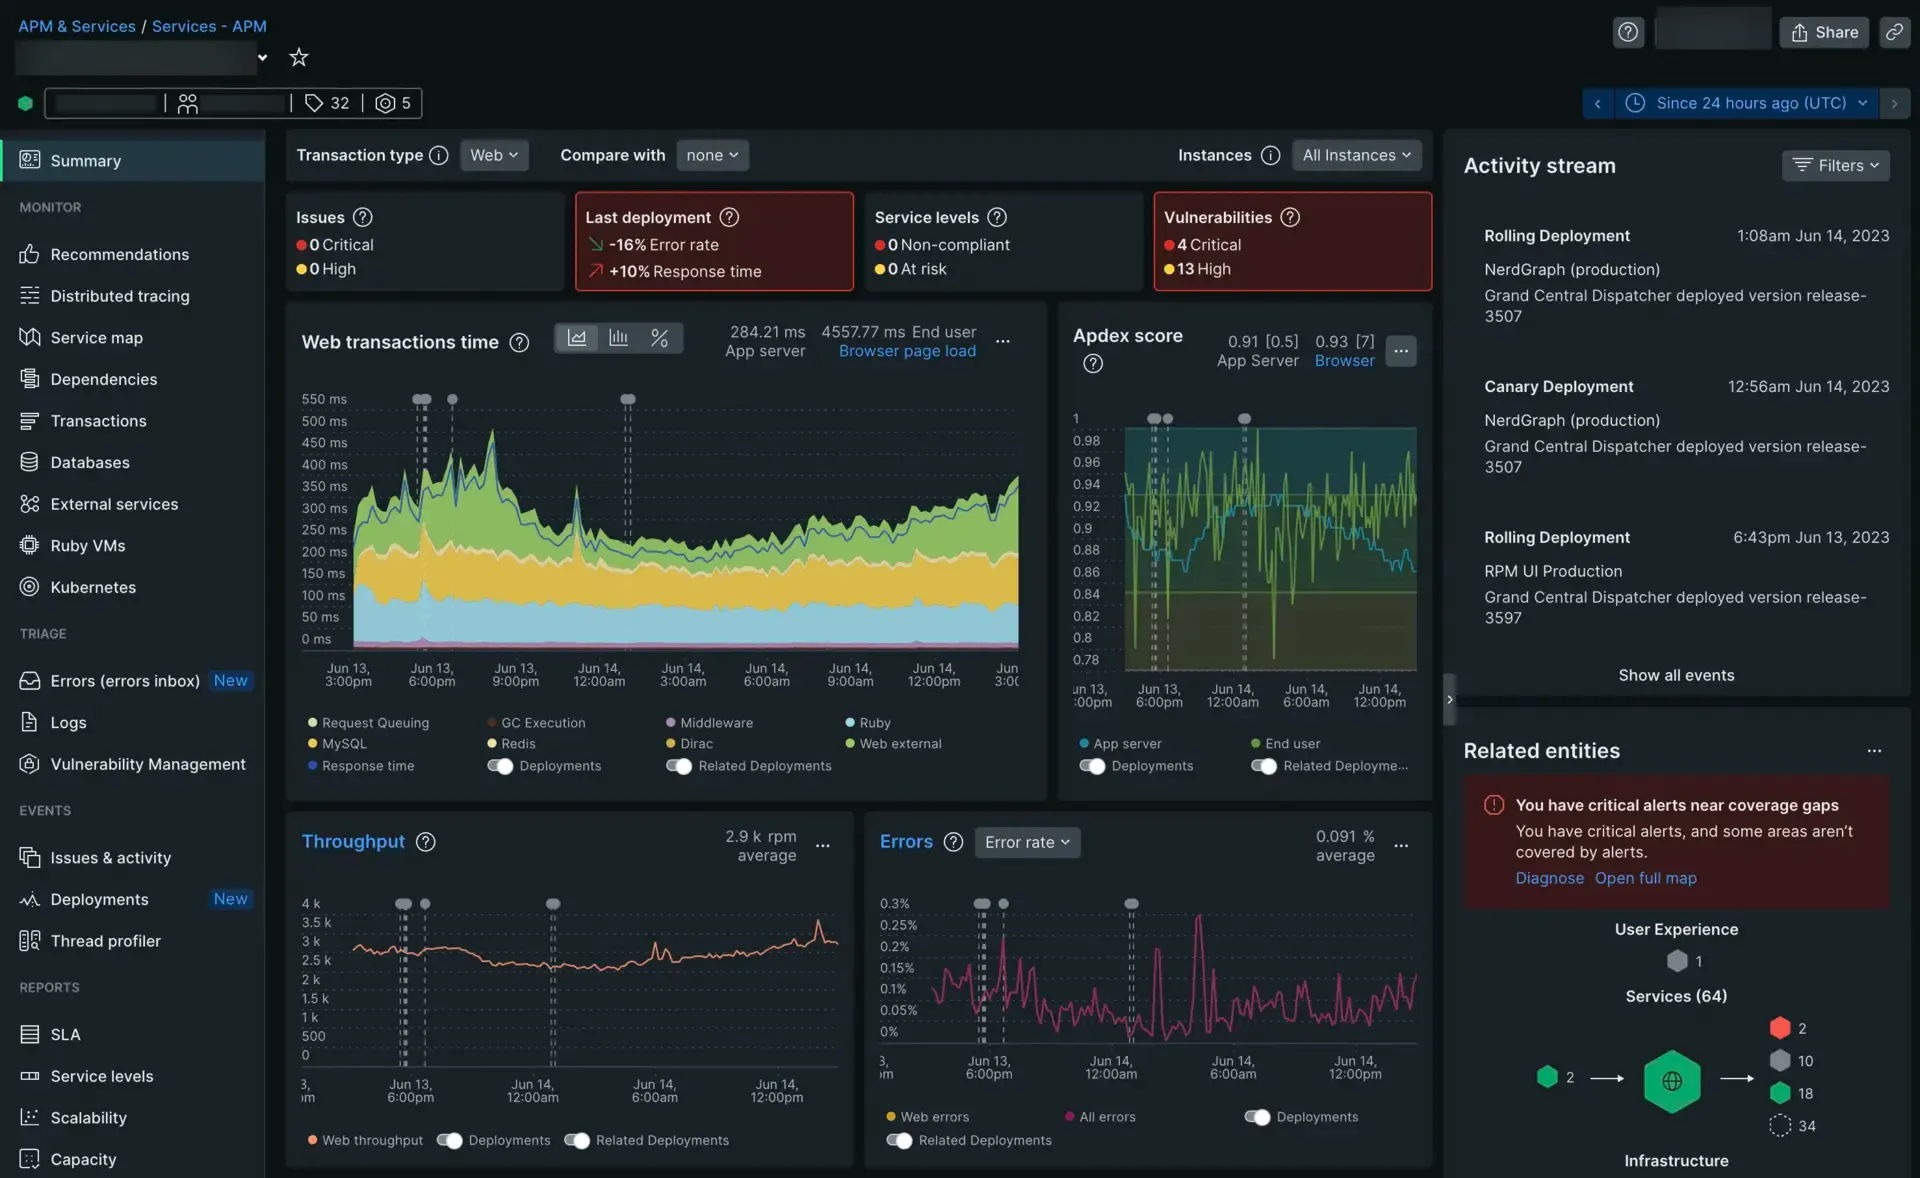
New Relic est passé à un modèle de « plateforme de données unifiée ». Bien qu’elle ait commencé comme un outil de performance applicative, sa supervision d’infrastructure est désormais étroitement intégrée, vous permettant de voir comment la santé d’un serveur affecte directement la latence applicative.
Fonctionnalités clés
- APM approfondi : Tracing au niveau du code pour identifier les requêtes de base de données lentes ou les fonctions inefficaces.
- Web & mobile : Support natif pour suivre l’expérience utilisateur final sur les applis web et mobiles.
- Applied Intelligence : Analyses pilotées par IA pour détecter les anomalies et corréler les événements sur votre stack.
Avantages
- Visibilité tout-en-un : Métriques, journaux et traces stockés au même endroit.
- Offre gratuite généreuse : 100 GB/mois gratuits pour les petites équipes.
- Fonctions de requête solides : NRQL est puissant et accessible.
Inconvénients
- Interface surchargée : La plateforme est vaste et sa navigation peut frustrer pour des besoins simples.
- Tarification par utilisateur : Les sièges Full Platform User deviennent chers à mesure que l’équipe grandit.
Idéal pour : Les équipes orientées application qui veulent un outil unique pour toute la stack, particulièrement quand l’APM compte.
Prix À l’usage : gratuit jusqu’à 100 GB/mois. Les forfaits payants démarrent à $0.30/GB ingérés plus des frais de siège par utilisateur ($99/mois pour Core, $549/mois pour Full Platform).
6. LogicMonitor
LogicMonitor est une plateforme de supervision SaaS sans agent. Elle est conçue pour être facile à déployer dans des environnements hybrides, via un « Collector » qui se place dans votre réseau et scanne automatiquement les équipements.
Fonctionnalités clés
- Déploiement sans agent : Un seul Collector par segment réseau gère la découverte et la collecte.
- Tableaux de bord prêts à l’emploi : Tableaux de bord préconstruits pour la plupart des composants d’infrastructure courants.
- Détection d’anomalies intelligente : Seuils dynamiques qui s’adaptent à vos patterns de charge.
Avantages
- Déploiement pratique : Aucune installation d’agent par hôte requise.
- Excellents tableaux de bord OOTB : Time-to-value plus court que la plupart des alternatives auto-hébergées.
- Support hybride solide : Gère actifs on-prem et cloud depuis la même console.
Inconvénients
- Onéreux pour les petits environnements : La tarification est difficile à justifier en deçà d’une certaine échelle.
- Personnalisation limitée : Moins flexible que les outils open source pour les besoins sur mesure.
Idéal pour : Les entreprises de marché intermédiaire avec un mix de cloud et d’infrastructure physique qui veulent le confort du SaaS sans la prolifération d’agents.
Prix Tarification sur devis. Contactez LogicMonitor pour un devis.
7. Checkmk
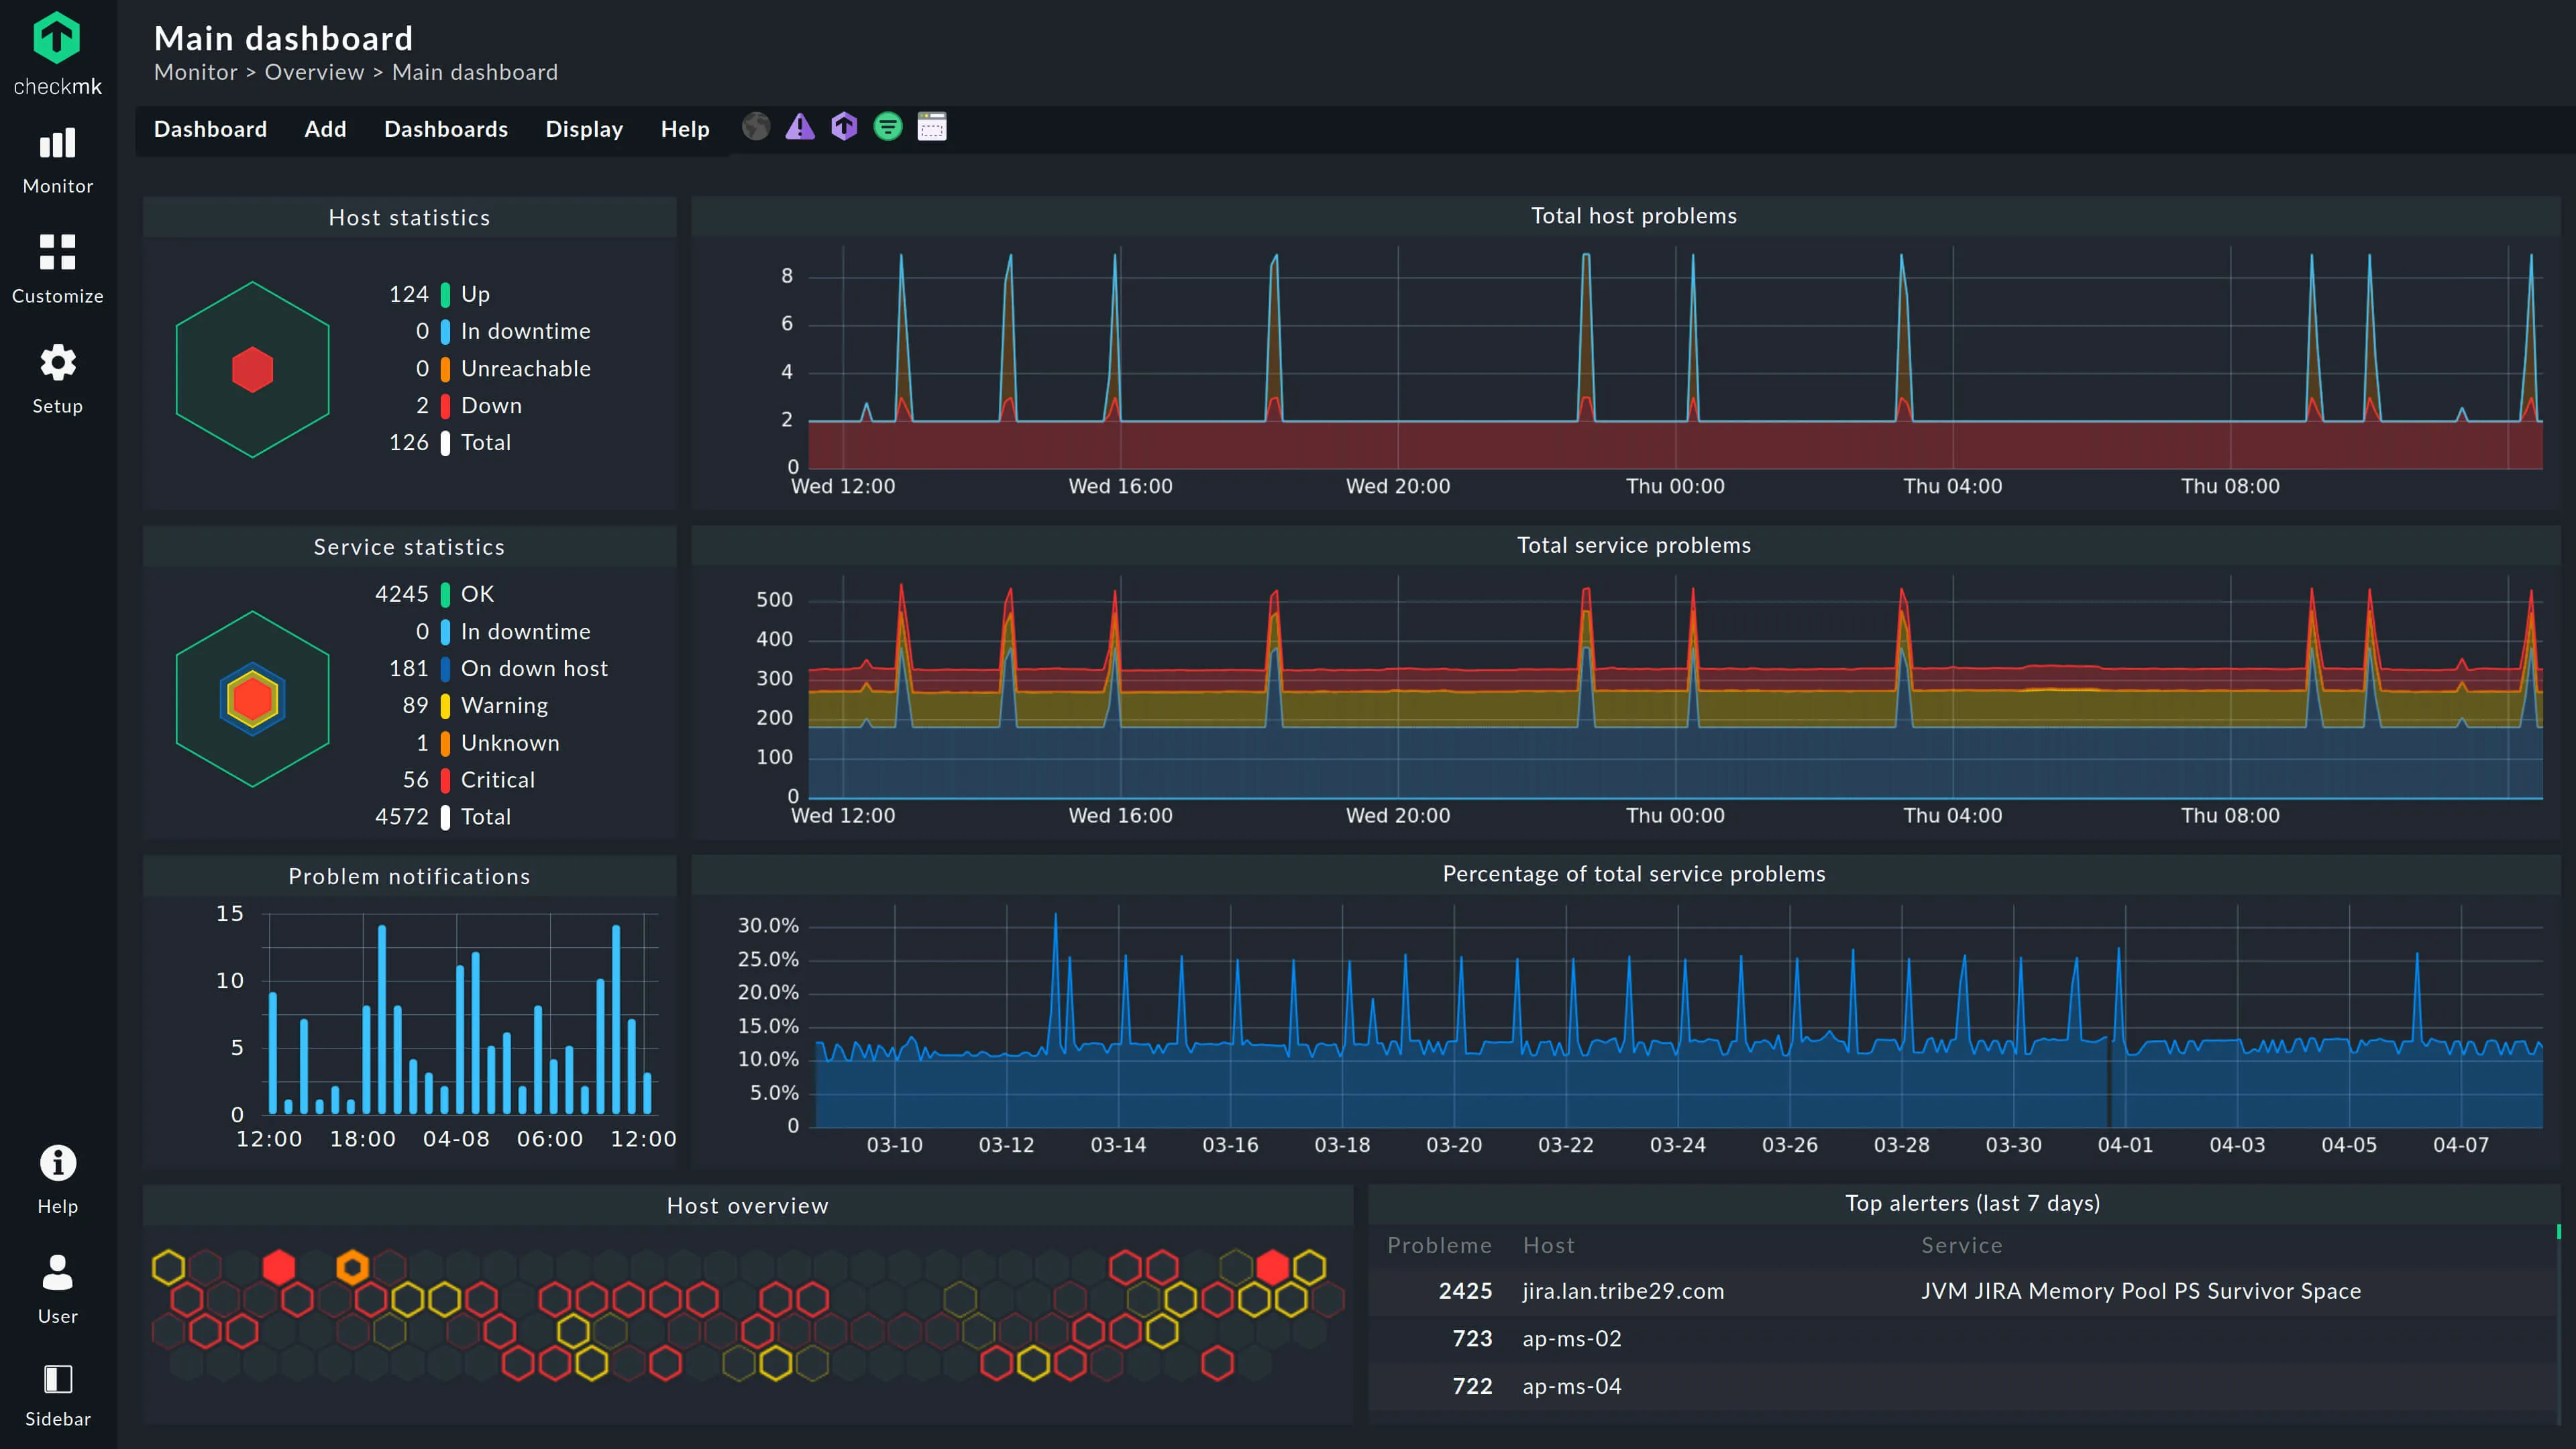
Checkmk est connu pour son moteur de supervision incroyablement efficace. Il peut superviser des milliers de services avec une très faible charge CPU, et est particulièrement populaire dans les environnements conformes ITIL à travers l’Europe.
Fonctionnalités clés
- Découverte de services automatisée : Scan des hôtes pour trouver automatiquement les services en cours d’exécution et configurer les vérifications.
- 2 000+ plugins : Bibliothèque massive d’intégrations incluant matériel, ports de switch et systèmes SAP.
- Supervision hybride : Aussi à l’aise sur bare metal que sur conteneurs et instances cloud.
Avantages
- Cœur efficace : Bien moins gourmand en ressources que Nagios ou Zabbix à volume de vérifications équivalent.
- Tout-en-un : Gère la supervision d’état (Up/Down) et de performance de métriques.
- Communauté active : Le Checkmk Exchange propose des centaines d’extensions communautaires.
Inconvénients
- Interface datée : Fonctionnelle mais encombrée comparée aux outils SaaS modernes.
- Courbe d’apprentissage abrupte : Le modèle de configuration basé sur des règles demande du temps pour être intégré.
Idéal pour : La supervision haute densité où l’efficacité est la priorité absolue, et les sysadmins gérant un mix de matériel hérité et de conteneurs modernes.
Prix L’édition open source est gratuite. Enterprise démarre à ~$2,100/an pour 3 000 services. Les éditions SaaS démarrent à ~$6/hôte/mois.
8. Site24x7
Site24x7 (de Zoho) propose une large suite d’outils de supervision : disponibilité de sites web, supervision de serveurs, suivi réseau, et plus. C’est une solution cloud très facile à prendre en main.
Fonctionnalités clés
- Couverture large : Supervise serveurs, sites web (Synthetics), réseaux et applis mobiles depuis un seul endroit.
- RUM & Synthetics : Real User Monitoring et vérifications de transactions synthétiques intégrés.
- Forfaits abordables : Tarification structurée en forfaits plutôt qu’à la métrique.
Avantages
- Très abordable : L’une des options tout-en-un les plus rentables du marché.
- Facile à configurer : Configuration minimale requise pour démarrer.
- Éventail fonctionnel large : Couvre beaucoup de terrain sans nécessiter plusieurs outils.
Inconvénients
- Moins de profondeur : Moins spécialisé et personnalisable que des outils de supervision dédiés.
- Interface encombrée : L’interface peut sembler écrasante vu l’étendue des fonctionnalités.
Idéal pour : Les PME qui ont besoin d’une solution SaaS simple et abordable couvrant plusieurs besoins de supervision.
Prix Les forfaits démarrent à $9/mois. Le prix dépend du nombre de moniteurs et de la rétention de données choisie.
9. Netdata
Netdata est unique car il offre une granularité à la seconde dès l’installation. Il est conçu pour être installé sur chaque serveur afin de vous donner une vue immédiate et haute résolution de ce qui se passe maintenant.
Fonctionnalités clés
- Résolution à 1 seconde : Métriques en temps réel avec quasiment aucune latence entre collecte et visualisation.
- ML non supervisée : Détection d’anomalies intégrée qui signale les valeurs aberrantes sans seuils manuels.
- Découverte automatique : Détecte automatiquement les services et applis tournant sur l’hôte.
Avantages
- Zéro configuration : Installez et obtenez de magnifiques graphiques temps réel immédiatement.
- Overhead incroyable faible : Assez léger pour tourner sur du matériel contraint.
- Gratuit et open source : Le produit cœur ne coûte rien en auto-hébergement.
Inconvénients
- Centré sur le nœud par conception : Historiquement meilleur pour superviser des nœuds individuels que pour offrir une vue globale de l’infrastructure (bien que Netdata Cloud améliore cela).
- Pas de tracing natif : Principalement un outil de métriques ; les journaux sont une addition plus récente, encore en maturation.
Idéal pour : Le dépannage en temps réel et l’optimisation de performance bas niveau sur des hôtes individuels.
Prix Open source (gratuit, auto-hébergé). Netdata Cloud propose un palier gratuit et des forfaits payants pour la gestion centralisée.
10. Nagios XI
Nagios est le « grand-père » de la supervision. Nagios XI est la version commerciale qui ajoute une interface web et une configuration simplifiée au moteur cœur, portée par le plus grand écosystème de plugins au monde.
Fonctionnalités clés
- Bibliothèque de plugins massive : Si ça a une adresse IP, il y a presque certainement un plugin Nagios pour ça.
- Alertes par état binaire : Logique d’alerte OK/CRITICAL/WARNING increvable.
- Assistants de configuration : XI ajoute une configuration au clic par-dessus le moteur Nagios cœur.
Avantages
- Compatibilité universelle : Supervise virtuellement n’importe quel équipement, protocole ou service.
- Fiabilité éprouvée : Technologie extrêmement stable avec des décennies d’utilisation en production.
Inconvénients
- Expertise significative requise : Configurer et maintenir Nagios correctement est un défi technique.
- Architecture datée : Paraît antique comparé aux outils SaaS ou cloud-native modernes.
- Les métriques sont secondaires : Nagios est fondamentalement un outil de vérification d’état, pas une plateforme de graphiques.
Idéal pour : Les organisations avec des exigences de supervision très spécifiques ou héritées, ou les environnements où seul un plugin Nagios existe pour un matériel donné.
Prix Nagios Core est gratuit (open source). Nagios XI démarre à $2,495 pour une licence standard (jusqu’à 100 nœuds).
Comment choisir la bonne solution
La meilleure solution de supervision d’infrastructure IT est celle que votre équipe utilisera et maintiendra réellement. Commencez par auditer deux choses : combien de nœuds cloud vs on-prem vous avez, et combien de temps votre équipe peut réellement consacrer à la maintenance de l’outil.
Si vous avez un budget important et une équipe observabilité dédiée, Datadog ou Prometheus sont d’excellents choix. Si vous êtes une équipe plus petite, ou si vous êtes las de passer vos week-ends à réparer votre stack de supervision, orientez-vous vers des options zéro config comme Simple Observability ou des outils SaaS comme LogicMonitor ou Site24x7.
Le bon outil devrait agir comme un multiplicateur de force, pas comme une corvée de plus sur votre liste de tâches.