



Ein Monitoring-Tool zu finden, das Ihren gesamten Stack abdeckt, ohne Ihrem Team einen zweiten Vollzeitjob zu bescheren, ist schwieriger, als es aussieht. Hier sind die besten 10 Lösungen im Vergleich. Hintergrundinformationen dazu, was Sie überwachen, finden Sie in unserem Guide zur Server-Infrastruktur und unseren Best Practices für Infrastruktur-Monitoring-Dashboards.
Die meisten Infrastruktur-Monitoring-Projekte scheitern nicht daran, dass das Tool zu wenige Funktionen hatte, sondern daran, dass dem Team die Zeit fehlte, es zu pflegen. 2026 ist die Lücke zwischen Cloud-nativen Systemen und lokaler Legacy-Hardware größer denn je. Sie brauchen eine Lösung, die diese Lücke schließt und gleichzeitig den Konfigurationsaufwand minimiert.
Der Markt teilt sich in Enterprise-Giganten, die ein Vermögen kosten, und Open-Source-Tools, die erheblichen manuellen Aufwand erfordern. Diese Liste konzentriert sich auf Tools, die die beste “Time to Visibility” in hybriden Umgebungen bieten.
Was eine moderne IT-Infrastruktur-Monitoring-Lösung ausmacht
Eine moderne Lösung muss über einfache ICMP-Pings hinausgehen. Sie muss Metriken, Logs und Traces in einer einzigen Ansicht korrelieren, um die Mean Time to Resolution (MTTR) zu senken.
2026 sind Auto-Discovery, ressourcenschonende Agenten und Hybrid-Unterstützung nicht verhandelbar. Wenn Sie Ihr Monitoring jedes Mal manuell aktualisieren müssen, wenn Sie eine Cloud-Instanz starten, ist Ihre Lösung bereits veraltet.
Kurzübersicht
| Tool | Am besten für | Preismodell |
|---|---|---|
| Simple Observability | Einfachheit & Zero Config | $3 / Mo / Server |
| Datadog | Enterprise / Cloud | $15+ / Host / Monat |
| Prometheus & Grafana | Cloud Native / K8s | Kostenlos (OSS) / Managed kostenpflichtig |
| Zabbix | Netzwerk / On-Prem | $50 / Mo (Cloud) |
| New Relic | App-Performance (APM) | Nutzungsbasiert ($0,30/GB) |
| LogicMonitor | Hybrid / Mittelstand | Individuell |
| Checkmk | Komplexe IT / Hybrid | ~$6 / Host / Monat |
| Site24x7 | KMU / SaaS | Ab $9 / Mo |
| Netdata | Echtzeit-Fehlersuche | Kostenlos (OSS) / Cloud kostenpflichtig |
| Nagios XI | Legacy-Umgebungen | $2.495+ (Lizenz) |
Die 10 besten IT-Infrastruktur-Monitoring-Lösungen
1. Simple Observability
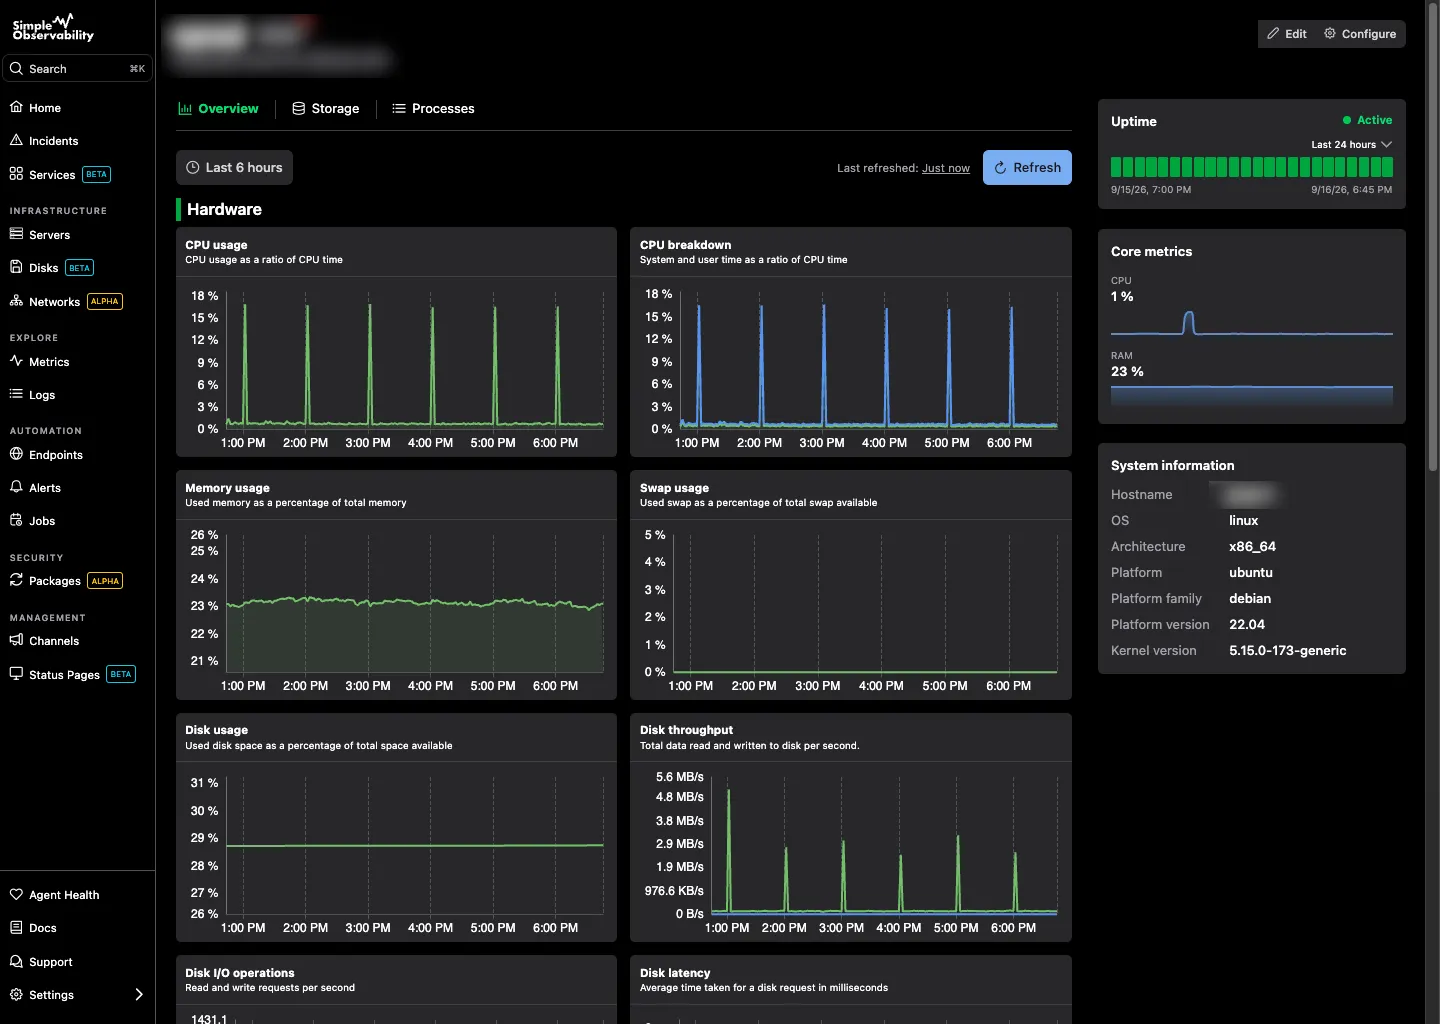
Simple Observability wurde für Teams entwickelt, die Transparenz auf Enterprise-Niveau ohne den Konfigurationsaufwand einer Enterprise-Lösung wollen. Ein einzelner, leichtgewichtiger Binary-Agent erkennt Dienste automatisch und beginnt sofort mit der Datenübertragung, ganz ohne YAML-Gefrickel.
Wichtigste Funktionen
- Installation mit einem Befehl: Keine komplexe Agent-Konfiguration. Sie erhalten sofort CPU-, Speicher-, Festplatten- und Uptime-Monitoring.
- Vereinheitlichte Logs & Metriken: Sehen Sie Anwendungs-Logs neben Server-Metriken im selben Dashboard.
- Zero-Config-Alerts: Sinnvolle Standardwerte ab dem ersten Tag, sodass Sie von Anfang an geschützt sind.
- SaaS-Komfort: Keine Metrik-Datenbank oder Retention-Stack, den Sie hosten müssen.
Vorteile
- Äußerst schnelle Einrichtung: Sofortige Transparenz ohne manuelle Dashboard-Konfiguration.
- Vorhersehbares Pricing: Pauschale pro Server, keine Überraschungen durch “pro Million Custom Metrics”.
- Korreliert Logs und Metriken standardmäßig: Kein Zusammensetzen separater Tools nötig.
Nachteile
- Weniger spezialisierte Plugins: Legacy-Giganten wie Nagios haben ein größeres Plugin-Ökosystem.
Am besten für: Teams, die sofortige Transparenz über hybride Cloud- und On-Prem-Ressourcen benötigen.
Preis
- Kostenlos: $0 für 1 Server.
- Kostenpflichtig: $3/Mo pro Server für unbegrenzte Server.
- Individuell: Mengenrabatte für große Flotten.
2. Datadog
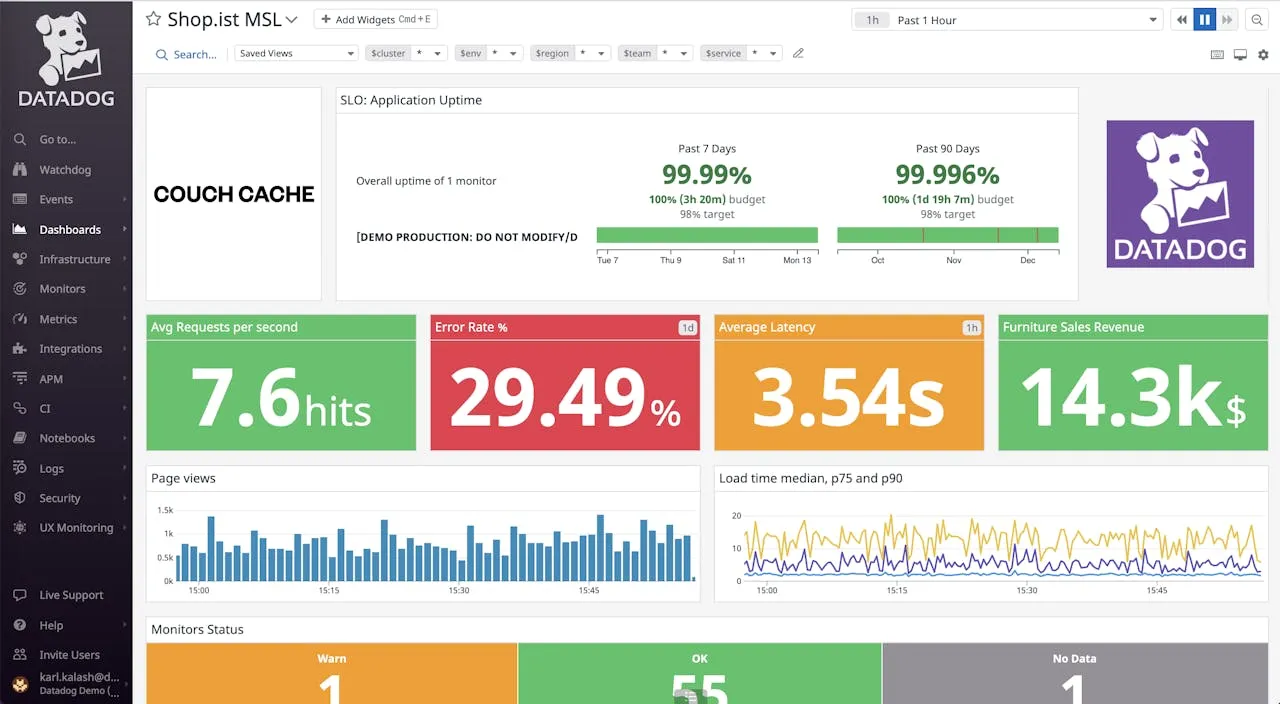
Datadog bleibt die umfassendste Plattform für groß angelegte Observability. Es bietet über 600 Integrationen und kann alles überwachen, von einem physischen Server in Ihrem Büro bis zu einer serverlosen Funktion in der Cloud.
Wichtigste Funktionen
- Full-Stack-Observability: Nahtlose Korrelation zwischen Metriken, Traces und Logs.
- Watchdog AI: Automatisierte Anomalieerkennung, die Probleme oft schon vor Ihnen entdeckt.
- 600+ Integrationen: Point-and-Click-Integrationen für AWS, Azure, GCP und SaaS-Tools.
Vorteile
- Unübertroffener Funktionsumfang: Deep APM, Security, RUM und Netzwerk-Monitoring unter einem Dach.
- Hervorragende Korrelation: Einen Latenz-Spike mit einem spezifischen Trace oder einer Log-Zeile zu verknüpfen, geht wirklich schnell.
- Polierte UI: Intuitiv, schnell und tatsächlich angenehm zu bedienen.
Nachteile
- Bei Skalierung sehr teuer: Der Preis pro Host ist nur der Einstieg; Custom Metrics, Log-Ingestion und Retention summieren sich schnell.
- Unberechenbare Abrechnung: Telemetrie mit hohem Volumen kann zu Rechnungsschocks führen, wenn Sie nicht aufpassen.
Am besten für: Große Unternehmen und stark wachsende Technologieunternehmen, bei denen Engineering-Geschwindigkeit wichtiger ist als die Optimierung der Monitoring-Rechnung.
Preis Infrastruktur beginnt bei $15/Host/Mo. APM, Logs ($0,10/GB indiziert) und Custom Metrics werden separat abgerechnet und verdoppeln die Basiskosten in der Produktion oft.
3. Prometheus & Grafana
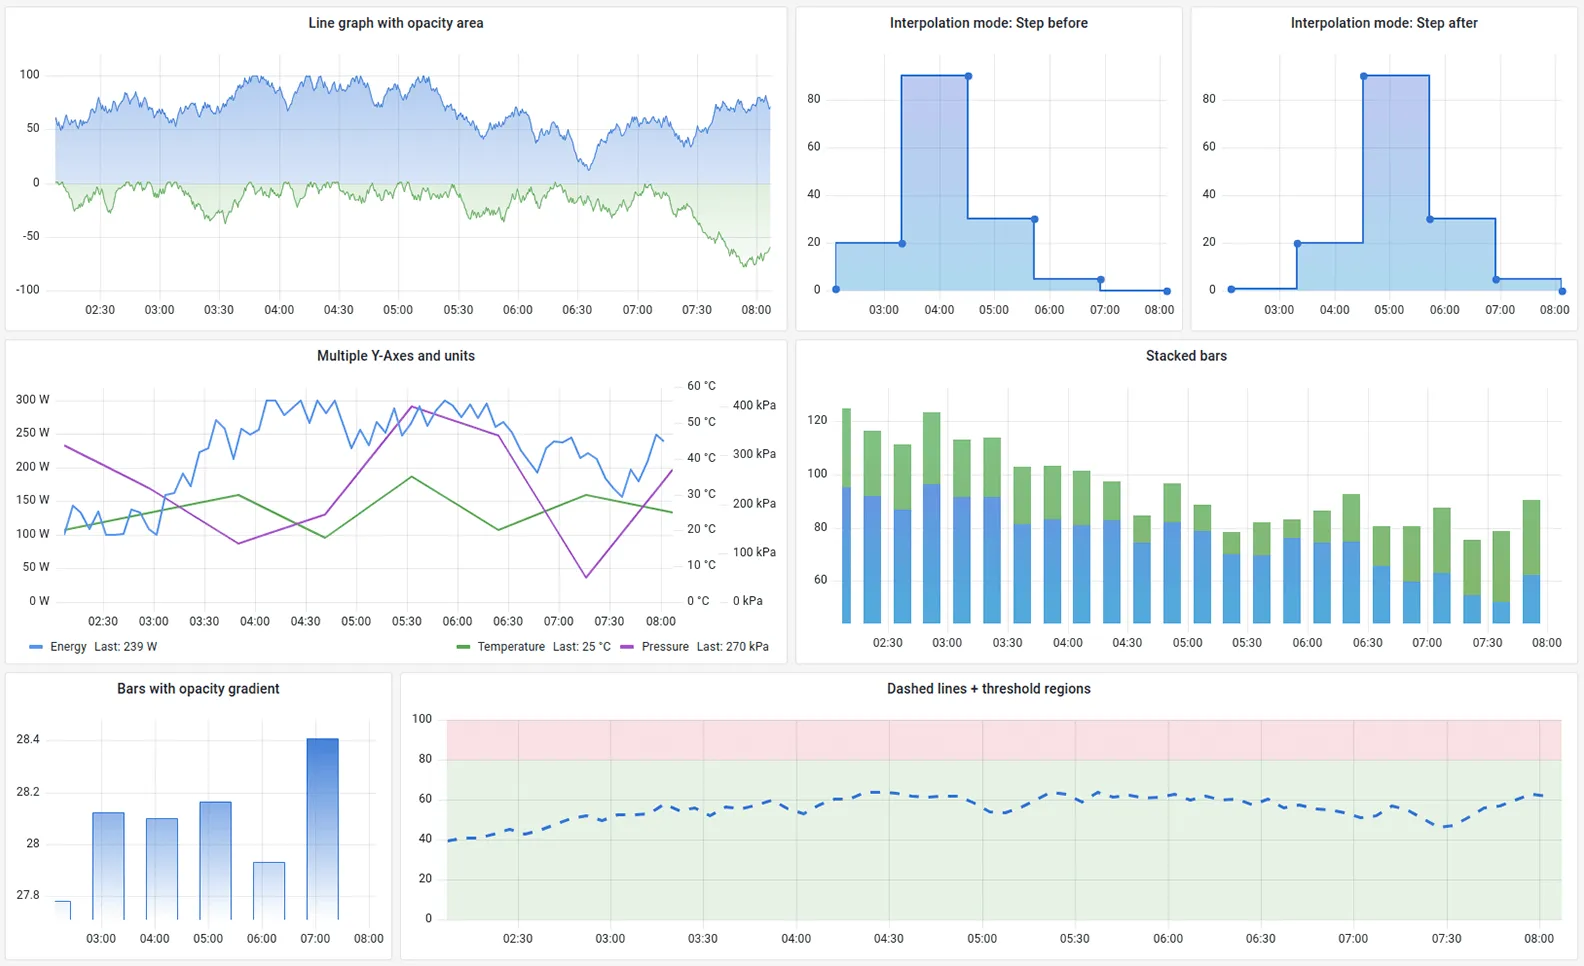
Prometheus zusammen mit Grafana ist der Industriestandard für Cloud-natives Monitoring. Prometheus sammelt Metriken über ein Pull-Modell, und Grafana visualisiert sie über eine leistungsstarke, vollständig anpassbare Dashboarding-Schicht.
Wichtigste Funktionen
- PromQL: Eine leistungsstarke, mehrdimensionale Abfragesprache, die für moderne Infrastruktur entwickelt wurde.
- Riesiges Ökosystem: Exporter für praktisch jede Software (Redis, Postgres, Nginx etc.).
- Alertmanager: Verarbeitet Alerts mit anspruchsvoller Routing- und Gruppierungslogik.
Vorteile
- Industriestandard: Die De-facto-Wahl für Kubernetes-Monitoring.
- Open Source: Bei Self-Hosting komplett kostenlos.
- Flexibilität: Sie können sich jedes vorstellbare Dashboard in Grafana bauen.
Nachteile
- Hoher Wartungsaufwand: Sie müssen Speicher und Skalierung selbst verwalten (oft Thanos oder Cortex erforderlich).
- Keine native Log-Unterstützung: Prometheus ist nur für Metriken; für Logs benötigen Sie Loki oder ein anderes Tool.
- Steile Lernkurve: PromQL erfordert Zeit zum Erlernen im Vergleich zu Point-and-Click-Oberflächen.
Am besten für: Teams mit starken DevOps-Fähigkeiten, die volle Kontrolle über ihre Daten haben möchten, insbesondere in Kubernetes-Umgebungen.
Preis Kostenlos (Open Source). Skalierter Betrieb erfordert meist kostenpflichtige Speicher-Erweiterungen oder Managed Services wie Grafana Cloud oder Amazon Managed Prometheus, die nutzungsbasiert abrechnen.
4. Zabbix
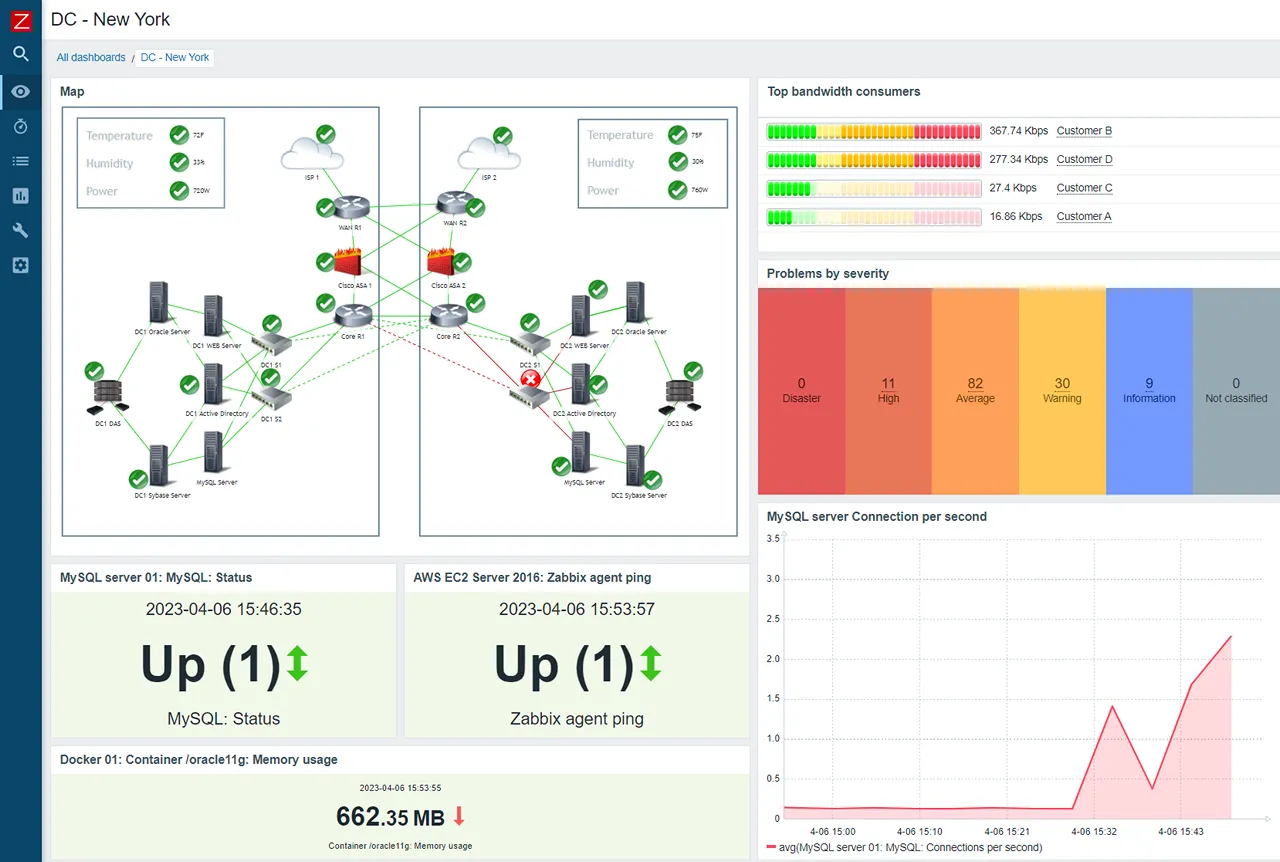
Zabbix ist eine ausgereifte, Enterprise-fähige Open-Source-Plattform, die bei der Überwachung von Netzwerk-Hardware und On-Prem-Servern glänzt. Sie ist hochgradig skalierbar und kann Zehntausende von Geräte über eine einzige Konsole verwalten.
Wichtigste Funktionen
- Agent & Agentless: Überwachung via SNMP, JMX, IPMI und über den eigenen leichtgewichtigen Agenten.
- Push & Pull: Unterstützt sowohl Polling als auch Trapping als Datenerhebungsmethoden.
- Granulare Berechtigungen: Hervorragendes Multi-Tenancy und Benutzer-Berechtigungsmanagement.
Vorteile
- Komplett kostenlos: Die Software selbst verursacht keine Lizenzkosten.
- Robuste Alerting-Engine: Flexible Trigger-Ausdrücke und Eskalationsrichtlinien.
- Bei Skalierung bewährt: Seit Jahrzehnten in massiven Umgebungen im Einsatz.
Nachteile
- Veraltete UI: Die Oberfläche wirkt wie Enterprise-Software aus den mittleren 2000ern.
- Hoher Wartungsaufwand: Die Verwaltung der zugrunde liegenden Datenbank (PostgreSQL/MySQL) kann zum Vollzeitjob werden.
- Eingeschränkte Cloud-Native-Unterstützung: Auto-Scaling-Groups und kurzlebige Pods erfordern umständliche Discovery-Regeln.
Am besten für: Traditionelle Rechenzentren, Network Operations Centers (NOCs) und netzwerklastige Umgebungen.
Preis Die Software ist Open Source. Professionelle Deployments nutzen oft Zabbix Cloud, ab $50/Mo. Enterprise-Support ist ebenfalls ein kostenpflichtiger Service.
5. New Relic
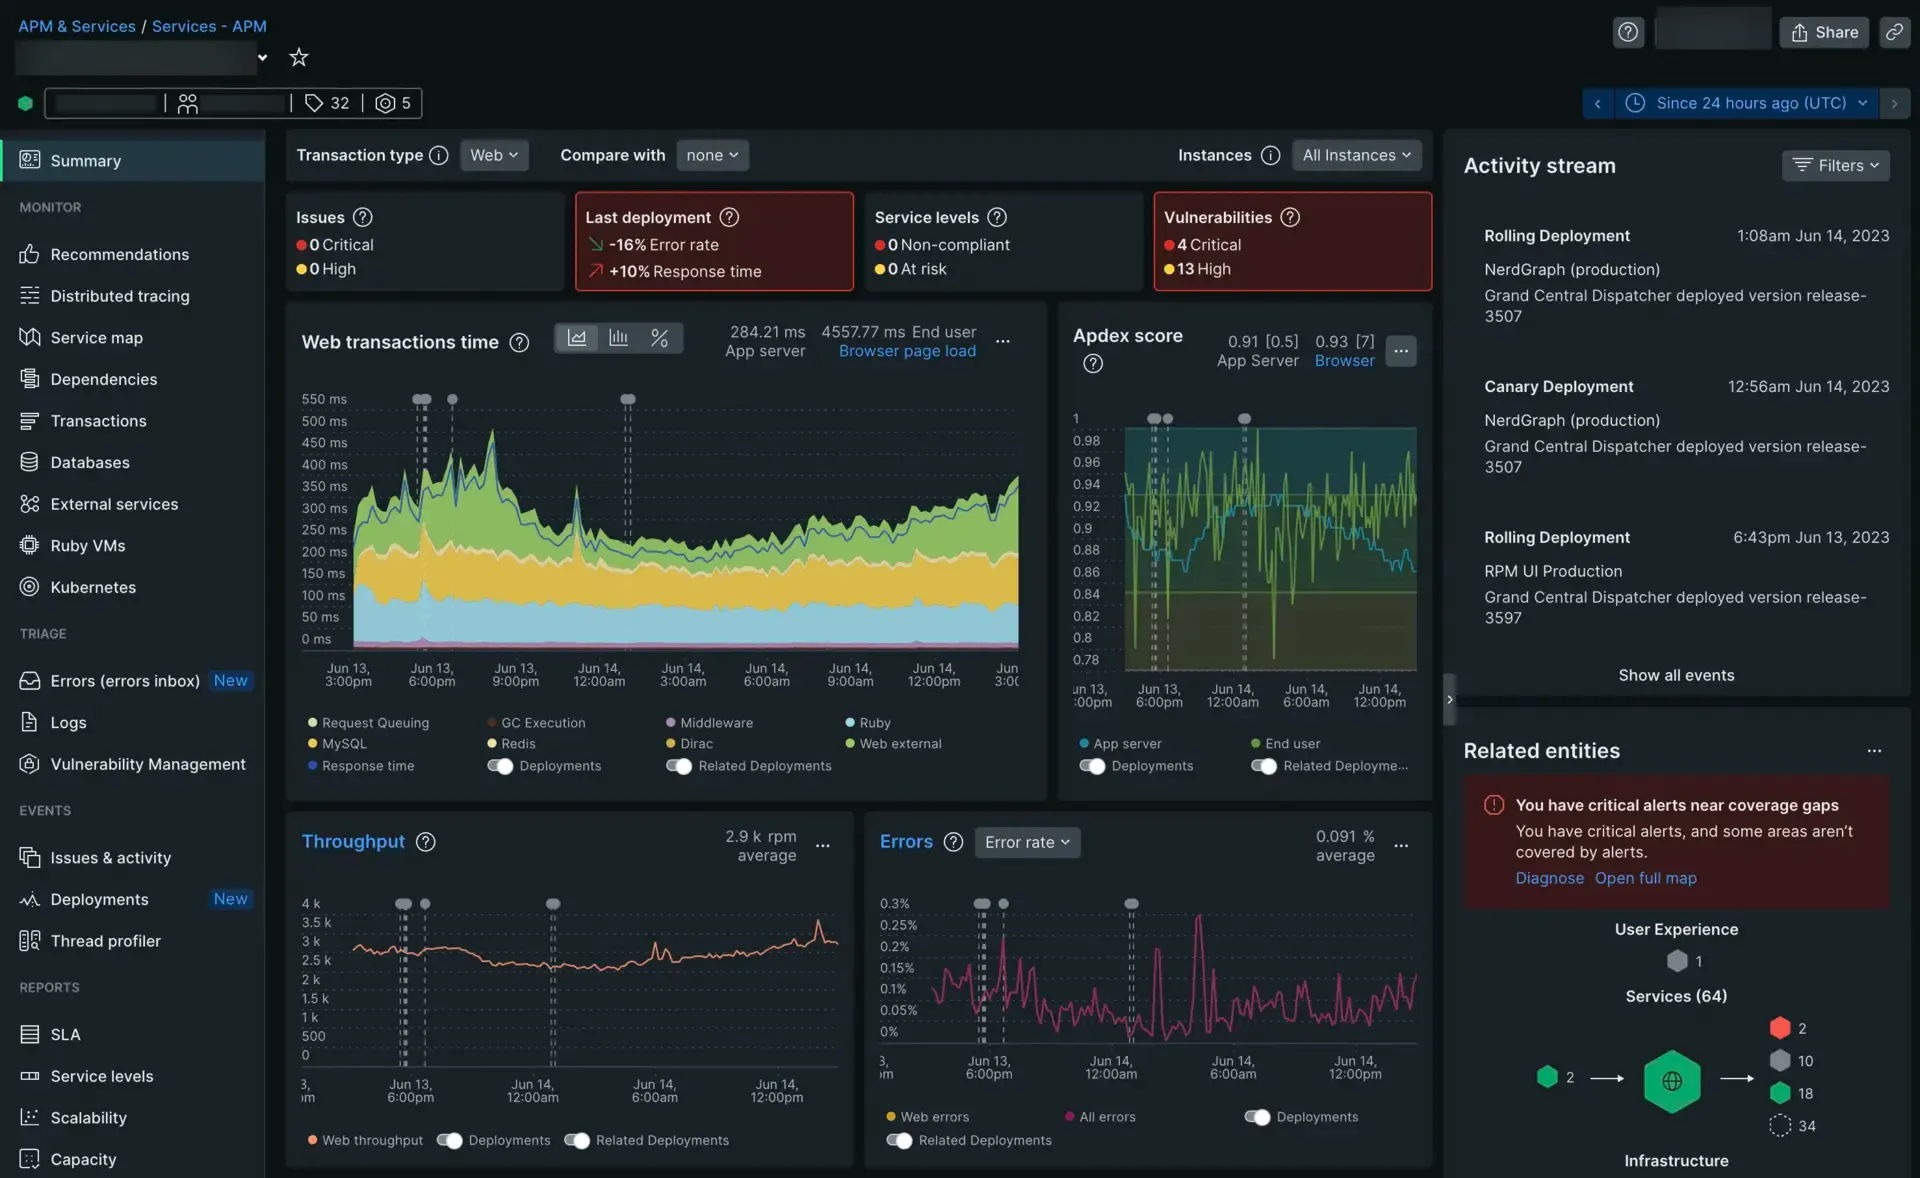
New Relic hat auf ein “Unified Data Platform”-Modell umgestellt. Ursprünglich ein Application-Performance-Tool, ist die Infrastrukturüberwachung mittlerweile eng integriert, sodass Sie direkt sehen können, wie sich die Servergesundheit auf die App-Latenz auswirkt.
Wichtigste Funktionen
- Deep APM: Code-Level-Tracing zur Identifizierung langsamer Datenbankabfragen oder ineffizienter Funktionen.
- Browser & Mobile: Native Unterstützung für End-User-Experience-Tracking auf Web- und Mobile-Apps.
- Applied Intelligence: KI-gestützte Insights zur Anomalieerkennung und Ereigniskorrelation über Ihren Stack hinweg.
Vorteile
- All-in-One-Transparenz: Metriken, Logs und Traces an einem Ort gespeichert.
- Großzügiger Free-Tier: 100 GB/Monat kostenlos für kleine Teams.
- Starke Abfragefähigkeiten: NRQL ist leistungsstark und gut zugänglich.
Nachteile
- Überwältigende UI: Die Plattform ist riesig, und die Navigation kann bei einfachen Anforderungen frustrierend sein.
- Pro-User-Preismodell: Full-Platform-User-Sitze werden teuer, wenn Ihr Team wächst.
Am besten für: Anwendungsorientierte Teams, die ein einzelnes Tool für den gesamten Stack suchen, insbesondere wo APM wichtig ist.
Preis Nutzungsbasiert: kostenlos für 100 GB/Monat. Kostenpflichtige Pläne beginnen bei $0,30/GB Ingestion plus Pro-User-Sitzgebühren ($99/Mo für Core, $549/Mo für Full Platform).
6. LogicMonitor
LogicMonitor ist eine SaaS-basierte, agentlose Monitoring-Plattform. Sie ist darauf ausgelegt, in hybriden Umgebungen einfach bereitgestellt zu werden, und nutzt einen “Collector”, der in Ihrem Netzwerk sitzt und automatisch nach Geräten scannt.
Wichtigste Funktionen
- Agentloses Deployment: Ein Collector pro Netzwerksegment übernimmt Discovery und Erfassung.
- Out-of-the-Box-Dashboards: Vorgefertigte Dashboards für die gängigsten Infrastrukturkomponenten.
- Intelligente Anomalieerkennung: Dynamische Schwellenwerte, die sich an Ihre Workload-Muster anpassen.
Vorteile
- Bequemes Deployment: Keine Pro-Host-Agent-Installation erforderlich.
- Tolle OOTB-Dashboards: Schnellerer Time-to-Value als die meisten Self-Host-Alternativen.
- Starke Hybrid-Unterstützung: Verwaltet On-Prem- und Cloud-Ressourcen über dieselbe Konsole.
Nachteile
- Für kleinere Umgebungen teuer: Unter einer bestimmten Skalierung lässt sich der Preis schwer rechtfertigen.
- Eingeschränkte Anpassbarkeit: Weniger flexibel als Open-Source-Tools für maßgeschneiderte Anforderungen.
Am besten für: Mittelständische Unternehmen mit einer Mischung aus Cloud- und physischer Infrastruktur, die SaaS-Komfort ohne Agent-Wildwuchs wünschen.
Preis Individuelle Preisgestaltung. Kontaktieren Sie LogicMonitor für ein Angebot.
7. Checkmk
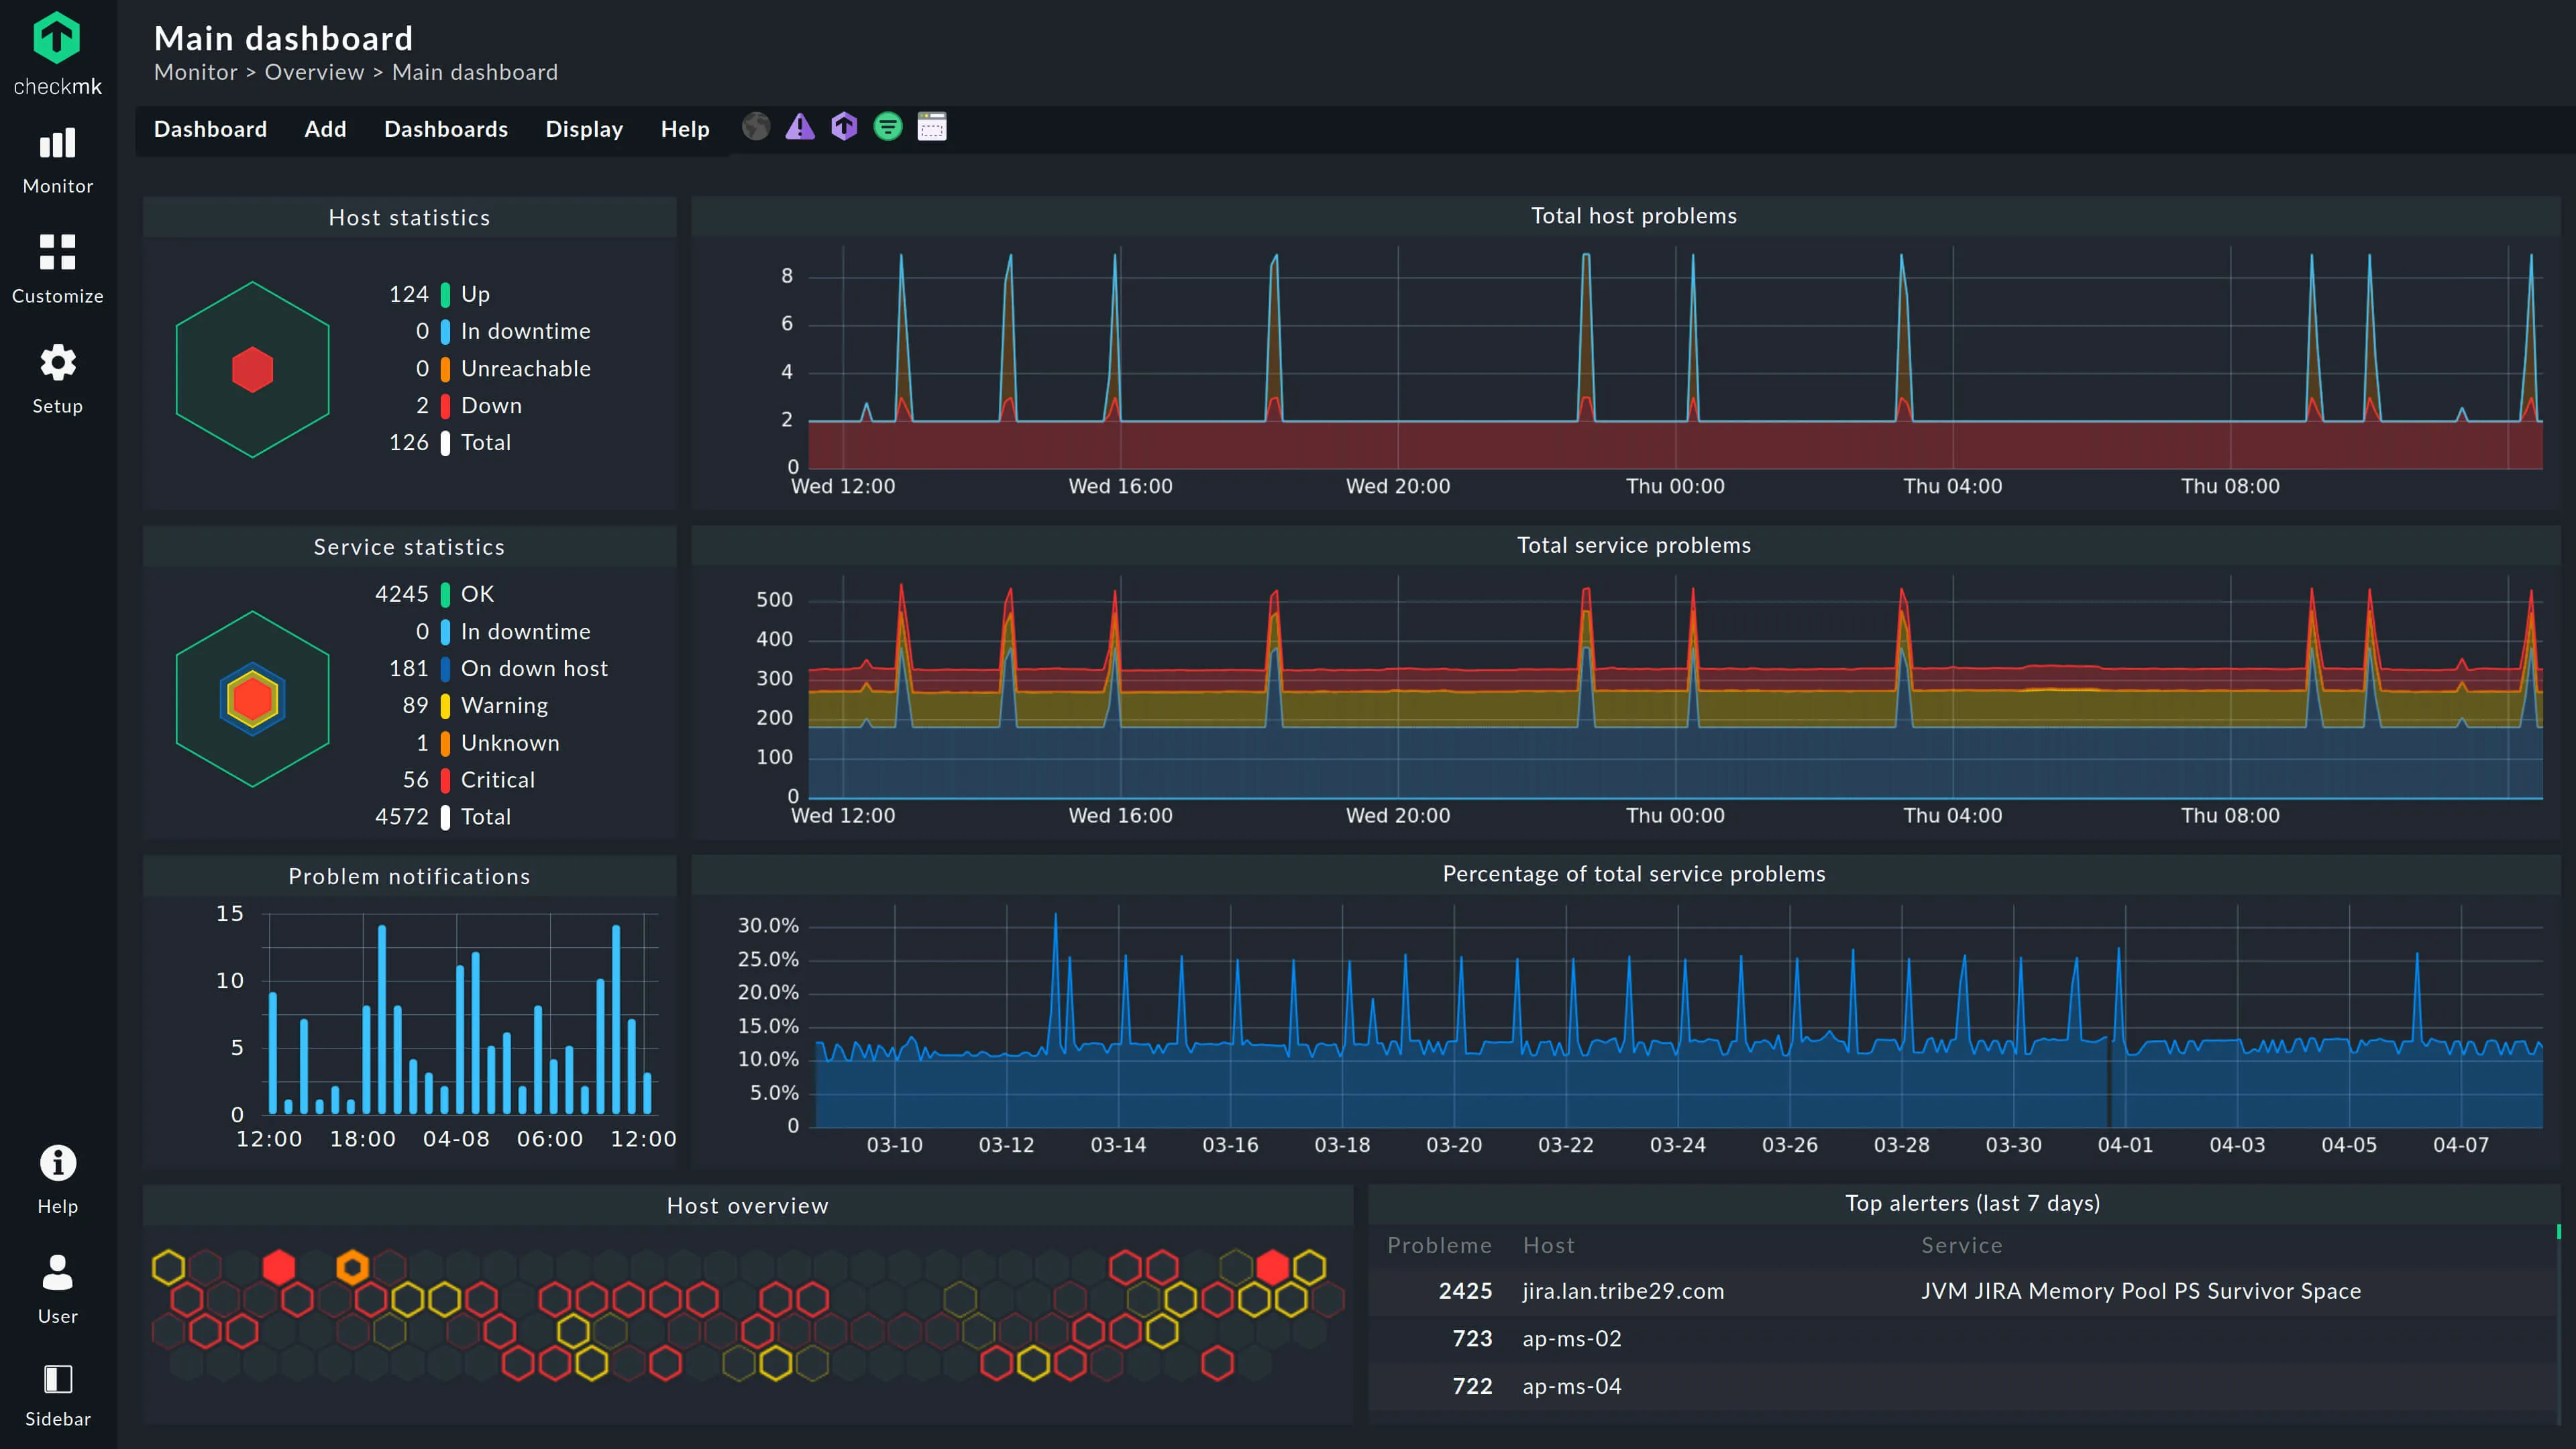
Checkmk ist für seine äußerst effiziente Monitoring-Engine bekannt. Es kann Tausende von Diensten mit sehr geringer CPU-Last überwachen und ist besonders in ITIL-konformen Umgebungen in Europa verbreitet.
Wichtigste Funktionen
- Automatisierte Service-Discovery: Scannt Hosts, um laufende Dienste automatisch zu finden und Prüfungen zu konfigurieren.
- 2.000+ Plugins: Massive Bibliothek an Integrationen, einschließlich Hardware, Switch-Ports und SAP-Systeme.
- Hybrides Monitoring: Gleichermaßen gut bei Bare Metal, Containern und Cloud-Instanzen.
Vorteile
- Effizienter Core: Deutlich ressourcenschonender als Nagios oder Zabbix bei gleichem Prüfvolumen.
- All-in-One: Verwaltet sowohl zustandsbasiertes (Up/Down) als auch metrikbasiertes Performance-Monitoring.
- Aktive Community: Die Checkmk Exchange bietet Hunderte Community-Erweiterungen.
Nachteile
- Veraltete UI: Funktional, aber wirkt überladen im Vergleich zu modernen SaaS-Tools.
- Steile Lernkurve: Das regelbasierte Konfigurationsmodell muss erst verinnerlicht werden.
Am besten für: Hochdichtes Monitoring, bei dem Effizienz oberste Priorität hat, und Sysadmins, die eine Mischung aus Legacy-Hardware und modernen Containern verwalten.
Preis Die Open-Source-Edition ist kostenlos. Enterprise beginnt bei ~$2.100/Jahr für 3.000 Dienste. SaaS-Editionen beginnen bei ~$6/Host/Mo.
8. Site24x7
Site24x7 (von Zoho) bietet eine breite Palette an Monitoring-Tools: Website-Uptime, Server-Monitoring, Netzwerk-Tracking und mehr. Es ist eine Cloud-basierte Lösung, die sehr einfach in Betrieb zu nehmen ist.
Wichtigste Funktionen
- Breite Abdeckung: Überwacht Server, Websites (Synthetics), Netzwerke und Mobile Apps von einem Ort aus.
- RUM & Synthetics: Integriertes Real-User-Monitoring und synthetische Transaktionsprüfungen.
- Bezahlbare Bundles: Preisgestaltung basiert auf Bundles statt auf Pro-Metrik-Abrechnung.
Vorteile
- Sehr bezahlbar: Eine der kostengünstigsten All-in-One-Optionen auf dem Markt.
- Einfach einzurichten: Minimale Konfiguration erforderlich, um zu starten.
- Breiter Funktionsumfang: Deckt viel ab, ohne mehrere Tools zu benötigen.
Nachteile
- Weniger Tiefe: Nicht so spezialisiert oder anpassbar wie dedizierte Monitoring-Tools.
- Überladene UI: Die Oberfläche kann angesichts der Funktionsbreite überwältigend wirken.
Am besten für: Kleine bis mittlere Unternehmen, die eine einfache, bezahlbare SaaS-Lösung suchen, die mehrere Monitoring-Anforderungen abdeckt.
Preis Pläne ab $9/Mo. Die Preisgestaltung hängt von der Anzahl der Monitore und der gewählten Datenaufbewahrung ab.
9. Netdata
Netdata ist einzigartig, da es standardmäßig eine Auflösung pro Sekunde bietet. Es ist darauf ausgelegt, auf jedem Server installiert zu werden, um Ihnen einen unmittelbaren, hochaufgelösten Blick darauf zu geben, was gerade passiert.
Wichtigste Funktionen
- 1-Sekunden-Auflösung: Echtzeit-Metriken mit fast keiner Latenz von der Erfassung bis zur Visualisierung.
- Unsupervised ML: Integrierte Anomalieerkennung, die Ausreißer ohne manuelle Schwellenwerte markiert.
- Auto-Discovery: Erkennt automatisch laufende Dienste und Anwendungen auf dem Host.
Vorteile
- Zero Configuration: Installieren und sofort schöne Echtzeit-Diagramme erhalten.
- Extrem geringer Overhead: Leichtgewichtig genug für eingeschränkte Hardware.
- Kostenlos und Open Source: Das Kernprodukt kostet nichts beim Self-Hosting.
Nachteile
- Node-zentriertes Design: Historisch besser darin, einzelne Nodes zu überwachen, als eine globale Infrastrukturansicht zu bieten (wobei Netdata Cloud dies zunehmend verbessert).
- Kein natives Tracing: Hauptsächlich ein Metrik-Tool; Logs sind eine neuere, noch ausreifende Ergänzung.
Am besten für: Echtzeit-Fehlersuche und Low-Level-Performance-Tuning auf einzelnen Hosts.
Preis Open Source (kostenlos, Self-Hosted). Netdata Cloud hat einen Free-Tier und kostenpflichtige Pläne für zentralisiertes Management.
10. Nagios XI
Nagios ist der “Großvater” des Monitorings. Nagios XI ist die kommerzielle Version, die dem Core-Engine eine Weboberfläche und einfachere Konfiguration hinzufügt, gestützt durch das größte Plugin-Ökosystem der Welt.
Wichtigste Funktionen
- Massive Plugin-Bibliothek: Wenn es eine IP-Adresse hat, gibt es mit ziemlicher Sicherheit ein Nagios-Plugin dafür.
- Binäres Status-Alerting: Felsolide OK/CRITICAL/WARNING-Alerting-Logik.
- Konfigurations-Assistenten: XI fügt Point-and-Click-Setup über dem Core-Nagios-Engine hinzu.
Vorteile
- Universelle Kompatibilität: Überwacht praktisch jedes Gerät, Protokoll oder jeden Dienst.
- Bewährte Zuverlässigkeit: Äußerst stabile Technologie mit Jahrzehnten im Produktionseinsatz.
Nachteile
- Erhebliches Fachwissen erforderlich: Die ordnungsgemäße Einrichtung und Wartung von Nagios ist eine technische Herausforderung.
- Veraltete Architektur: Wirkt antiquiert im Vergleich zu modernen SaaS- oder Cloud-nativen Tools.
- Metriken sind sekundär: Nagios ist fundamental ein Status-Check-Tool, keine Graphing-Plattform.
Am besten für: Organisationen mit sehr spezifischen oder Legacy-Monitoring-Anforderungen oder Umgebungen, in denen nur ein Nagios-Plugin für ein bestimmtes Hardware-Teil existiert.
Preis Nagios Core ist kostenlos (Open Source). Nagios XI beginnt bei $2.495 für eine Standardlizenz (bis 100 Nodes).
Wie man die richtige Lösung wählt
Die beste IT-Infrastruktur-Monitoring-Lösung ist die, die Ihr Team tatsächlich nutzt und pflegt. Beginnen Sie damit, zwei Dinge zu prüfen: wie viele Cloud- vs. On-Prem-Nodes Sie haben und wie viel Zeit Ihr Team realistisch für die Tool-Wartung aufwenden kann.
Wenn Sie ein großes Budget und ein dediziertes Observability-Team haben, sind Datadog oder Prometheus ausgezeichnete Entscheidungen. Wenn Sie ein kleineres Team sind oder es leid sind, Wochenenden mit der Reparatur Ihres Monitoring-Stacks zu verbringen, tendieren Sie zu Zero-Config-Optionen wie Simple Observability oder SaaS-Tools wie LogicMonitor oder Site24x7.
Das richtige Tool sollte sich wie ein Kraftmultiplikator anfühlen, nicht wie eine weitere Aufgabe auf Ihrer To-Do-Liste.