



- Wer eine schnelle, benutzerfreundliche Lösung sucht, die Metriken und Logs ohne steile Lernkurve kombiniert, für den ist Simple Observability die erste Wahl.
- Wer maximale Flexibilität und ein großes Funktionsangebot braucht und eine komplexe Einrichtung in Kauf nimmt, ist mit Checkmk und Zabbix gut bedient.
- Netdata eignet sich ideal für Echtzeit-Monitoring und Anomalieerkennung, während Nagios eine hochgradig skalierbare und anpassbare Lösung für Enterprise-Anforderungen bietet, deren Oberfläche allerdings veraltet wirkt.
Server-Monitoring ist kein Luxus. Es spielt eine große Rolle, unabhängig von den Diensten, die Sie tatsächlich betreiben.
Es ist ein leichtgewichtiges Sicherheitsnetz, das Ihre App online, Ihre Daten sicher und Ihr Stressniveau im Griff behält. Tool-spezifische Vergleiche finden Sie in unseren Guides zu Netdata-Alternativen, Zabbix-Alternativen und der Nagios-Alternative.
Wenn Sie schon einmal um 2 Uhr morgens per SSH auf einen Server mussten, um herauszufinden, warum ein Dienst ausgefallen ist, kennen Sie den Druck. Sichtbarkeit ist in solchen Momenten entscheidend.
Was sind die besten Server-Monitoring-Tools? Hier sind die 5 besten Monitoring-Tools auf dem Markt heute.
Was soll überwacht werden?
Bevor wir uns den Tools widmen, ist es wichtig zu verstehen, was Sie eigentlich überwachen sollten. Server erzeugen eine riesige Datenmenge, aber die Konzentration auf die richtigen Metriken liefert Ihnen frühe Warnungen, wenn etwas schiefgeht. Hier folgt eine Übersicht der nützlichsten Aspekte, die Sie im Auge behalten sollten.
Uptime
Die grundlegendste, aber entscheidende Metrik: Ist Ihr Server online? Uptime-Monitoring stellt sicher, dass Sie sofort erfahren, wenn ein Server oder Dienst unerreichbar wird. Selbst wenige Minuten Ausfallzeit können zu verlorenem Umsatz, gebrochenem Nutzervertrauen oder kaskadierenden Ausfällen in Ihrer Infrastruktur führen.
Wenn Sie Uptime-Prüfungen mit Alerting kombinieren, werden Sie in der Sekunde benachrichtigt, in der etwas ausfällt, und nicht erst, wenn Ihre Nutzer es melden.
Systemkern-Metriken
Im Mittelpunkt jedes Servers stehen die grundlegenden Ressourcen:
- CPU-Auslastung: Hohe oder anhaltende CPU-Belastung kann Prozesse verlangsamen, auf uncontrollierte Tasks oder sogar auf Malware hinweisen.
- Speichernutzung: Wenn RAM zur Neige geht, kommt es zu Performance-Engpässen und im schlimmsten Fall zu Systemabstürzen oder Swapping, das alles ausbremst.
- Festplattennutzung und I/O: Eine volle Festplatte oder eine überlastete I/O-Pipeline kann Ihr System unbemerkt lahmlegen. Die Überwachung von Speicherplatz und Durchsatz hilft Ihnen, Ausfallzeiten zu vermeiden.
Stellen Sie sich diese Werte als das Fundament der Servergesundheit vor. Wenn sie kompromittiert sind, leidet alles, was darauf aufbaut.
Netzwerk-Metriken
Die Netzwerkaktivität Ihres Servers ist ein weiteres wichtiges Puzzleteil. Ein plötzlicher Anstieg der Bandbreite (eingehend oder ausgehend) kann vieles bedeuten:
- Einen Distributed-Denial-of-Service-Angriff (DDoS).
- Eine falsch konfigurierte Anwendung, die Traffic leakt.
- Datenabfluss ohne Ihr Wissen.
Wenn Sie Traffic-Volumen, Verbindungszahlen und Latenz genau überwachen, erhalten Sie Transparenz bei Performance-Problemen und potenziellen Sicherheitsvorfällen.
Webserver-Metriken
Wenn Ihr Server Anwendungen oder Websites hostet, sind Web-Traffic-Kennzahlen unentbehrlich:
- Requests per Second (RPS): Zeigt, wie viel Last Ihr Server zu einem bestimmten Zeitpunkt bewältigt. Plötzliche Sprünge können auf Popularität oder Missbrauch hindeuten.
- Fehlerrate (4xx/5xx-Antworten): Eine steigende Fehlerrate weist oft auf fehlerhaften Code, überlastete Ressourcen oder externe Faktoren wie eine ausfallende Abhängigkeit hin.
Zusammen geben diese Metriken Ihnen ein klares Bild dessen, was hinter den Kulissen passiert. Sie helfen Ihnen, von reaktiver Brandbekämpfung (“Die Seite ist down!”) zu proaktivem Monitoring (“Wir sehen, dass die Fehler hochschnellen, beheben wir es, bevor Nutzer sich melden”) überzugehen.
Zusammenfassung der besten Server-Monitoring-Tools
| Vorteile | Nachteile | |
|---|---|---|
| Simple Observability | Einfachheit und Benutzerfreundlichkeit, Installation mit einem Befehl, vereinheitlichte Metriken und Logs, transparente Preisgestaltung, Open-Source-Agent | Eingeschränkte Anpassbarkeit für fortgeschrittene Nutzer. |
| Checkmk | Umfassend mit über 2.000 Plugins, flexibel für agentenbasiertes/agentloses Monitoring, automatisierte Service-Discovery. | Steile Lernkurve, komplexe Konfiguration. |
| Netdata | Echtzeit-Datenerfassung in hoher Auflösung, ML-basierte Anomalieerkennung, sofortiger Time-to-Value. | Wichtige Funktionen wie APM und Log-Management sind noch ausstehend, und einige Nutzer bemängeln fehlende Detaildokumentation. |
| Zabbix | Hochgradig skalierbar für große Umgebungen, Multi-Tenancy-Support, fortschrittliche Problemerkennung. | Steile Lernkurve, unzureichende Dokumentation, einige Nutzer berichten von Schwierigkeiten beim Log-Management. |
| Nagios | Äußerst flexibel und anpassbar mit riesiger Plugin-Basis, skalierbar für große und verteilte Umgebungen, Konfigurations-Assistenten. | Steile Lernkurve, veraltete Oberfläche, hohe Kosten für die Enterprise-Version. |
Tests
Simple Observability
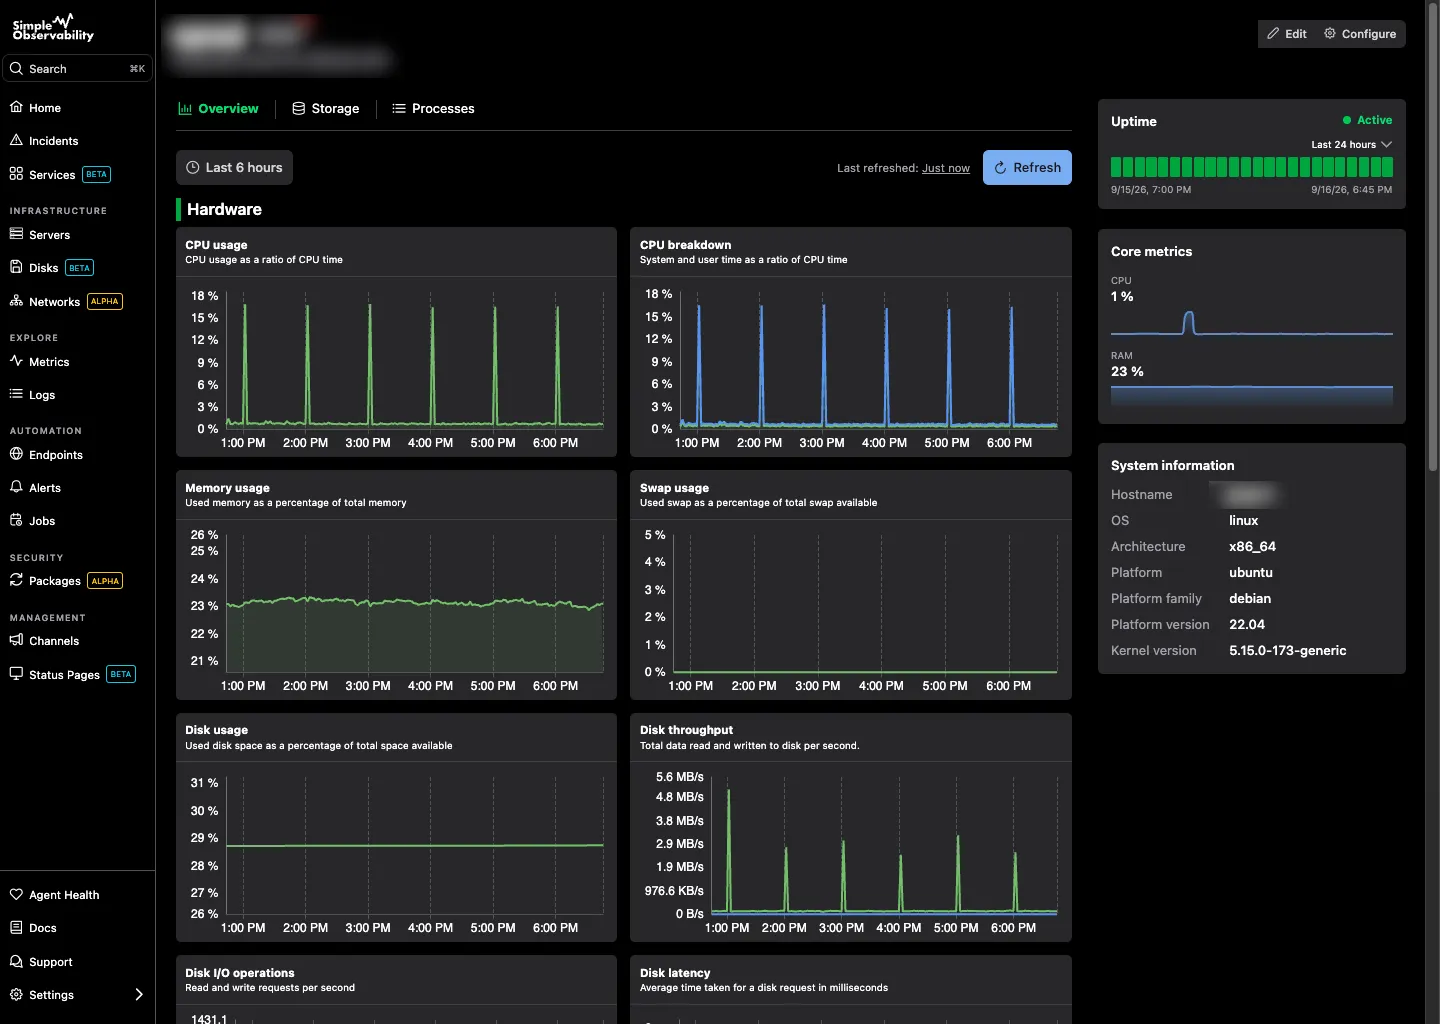
Simple Observability ist eine Server-Monitoring-Plattform, die als unkomplizierte und wirksame Lösung für Unternehmen und Einzelpersonen entwickelt wurde. Sie zeichnet sich durch ein “All-in-One”-Erlebnis aus und kombiniert Metriken und Logs in einer einheitlichen Oberfläche, um Nutzern ein vollständiges Bild der Servergesundheit ohne die Komplexität anderer Monitoring-Tools zu vermitteln.
Die Kernphilosophie der Plattform ist Einfachheit, von der Agent-Installation mit einem Befehl bis zur webbasierten Konfiguration, die manuelle Dateibearbeitung überflüssig macht.
Sie bietet gebrauchsfertige Berichte und Alerts und ermöglicht Nutzern, sofort Erkenntnisse zu gewinnen und Alert-Bedingungen in Sekunden zu definieren.
Der Open-Source-Agent ist transparent, prüfbar und für eine breite Palette von Linux-Distributionen ausgelegt.
Wichtigste Funktionen
- Installation mit einem Befehl: Der Open-Source-Agent lässt sich mit einem einzigen Befehl installieren, was Einrichtungszeit und Komplexität erheblich reduziert.
- Vereinheitlichtes Monitoring: Kombiniert Metriken und Logs in einem einzigen, einheitlichen System und bietet eine ganzheitliche Sicht auf die Server-Performance.
- Web-UI-Konfiguration: Alle Konfigurationen, von Metriken bis zu Alerts, werden über eine intuitive Weboberfläche verwaltet, ohne dass komplexe Konfigurationsdateien nötig sind.
- Mobilfreundlich: Bietet eine Progressive Web App (PWA), um die Infrastruktur von überall zu überwachen und Alerts zu empfangen.
Vorteile
- Einfachheit und Benutzerfreundlichkeit: Die Plattform ist auf schnelle Einarbeitung ausgelegt, auch für Nutzer mit geringen Monitoring-Kenntnissen.
- Transparente Preisgestaltung: Simple Observability bietet ein klares, Festpreis-Modell ohne nutzungsbasierte Überraschungen, was ein erheblicher Vorteil gegenüber Wettbewerbern sein kann.
- Open-Source-Agent: Die Open-Source-Natur des Agenten sorgt für Transparenz und ermöglicht es Nutzern, den Code zu prüfen.
Nachteile
- Eingeschränkte Anpassbarkeit: Die Einfachheit ist ein Vorteil, kann aber für fortgeschrittene Nutzer ein Nachteil sein, die mehr granulare Kontrolle und Anpassbarkeit über die integrierten Funktionen hinaus wünschen.
Preis
Simple Observability bietet einen kostenlosen Plan und einfache Pro-Server-Preisgestaltung:
- Kostenlos: ein Server, 50 Metriken, niedriges Log-Volumen.
- Kostenpflichtig: $3 pro Monat pro Server, 100 Metriken pro Server, hohes Log-Volumen, unbegrenzte Server.
- Individuell: Mengenrabatte und individuelle Aufbewahrung für große Infrastrukturen.
Checkmk
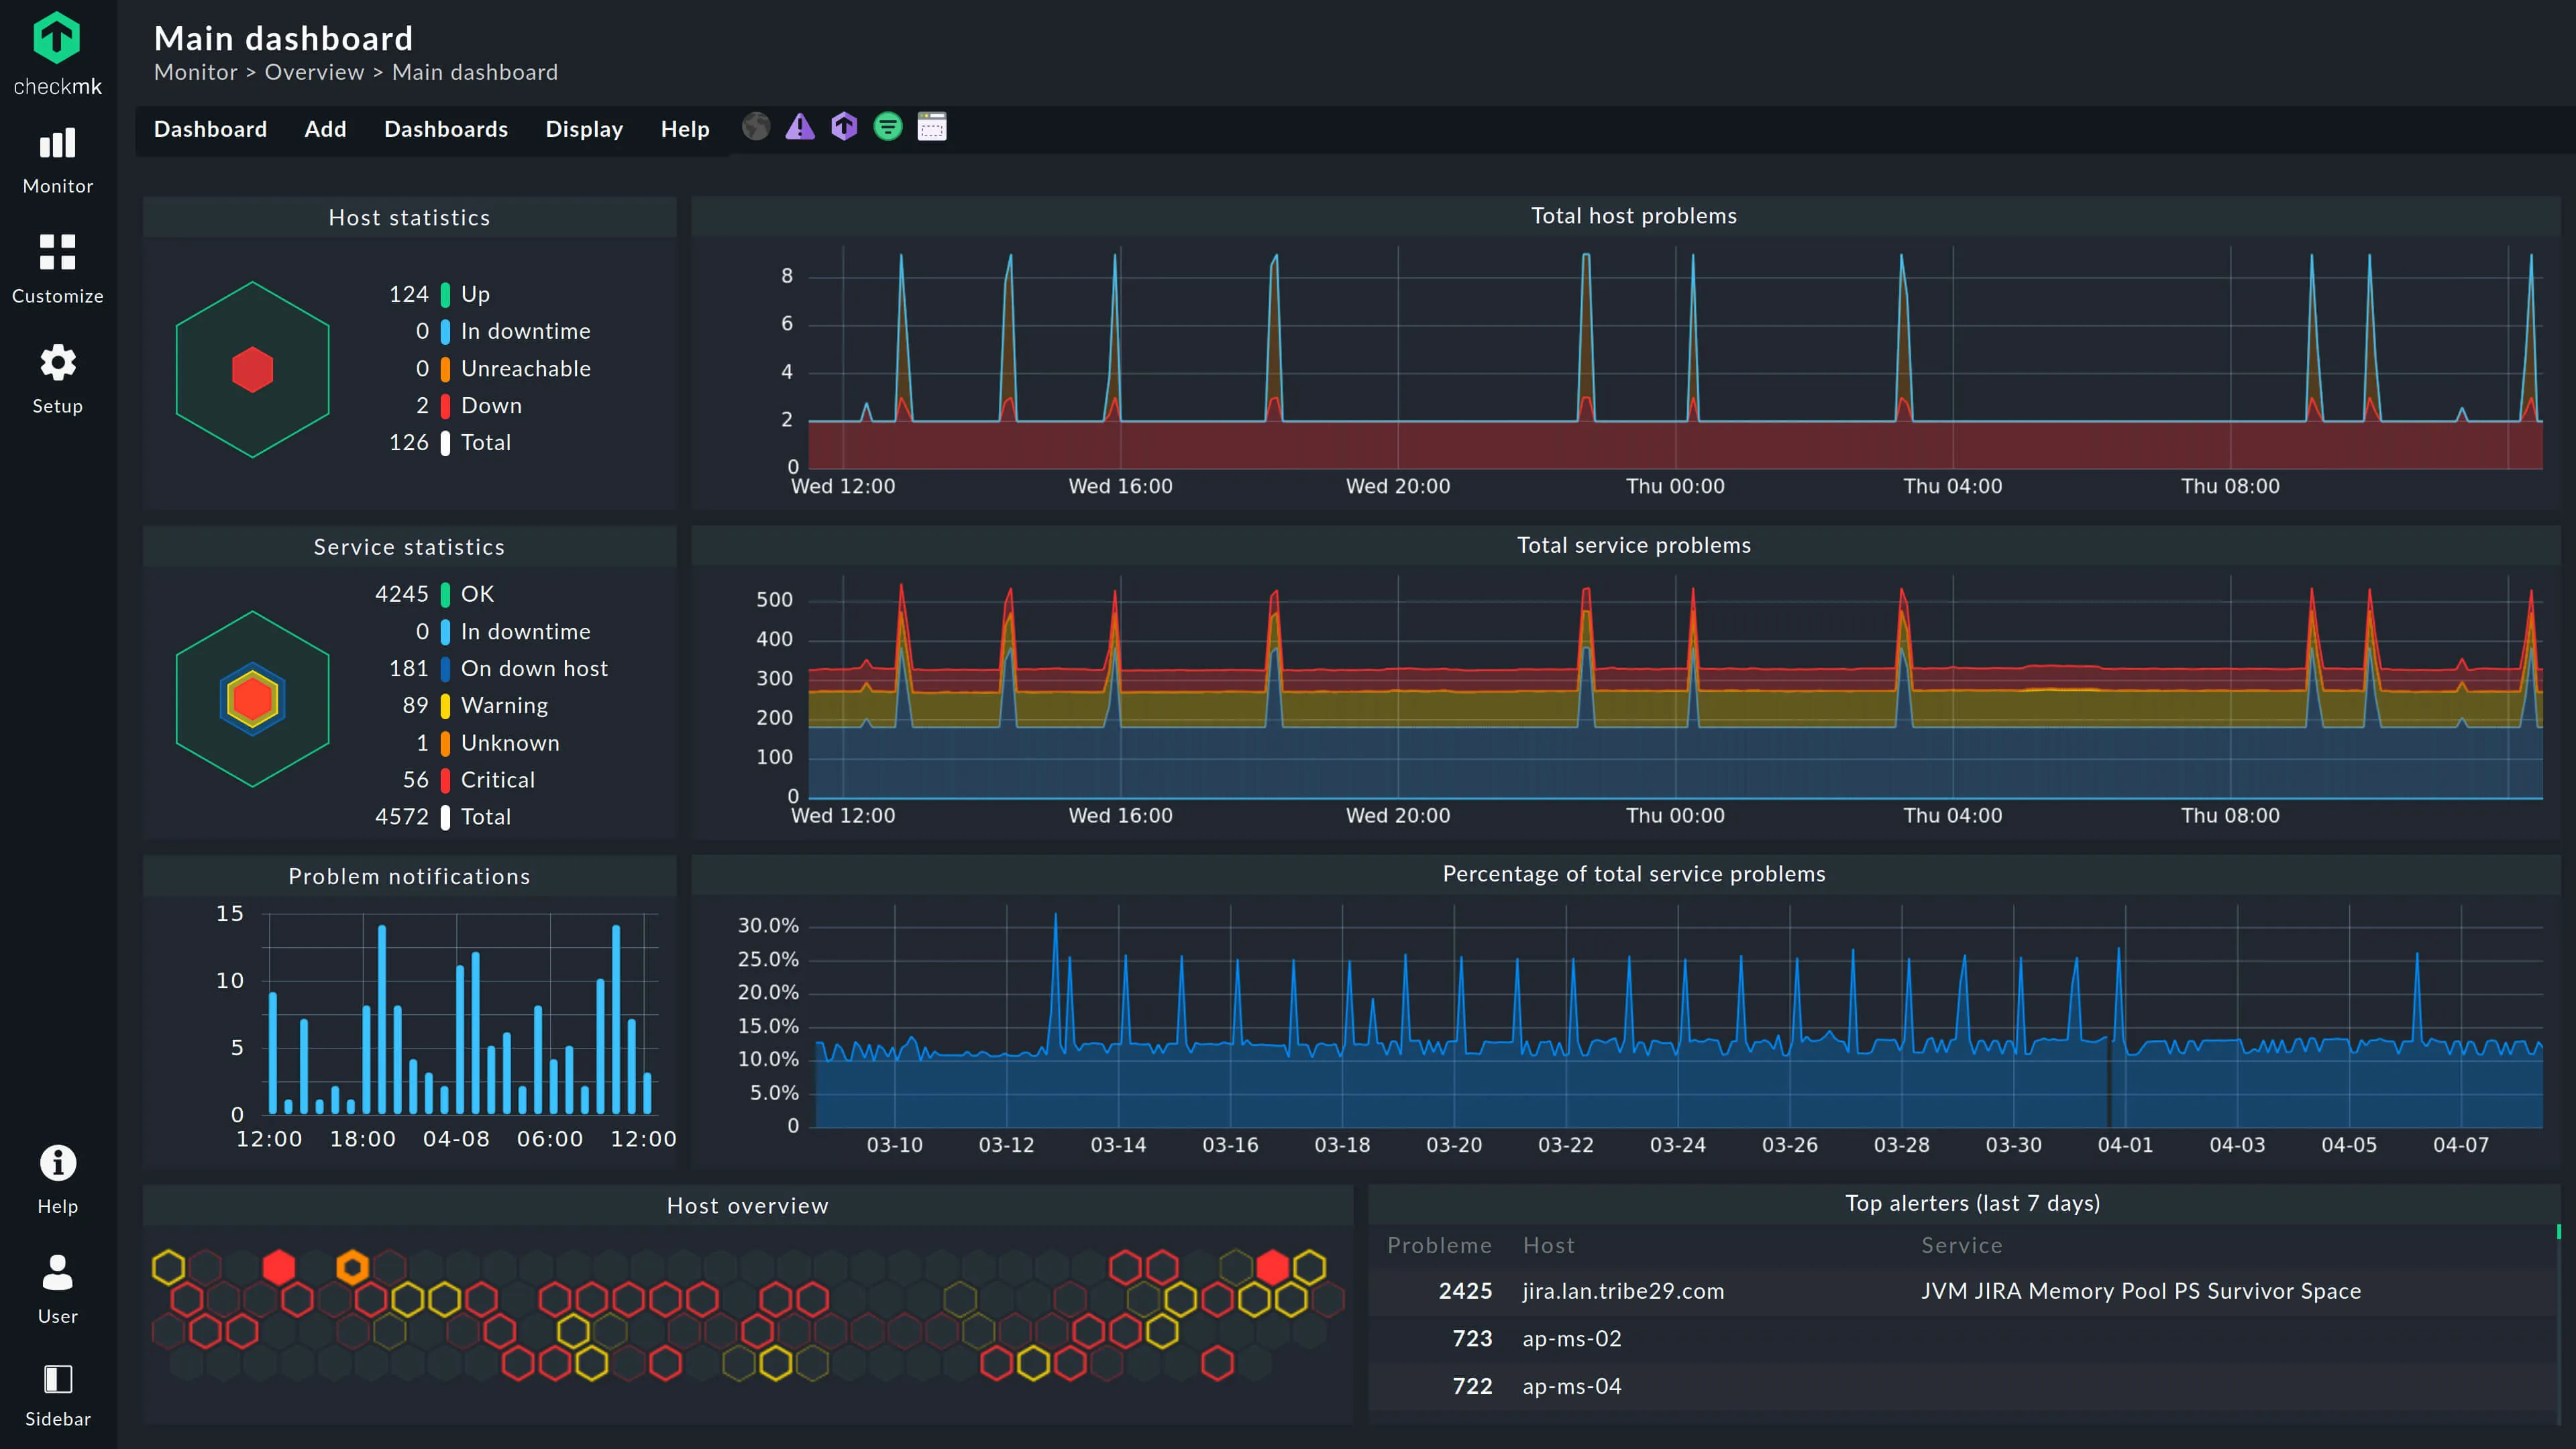
Checkmk ist eine umfassende Open-Source-Monitoring-Plattform für Anwendungen, Server und Netzwerke, sowohl On-Premises als auch in der Cloud. Sie wurde entwickelt, um alles von den einfachsten bis zu den komplexesten IT-Umgebungen mühelos zu überwachen.
Checkmk bietet über 2.000 Monitoring-Plugins für eine breite Palette von Geräten, darunter Server, Switches, Datenbanken und Webserver.
Die kostenlose Community-Edition wird selbst gehostet, hat einen eingeschränkten Funktionsumfang und unterstützt sowohl agentenbasiertes als auch agentloses Monitoring.
Checkmk kann Ihr Netzwerk zudem automatisch erkennen und kartieren.
Wichtigste Funktionen
- Automatische Service-Discovery: Erkennt automatisch alle relevanten Komponenten auf einem Host und empfiehlt geeignete Metriken und Schwellenwerte für das Monitoring.
- Visualisierung: Bietet moderne, anpassbare Dashboards und grafische Karten.
Vorteile
- Umfassend: Überwacht eine breite Palette von IT-Komponenten, von Cloud-Diensten bis zu On-Premises-Systemen, mit einer riesigen Bibliothek von über 2.000 Plugins.
- Flexibel: Unterstützt agentenbasiertes und agentloses Monitoring und ist hochgradig anpassbar und erweiterbar.
- Automatisiert: Reduziert manuellen Aufwand durch Funktionen wie Auto-Discovery, Host-Lifecycle-Management und eine leistungsstarke REST-API.
Nachteile
-
Lernkurve & schwierige Konfiguration: Das Tool ist leistungsstark, kann aber eine steile Lernkurve aufweisen.
Einige Nutzer finden die Konfiguration komplex, insbesondere bei fortgeschrittenen Funktionen.
Preis
Checkmk bietet ein Self-Host-Modell mit kostenpflichtigen Lizenzen ab ca. $225 pro Monat, typischerweise für mindestens 100 Hosts.
Es ist auch ein SaaS-Modell verfügbar, das bei ca. $6 pro Host und Monat liegt. Die Preisgestaltung basiert auf der Anzahl der überwachten Dienste, wobei ein Host durchschnittlich etwa 30 Dienste aufweist.
Jede Gruppe von 10 Diensten wird mit ca. $2 pro Monat abgerechnet, was die Kosten schnell steigen lassen kann.
Netdata
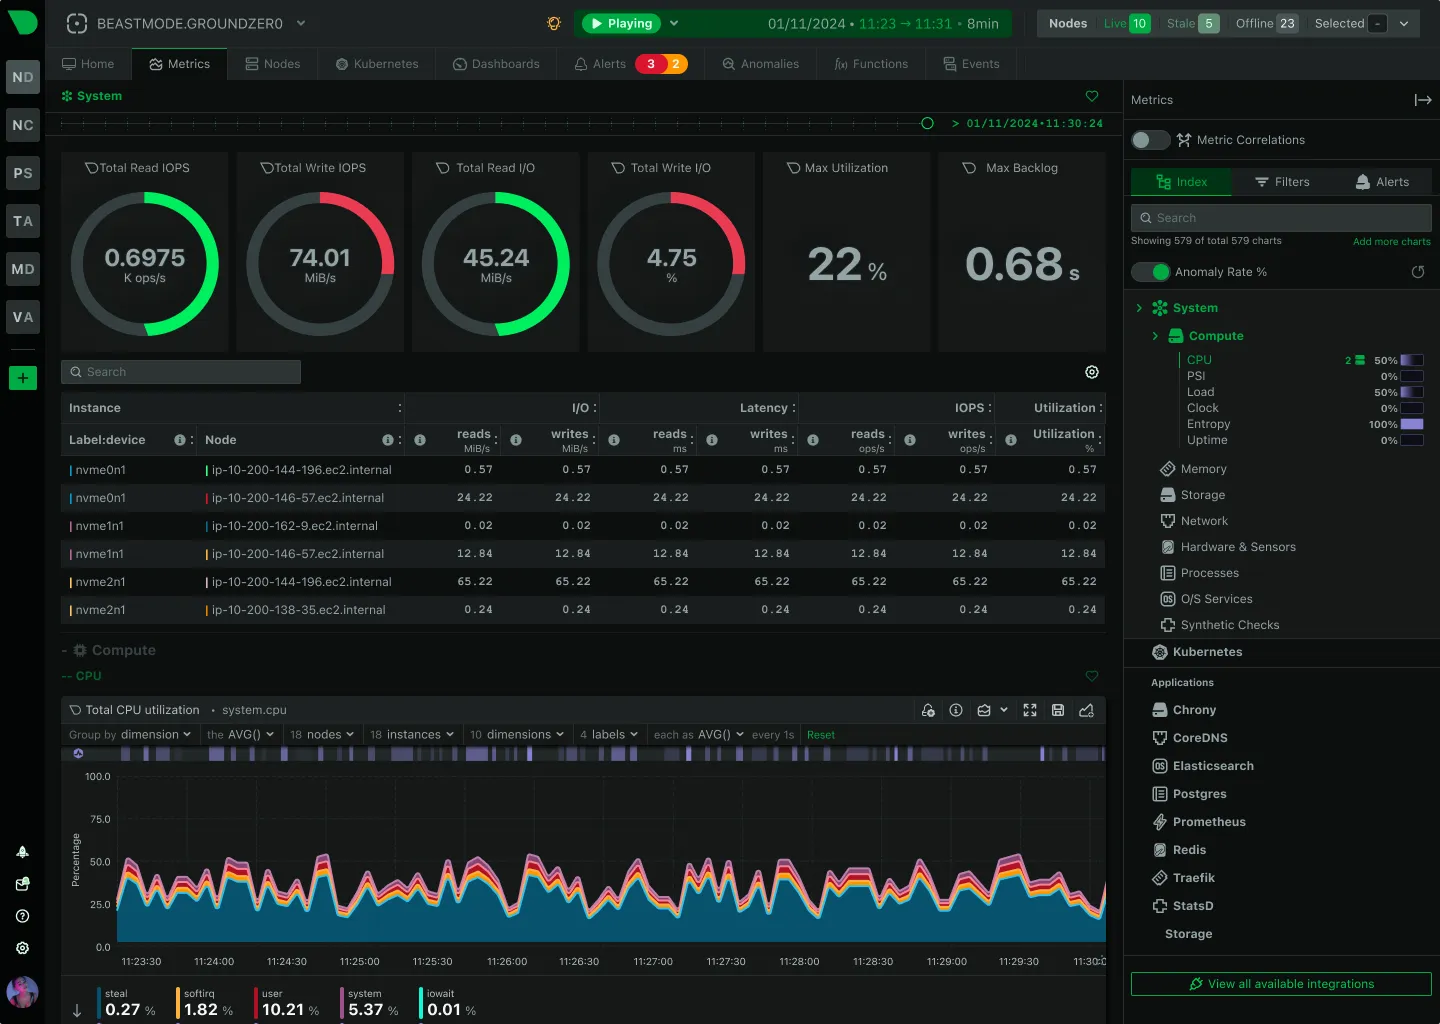
Netdata ist eine Open-Source-Plattform für Echtzeit-Performance-Monitoring und Fehlersuche für Systeme und Anwendungen. Sie wurde entwickelt, um hochaufgelöste, sekündliche Datenerfassung zu liefern, was sie ideal für sofortige und proaktive Problemerkennung macht. Mit ihrer dezentralen Architektur kann Netdata gesamte Infrastrukturen überwachen, von einem einzelnen Server bis zu großen, verteilten Umgebungen.
Netdata bietet eine integrierte All-in-One-Observability-Lösung, die Metriken, Logs, synthetische Prüfungen und Alerts abdeckt.
Sie verfügt über ML-basierte Anomalieerkennung und liefert klare, verwertbare Erkenntnisse, ohne dass umfangreiches Data-Science-Wissen erforderlich ist.
Die automatische Erkennung und vorkonfigurierten Alerts der Plattform reduzieren den manuellen Einrichtungsaufwand und ermöglichen ein schnelles Time-to-Value für Teams.
Wichtigste Funktionen
- Echtzeit-Datenerfassung in hoher Auflösung: Erfasst jede Sekunde Metriken und bietet sofortiges Feedback mit geringer Latenz.
- ML-basierte Anomalieerkennung: Nutzt Unsupervised Machine Learning, um Workload-Muster automatisch zu erlernen und Anomalien zu erkennen.
Vorteile
- Sofortiger Time-to-Value: Automatische Erkennung von Datenquellen und vorkonfigurierte Alerts ermöglichen die sofortige Nutzung nach der Installation.
- Datenschutz: Daten werden On-Premise gespeichert, sodass sie auf der Infrastruktur des Nutzers bleiben.
Nachteile
- Fehlende Funktionen: Wichtige Funktionen wie Application Performance Monitoring (APM) und Log-Management sind noch ausstehend oder nicht vollständig implementiert, was ein umfassendes Monitoring einschränken kann.
- Daten- und Reporting-Einschränkungen: Nutzer haben von Schwierigkeiten mit unzureichenden Informationen berichtet, insbesondere bei detaillierten Berichten und der Dokumentation von Integrationen.
Preis
Netdata bietet ein Abonnementmodell für $6 pro Monat und Node an.
Zabbix
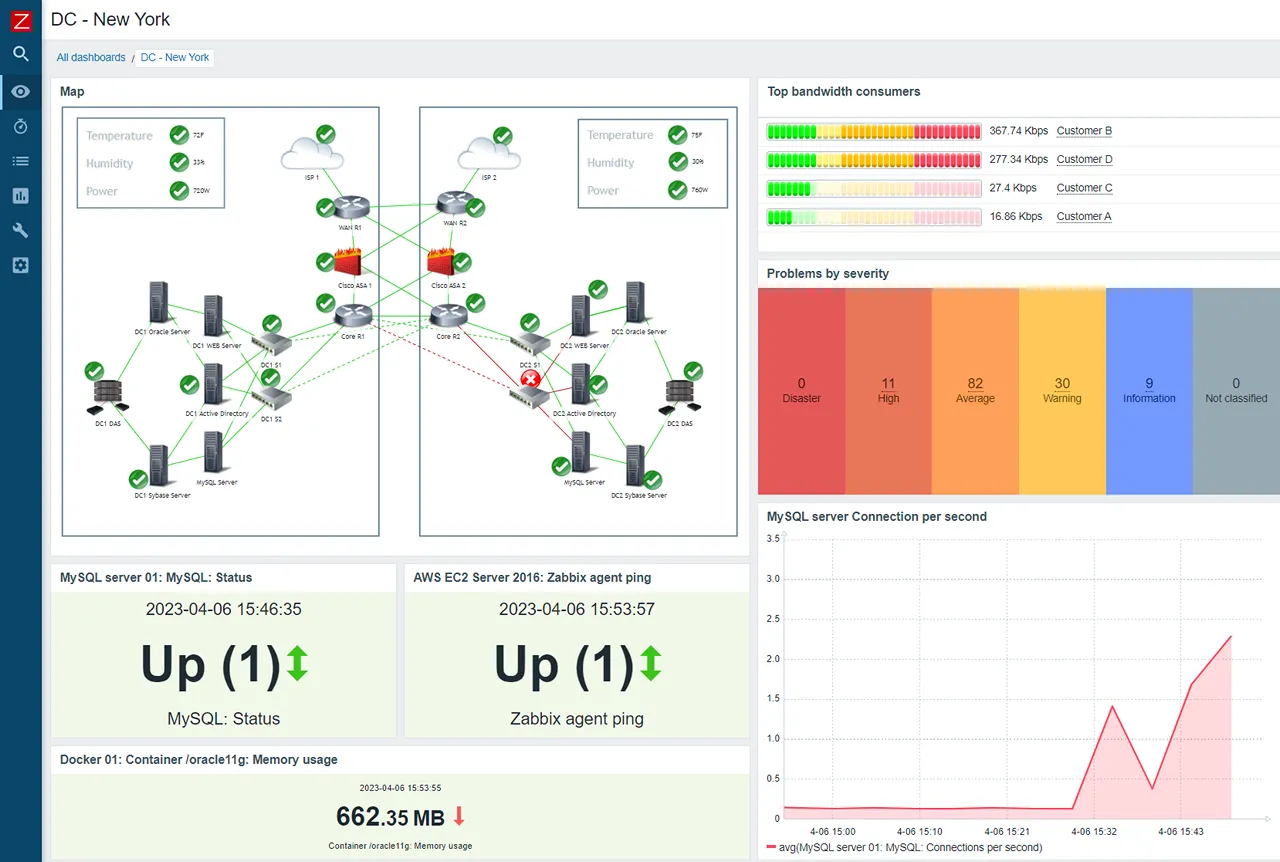
Zabbix ist eine Open-Source-Enterprise-Software zur Überwachung verschiedener IT-Komponenten, darunter Netzwerke, Server, virtuelle Maschinen und Cloud-Dienste. Sie wurde für groß angelegte Umgebungen entwickelt.
Eine der Hauptstärken von Zabbix ist die Fähigkeit, Daten aus praktisch jeder Quelle über eine breite Palette von Protokollen und benutzerdefinierten Methoden zu sammeln. Das robuste Alerting-System der Plattform bietet mehrere Kanäle und Eskalationsschemata, um sicherzustellen, dass kritische Probleme umgehend behandelt werden.
Wichtigste Funktionen
- Fortschrittliche Problemerkennung: Nutzt intelligente Schwellenwerte, Trendvorhersage und Machine Learning, um Anomalien automatisch zu erkennen und Probleme mit mehreren Schweregradstufen zu klassifizieren.
- Flexibles Alerting: Unterstützt eine Vielzahl von Benachrichtigungskanälen wie E-Mail, SMS und Instant Messaging, mit anpassbaren Nachrichten und Eskalationsszenarien.
Vorteile
- Hohe Skalierbarkeit: Die verteilte Monitoring-Architektur, unterstützt durch Zabbix-Proxys, ermöglicht unbegrenzte Skalierbarkeit zur Überwachung von Tausenden von Geräten über mehrere Standorte hinweg.
- Multi-Tenancy-Support: Bietet flexible Benutzerprofile und Berechtigungen, was sie für Dienstleister geeignet macht, die Monitoring-Dienste für mehrere Mandanten in einer isolierten Umgebung anbieten müssen.
Nachteile
- Steile Lernkurve: Die Komplexität und der umfangreiche Funktionsumfang von Zabbix können für Neueinsteiger eine Herausforderung darstellen und erfordern erheblichen Zeitaufwand zum Erlernen.
- Eingeschränkte Anleitung: Einige Nutzer haben Schwierigkeiten mit fehlender umfassender Dokumentation und Community-Support berichtet, was die effektive Nutzung und Fehlerbehebung behindern kann.
- Fehlende Unterstützung für Log-Management.
Preis
Das Zabbix-Cloud-Angebot beginnt bei $50/Monat.
Nagios
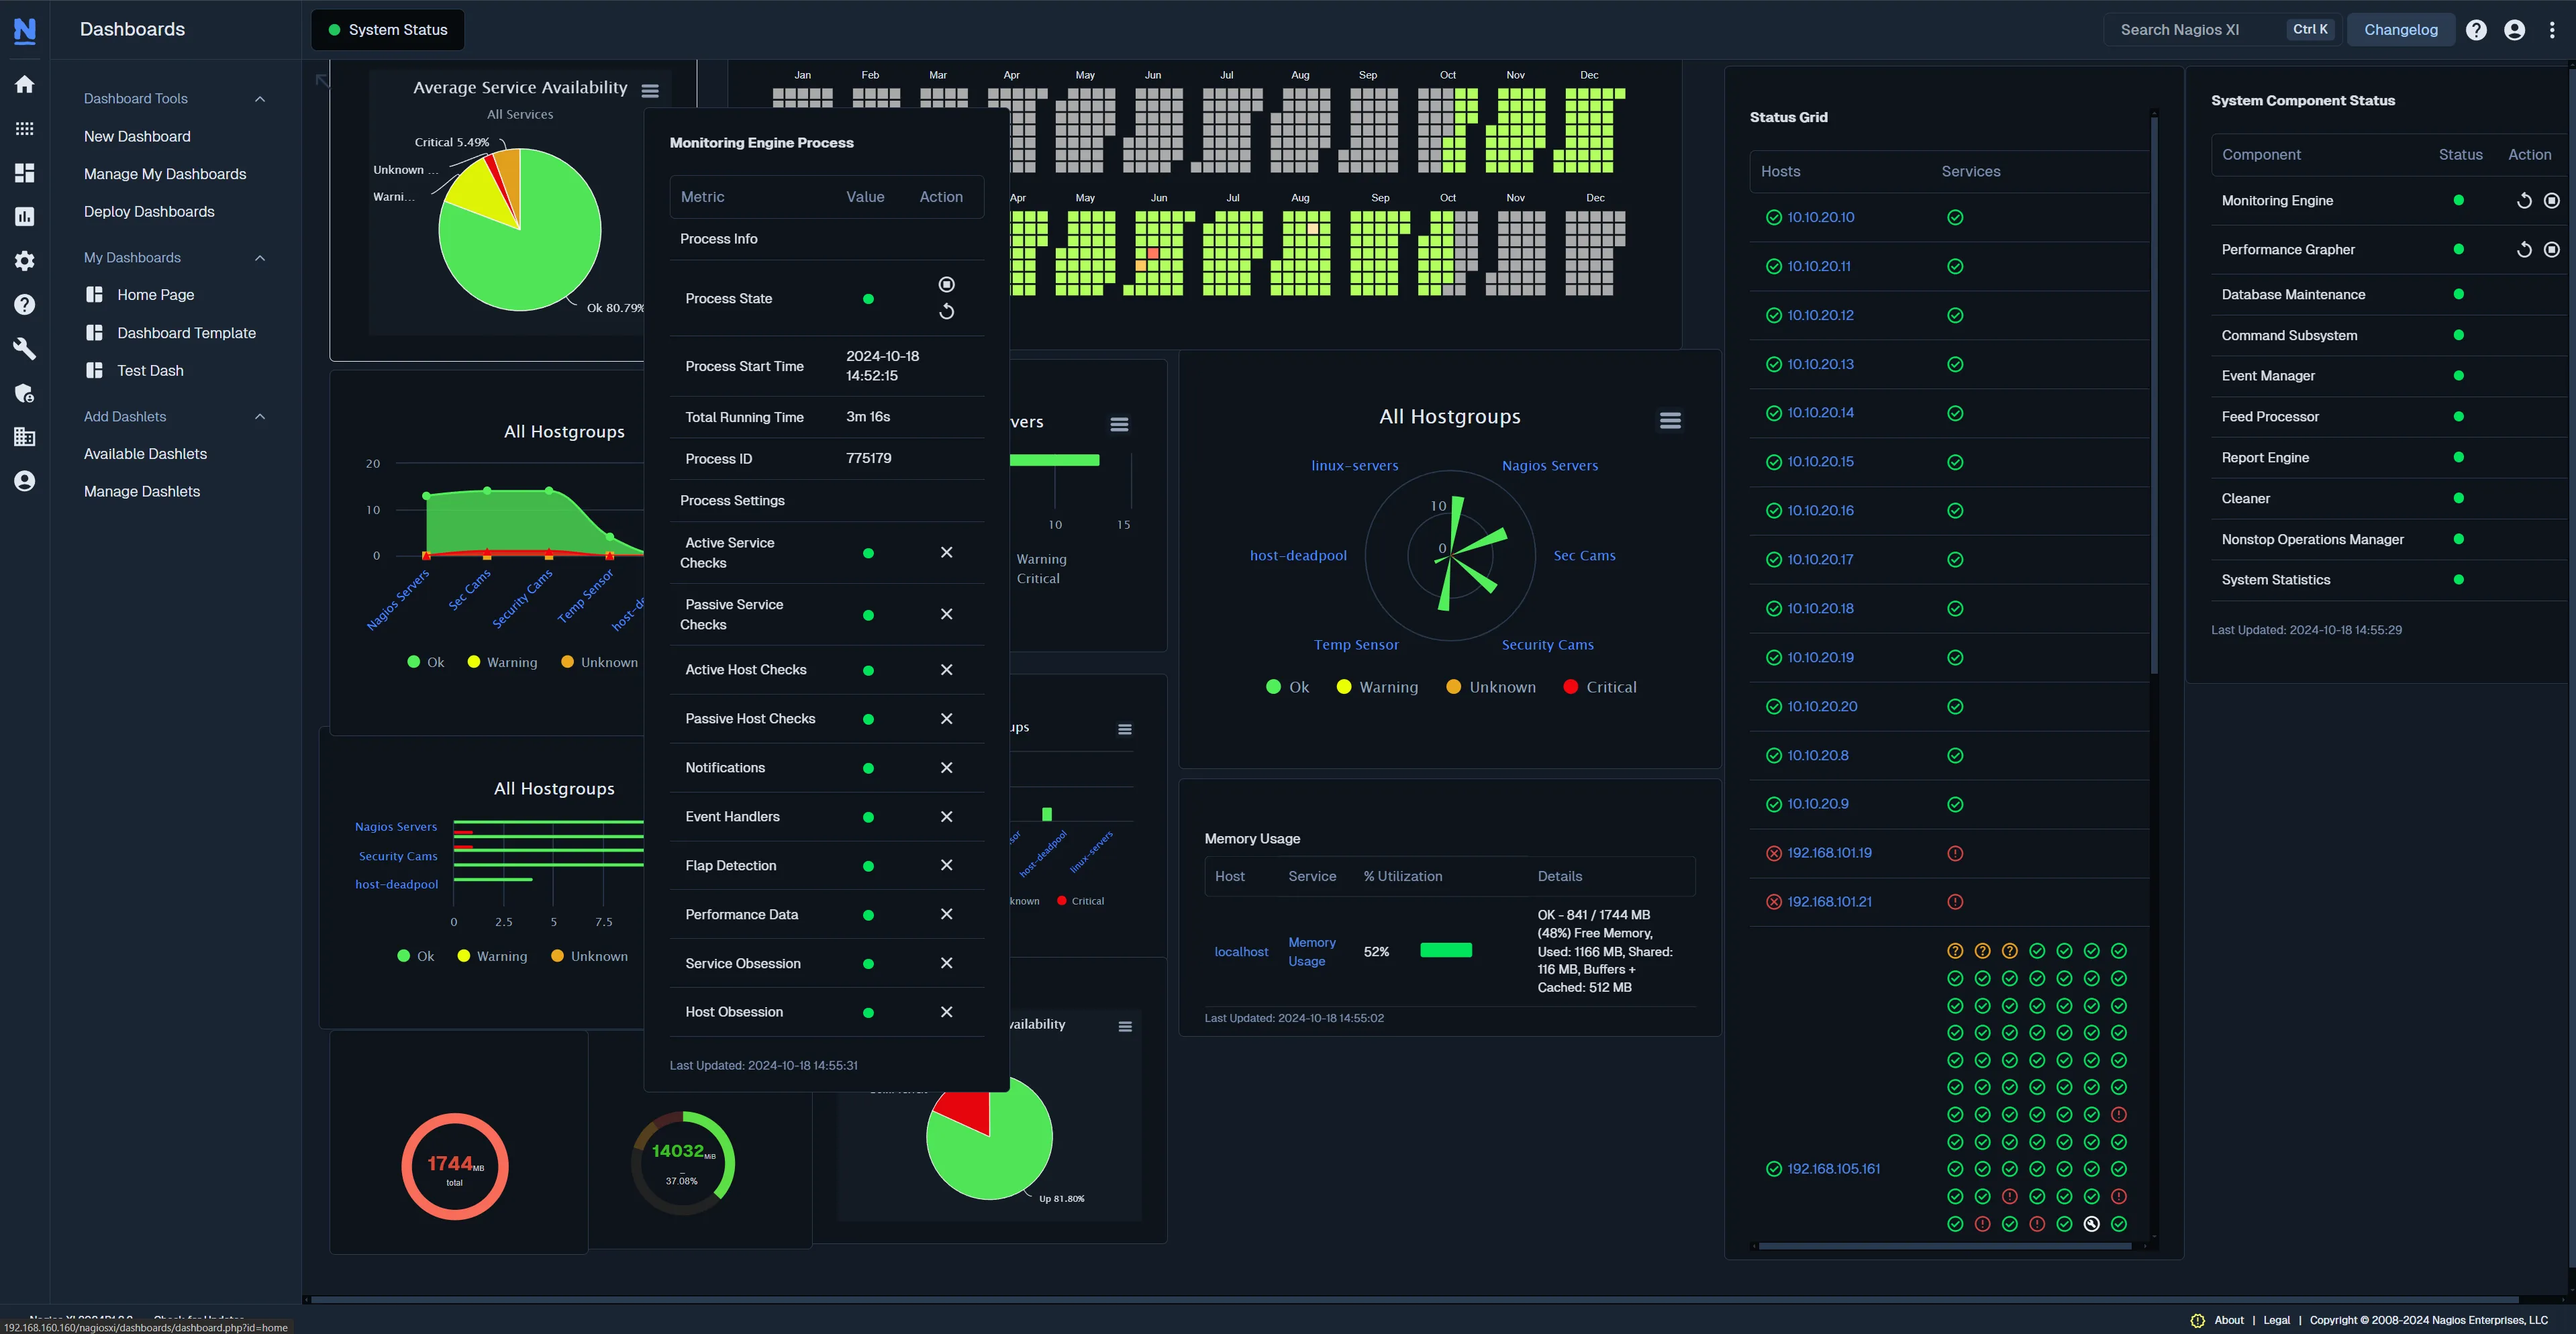
Nagios ist eine umfassende Enterprise-Level-Infrastruktur-Monitoring-Lösung, die extensive Überwachung kritischer IT-Komponenten, Anwendungen und Systeme bietet. Aufbauend auf dem leistungsstarken Nagios Core 4 Monitoring-Engine, wurde sie entwickelt, um hochgradig skalierbar und effektiv für Organisationen aller Größenordnungen zu sein, von kleinen Unternehmen bis zu großen Konzernen.
Die Plattform bietet eine zentralisierte Sicht auf Monitoring-Daten und proaktive Alerts, um Infrastrukturprobleme vorzeitig zu erkennen.
Mit einer anpassbaren GUI, Konfigurations-Assistenten und Multi-Tenant-Fähigkeiten wurde sie entwickelt, um die Verwaltung zu vereinfachen und ein übersichtliches, intuitives Nutzererlebnis zu bieten. Die Funktionalität von Nagios XI kann durch Tausende von Community- und Drittanbieter-Add-ons erweitert werden, zudem gibt es APIs zur Integration in andere Anwendungen.
Wichtigste Funktionen
- Anpassbar und erweiterbar: Bietet eine anpassbare GUI und eine offene Architektur mit Community-Add-ons und APIs zur Integration.
- Konfigurations-Assistenten: Vereinfachen den Einrichtungsprozess für das Monitoring neuer Geräte und Dienste.
Vorteile
- Äußerst flexibel: Das umfangreiche Plugin-Framework und die APIs der Plattform machen sie hochgradig anpassbar an verschiedene Monitoring-Bedürfnisse.
- Skalierbarkeit: Basierend auf Nagios Core 4 wurde sie für effizientes, skalierbares Monitoring großer und verteilter Umgebungen entwickelt.
Nachteile
- Steile Lernkurve: Die Ersteinrichtung und Konfiguration wird oft als komplex empfunden und stellt neue Nutzer vor eine Herausforderung.
- Veraltete Oberfläche: Einige Nutzer empfinden die Web-UI als überladen und weniger modern im Vergleich zu Wettbewerbern.
- Preisgestaltung: Die Kosten können als hoch empfunden werden, insbesondere für die Enterprise-Edition und größere Deployments.
Preis
Die Preise beginnen bei $2.495 für eine 100-Node-Lizenz.
Fazit
Die Wahl der richtigen Server-Monitoring-Lösung hängt vollständig von Ihren spezifischen Bedürfnissen und Ihrem technischen Komfort ab.
Wer Einfachheit, Benutzerfreundlichkeit und schnelle Einrichtung priorisiert, für den sticht Simple Observability heraus.
Die vereinheitlichte Oberfläche, die Installation mit einem Befehl und die transparente Preisgestaltung machen es zu einer idealen Wahl für Teams, die ohne steile Lernkurve oder komplexe Konfigurationsdateien loslegen möchten.
Wenn Ihre Umgebung groß und komplex ist und Geräte über mehrere Standorte verteilt sind, bieten Checkmk und Zabbix die Leistung und Flexibilität, die für die Verwaltung umfangreicher Infrastruktur nötig sind. Ihre steilen Lernkurven sind der Preis für ihre enorme Skalierbarkeit und fortschrittliche Funktionen.
Wer sich auf Echtzeitdaten und einen proaktiven Ansatz zur Problemerkennung konzentriert, findet in Netdata eine einzigartige und leistungsstarke Lösung. Nagios schließlich bleibt eine zuverlässige, hochgradig anpassbare Wahl für große Unternehmen, die ein bewährtes, skalierbares System benötigen.
Letztendlich geht es darum, den Sweet Spot zwischen Funktionalität und Benutzerfreundlichkeit zu finden, der zu Ihren operativen Zielen und den Fähigkeiten Ihres Teams passt.