



- Para quem quer uma solução rápida e fácil de usar que combine métricas e logs sem uma curva de aprendizado íngreme, Simple Observability é a principal escolha.
- Para usuários que precisam de flexibilidade extrema e uma vasta gama de recursos e não se importam com um setup complexo, Checkmk e Zabbix são excelentes.
- Netdata é perfeito para monitoramento em tempo real e detecção de anomalias, enquanto Nagios oferece uma solução altamente escalável e customizável para necessidades de nível enterprise, embora sua interface possa parecer defasada.
Monitoramento de servidores não é um luxo. Isso importa muito independentemente dos serviços que você está rodando.
É uma rede de segurança leve que mantém seu app no ar, seus dados seguros e seu nível de estresse administrável. Para comparações entre ferramentas específicas, confira nossos guias de alternativas ao Netdata, alternativas ao Zabbix e alternativa ao Nagios.
Se você já precisou acessar um servidor via SSH às 2 da manhã para diagnosticar por que um serviço caiu, conhece a pressão. Visibilidade é crítica nesses momentos.
Quais são as melhores ferramentas de monitoramento de servidores disponíveis? Aqui estão as 5 melhores ferramentas de monitoramento do mercado hoje.
O que monitorar?
Antes de mergulhar nas ferramentas, é importante entender o que você deve realmente monitorar. Servidores produzem uma enorme quantidade de dados, mas focar nas métricas certas dá avisos precoces quando algo está dando errado. Aqui está um resumo dos aspectos mais úteis para acompanhar.
Uptime
A métrica mais básica, mas crítica: seu servidor está online? O monitoramento de uptime garante que você saiba imediatamente quando um servidor ou serviço fica inacessível. Até poucos minutos de indisponibilidade podem resultar em receita perdida, confiança do usuário quebrada ou falhas em cascata na sua infraestrutura.
Combinar checagens de uptime com alertas garante que você seja notificado no segundo em que algo cai, não quando seus usuários relatam.
Métricas centrais do sistema
No coração de cada servidor estão os recursos fundamentais:
- Uso de CPU: Consumo alto ou sustentado de CPU pode lentificar processos, indicar tarefas descontroladas ou até apontar para malware.
- Uso de memória: Ficar sem RAM leva a gargalos de performance e, em casos extremos, travamentos do sistema ou swapping que arrasta tudo junto.
- Uso de disco e I/O: Um disco cheio ou um pipeline de I/O sobrecarregado pode silenciosamente prejudicar seu sistema. Monitorar tanto espaço quanto throughput ajuda a prevenir indisponibilidade.
Pense nisso como a base da saúde do seu servidor. Se eles estiverem comprometidos, todo o resto por cima vai sofrer.
Métricas de rede
A atividade de rede do seu servidor é outra peça crítica do quebra-cabeça. Um pico repentino de bandwidth (de entrada ou saída) pode significar muitas coisas:
- Um ataque de Negação de Serviço Distribuída (DDoS).
- Uma aplicação mal configurada vazando tráfego.
- Dados sendo exfiltrados sem seu conhecimento.
Ao acompanhar de perto o volume de tráfego, contagens de conexões e latência, você ganha visibilidade tanto de problemas de performance quanto de potenciais incidentes de segurança.
Métricas de web server
Se seu servidor hospeda aplicações ou sites, os indicadores de tráfego web são indispensáveis:
- Requisições por Segundo (RPS): Isso mostra quanta carga seu servidor está lidando a qualquer momento. Saltos repentinos podem indicar popularidade ou abuso.
- Taxa de erro (respostas 4xx/5xx): Uma taxa de erro crescente frequentemente aponta para código quebrado, recursos sobrecarregados ou fatores externos como uma dependência falhando.
Juntas, essas métricas dão uma imagem clara do que está acontecendo nos bastidores. Elas ajudam você a sair do combate a incêndios reativo (“o site caiu!”) para o monitoramento proativo (“vemos erros subindo, vamos consertar antes que os usuários reclamem”).
Resumo das melhores ferramentas de monitoramento de servidores
| Prós | Contras | |
|---|---|---|
| Simple Observability | Simplicidade e facilidade de uso, instalação com um comando, métricas e logs unificados, preço transparente, agente open-source | Customização limitada para usuários avançados. |
| Checkmk | Abrangente com mais de 2.000 plugins, flexível para monitoramento com ou sem agente, descoberta automática de serviços. | Curva de aprendizado íngreme, configuração complexa. |
| Netdata | Coleta de dados em tempo real e alta resolução, detecção de anomalias baseada em machine learning, tempo até valor instantâneo. | Recursos-chave como APM e gestão de logs ainda pendentes, e alguns usuários relatam falta de documentação detalhada. |
| Zabbix | Altamente escalável para grandes ambientes, suporte a multi-tenancy, detecção avançada de problemas. | Curva de aprendizado íngreme, falta de documentação abrangente, alguns usuários relatam dificuldades com gestão de logs. |
| Nagios | Extremamente flexível e customizável com uma vasta estrutura de plugins, escalável para ambientes grandes e distribuídos, assistentes de configuração. | Curva de aprendizado íngreme, interface defasada, alto custo para a versão enterprise. |
Análises
Simple Observability
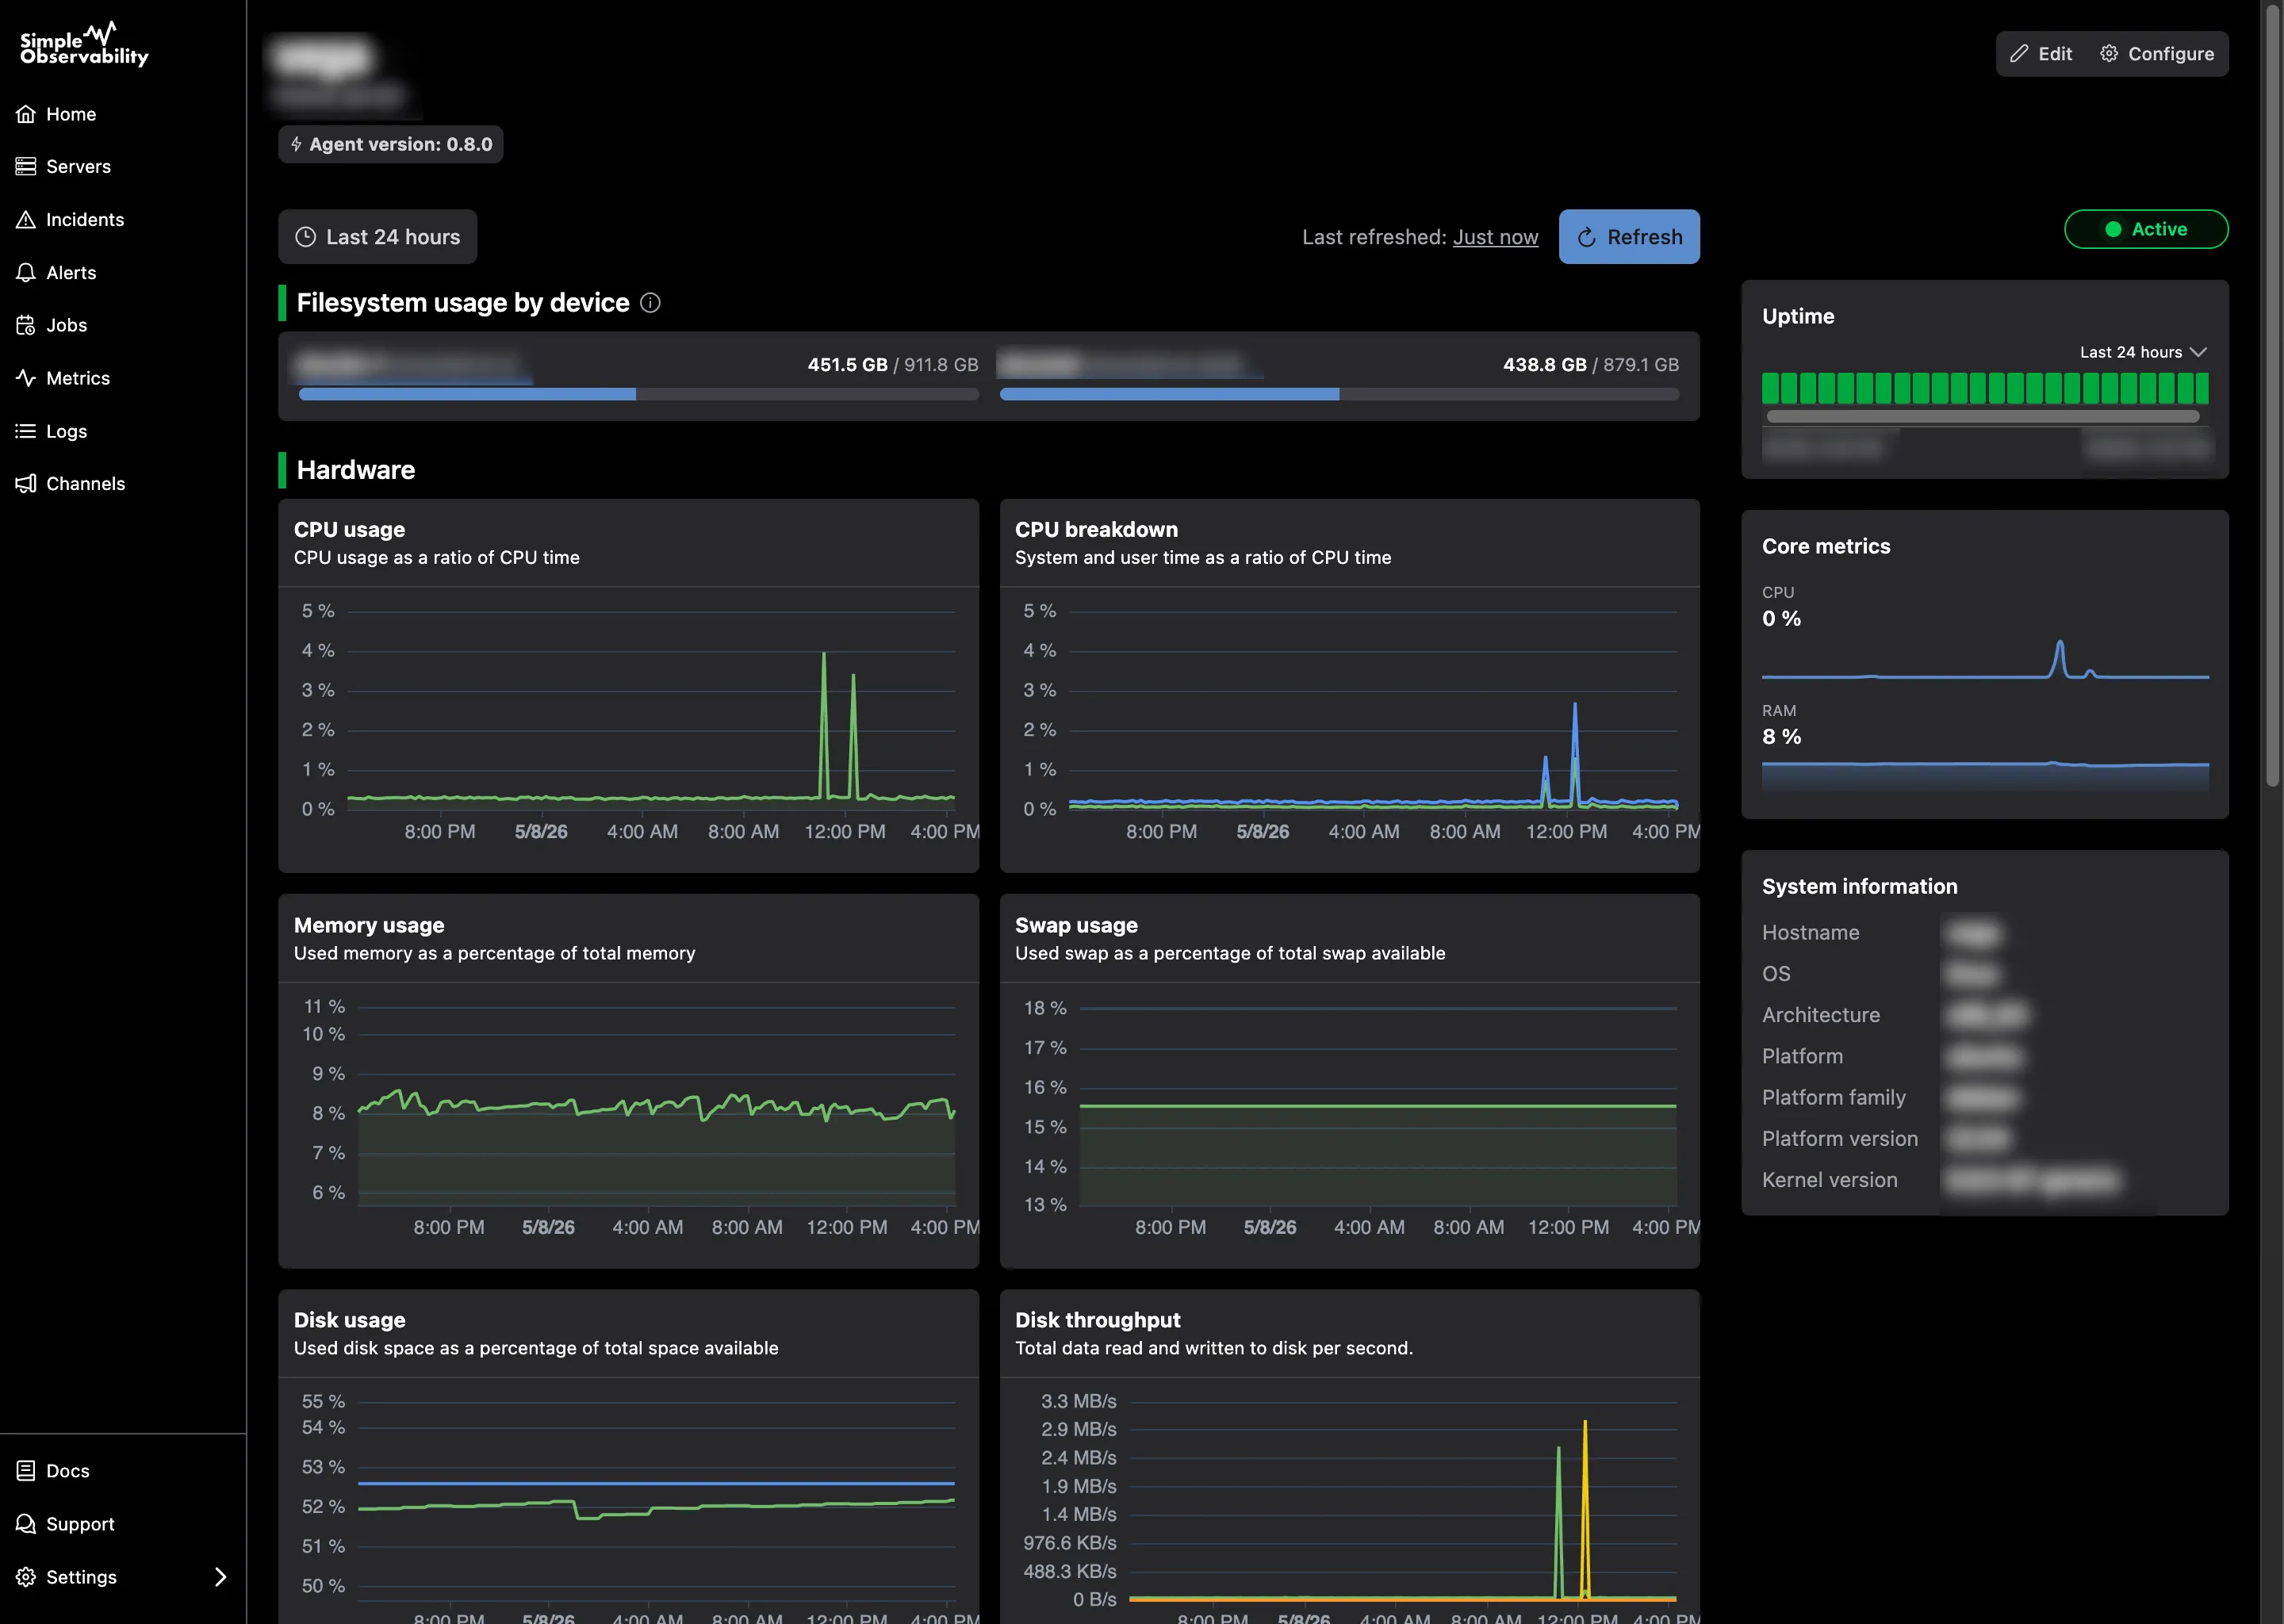
A Simple Observability é uma plataforma de monitoramento de servidores feita para ser uma solução direta e eficaz para empresas e indivíduos. Ela se diferencia ao oferecer uma experiência “all-in-one”, combinando métricas e logs em uma interface unificada para dar aos usuários uma visão completa da saúde de seus servidores sem a complexidade frequentemente associada a outras ferramentas de monitoramento.
A filosofia central da plataforma é simplicidade, desde a instalação do agente com um único comando até sua configuração via web que elimina a edição manual de arquivos.
Ela oferece relatórios e alertas prontos para uso, permitindo que os usuários obtenham insights imediatos e definam condições de alerta em segundos.
Seu agente open-source é transparente, auditável e feito para funcionar em uma ampla gama de distribuições Linux.
Principais recursos
- Instalação com um comando: O agente open-source pode ser instalado com um único comando, reduzindo significativamente o tempo e a complexidade de setup.
- Monitoramento unificado: Combina métricas e logs num único sistema unificado, fornecendo uma visão holística da performance do servidor.
- Configuração via web UI: Todas as configurações, de métricas a alertas, são gerenciadas por uma interface web intuitiva, eliminando a necessidade de arquivos de configuração complexos.
- Mobile-friendly: Oferece um Progressive Web App (PWA) para monitorar a infraestrutura e receber alertas de qualquer lugar.
Prós
- Simplicidade e facilidade de uso: A plataforma é feita para adoção rápida, mesmo por usuários com conhecimento limitado de monitoramento.
- Preço transparente: A Simple Observability oferece um modelo de preço fixo e claro, sem surpresas baseadas em uso, o que pode ser uma vantagem significativa sobre concorrentes.
- Agente open-source: A natureza open-source do agente fornece transparência e permite que os usuários audititem o código.
Contras
- Customização limitada: Embora a simplicidade seja um pró, também pode ser um contras para usuários avançados que exigem controle mais granular e customização além dos recursos embutidos.
Preço
A Simple Observability oferece um plano gratuito e preço simples por servidor:
- Grátis: um servidor, 50 métricas, baixo volume de logs.
- Pago: $3 por mês por servidor, 100 métricas por servidor, alto volume de logs, servidores ilimitados.
- Personalizado: descontos por volume e retenção personalizada para grandes infraestruturas.
Checkmk
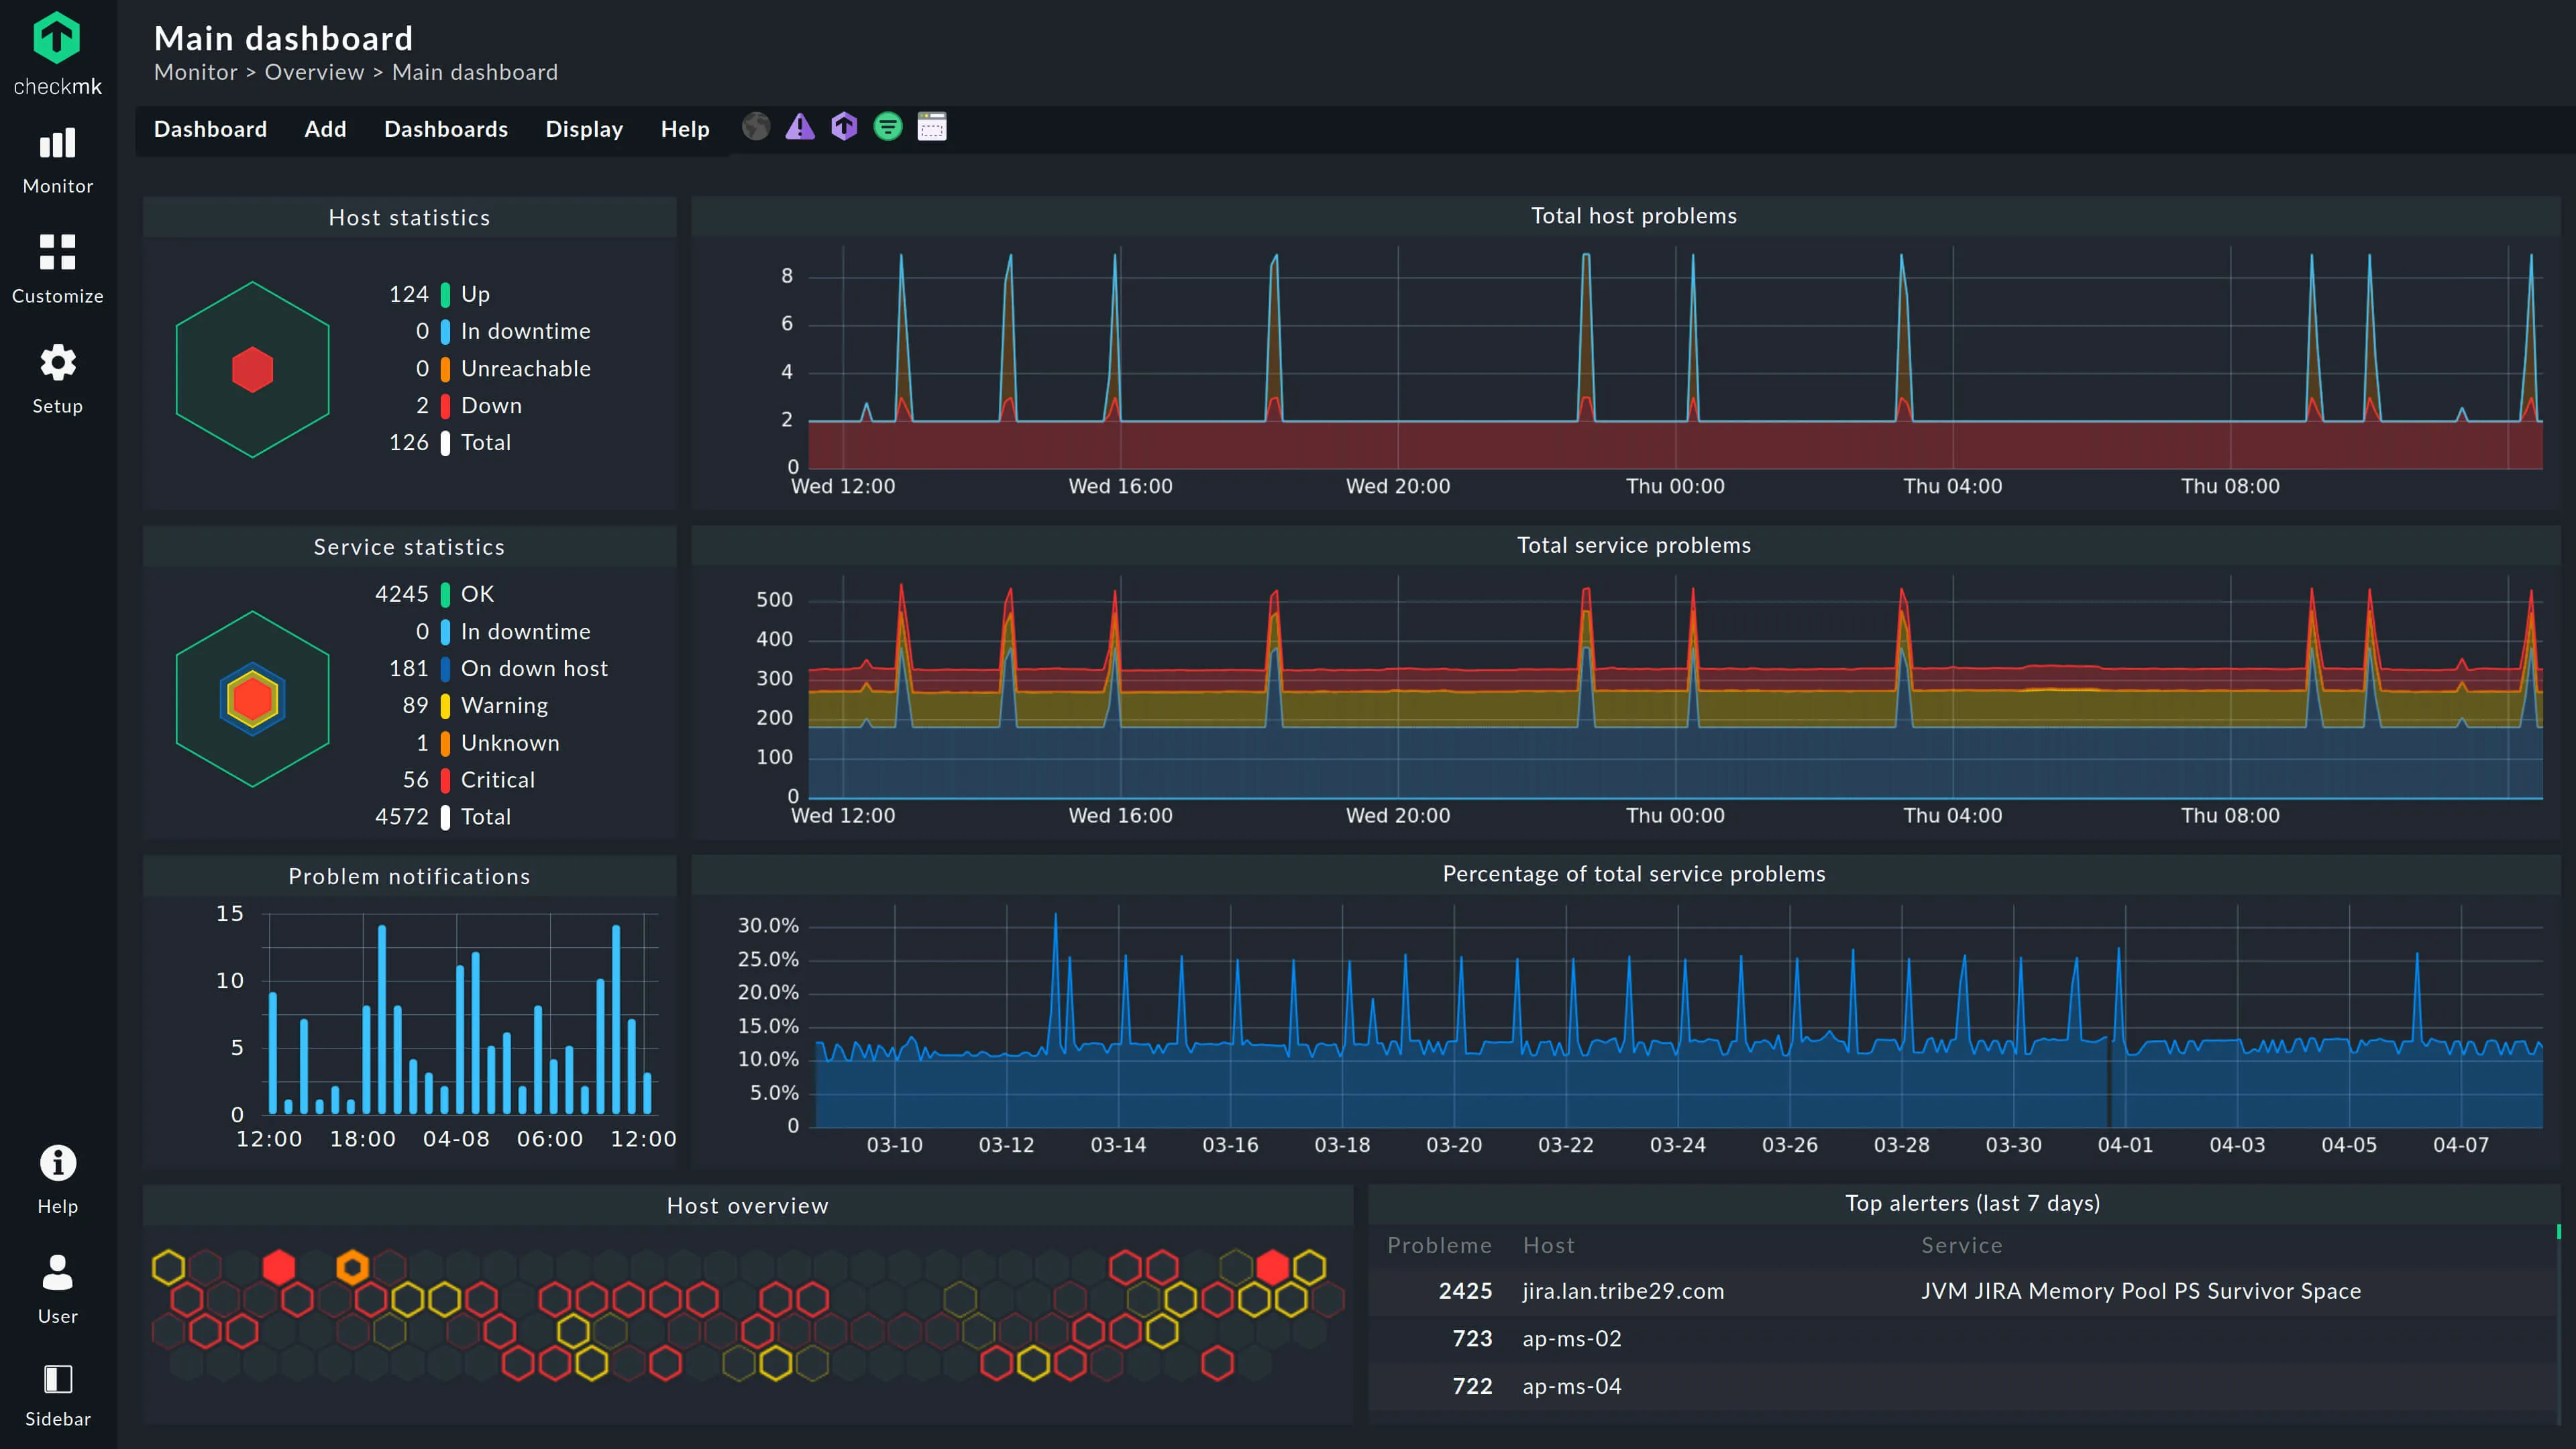
O Checkmk é uma plataforma de monitoramento open-source abrangente para aplicações, servidores e redes, tanto on-premises quanto na nuvem. É feita para monitorar sem esforço tudo, dos ambientes de TI mais simples aos mais complexos.
O Checkmk tem mais de 2.000 plugins de monitoramento para uma ampla gama de dispositivos, incluindo servidores, switches, bancos de dados e web servers.
A edição comunitária gratuita é self-hosted com um conjunto de recursos limitado e suporta tanto monitoramento baseado em agente quanto sem agente.
O Checkmk também consegue descobrir e mapear sua rede automaticamente.
Principais recursos
- Descoberta automática de serviços: Detecta automaticamente todos os componentes relevantes em um host e recomenda métricas e thresholds adequados para monitoramento.
- Visualização: Conta com dashboards modernos e customizáveis, mapas gráficos.
Prós
- Abrangente: Monitora uma ampla gama de componentes de TI, de serviços cloud a sistemas on-premises, com uma vasta biblioteca de mais de 2.000 plugins.
- Flexível: Suporta monitoramento com e sem agente, sendo altamente customizável e extensível.
- Automatizado: Reduz o esforço manual com recursos como auto-discovery, gerenciamento do ciclo de vida de hosts e uma REST API poderosa.
Contras
-
Curva de aprendizado e configuração difícil: Embora poderosa, a plataforma pode ter uma curva de aprendizado íngreme.
Alguns usuários consideram sua configuração complexa, particularmente para recursos avançados.
Preço
O Checkmk oferece um modelo self-hosted com licenças pagas a partir de aproximadamente $225 por mês, tipicamente para um mínimo de 100 hosts.
Há também um modelo SaaS disponível, com preço em torno de $6 por host por mês. O preço é baseado no número de serviços monitorados, onde um host tem em média cerca de 30 serviços.
Cada grupo de 10 serviços é cobrado a aproximadamente $2 por mês, o que pode fazer o custo escalar rapidamente.
Netdata
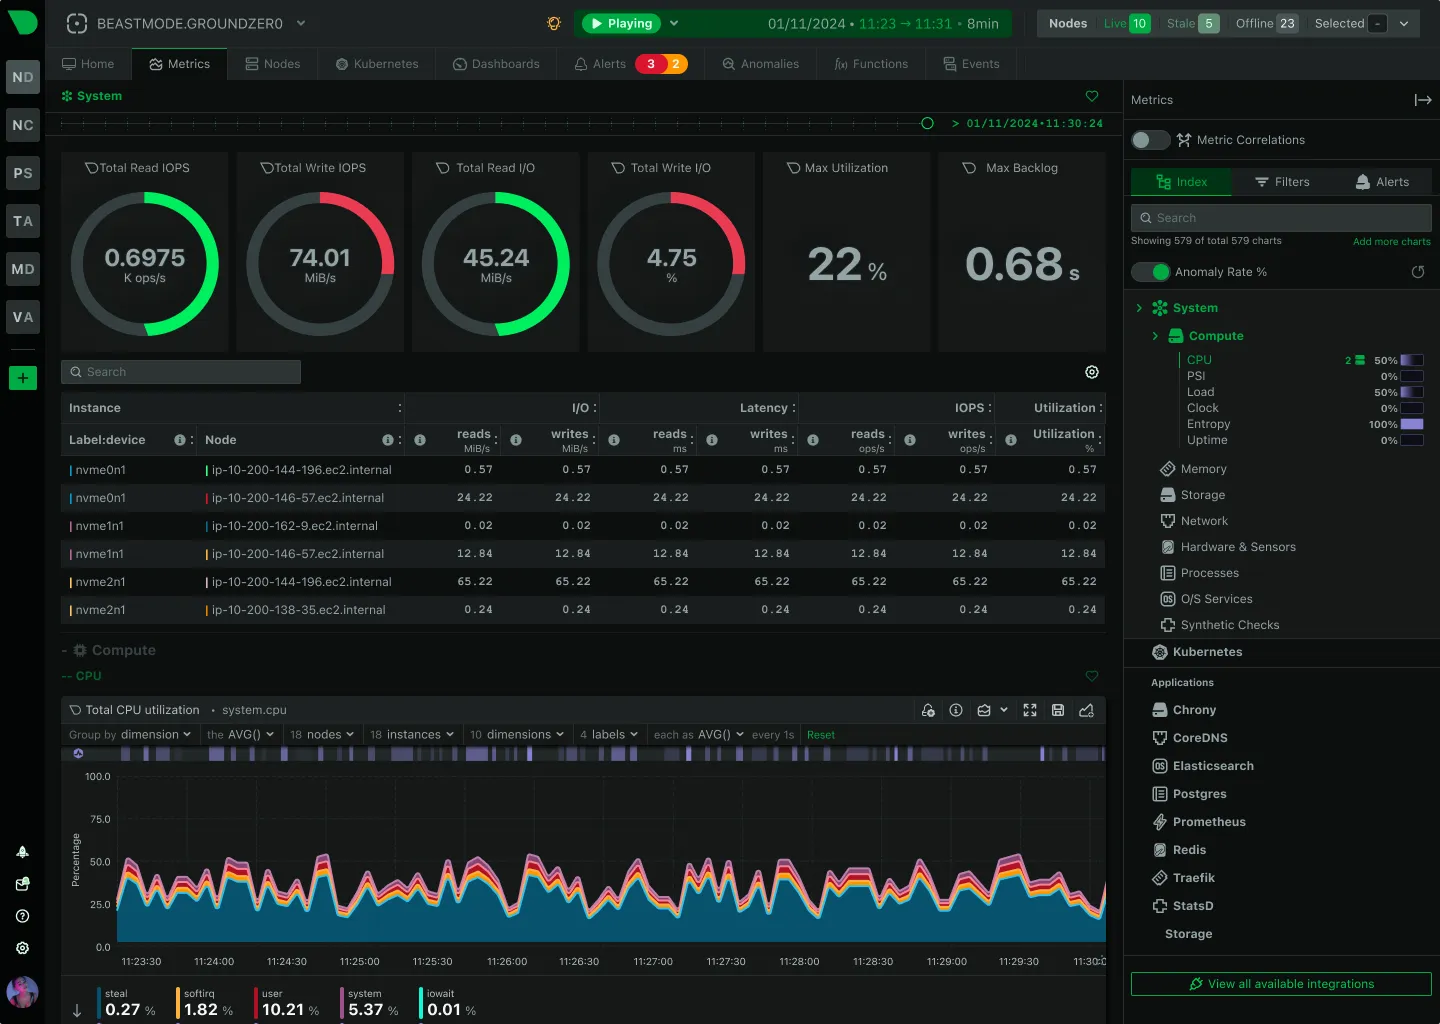
O Netdata é uma plataforma de monitoramento e troubleshooting de performance em tempo real, open-source, para sistemas e aplicações. É feita para fornecer coleta de dados de alta resolução, por segundo, tornando-a ideal para detecção imediata e proativa de problemas. Com sua arquitetura descentralizada, o Netdata consegue monitorar infraestruturas inteiras, de um único servidor a ambientes distribuídos em grande escala.
O Netdata oferece uma solução de observabilidade integrada all-in-one, cobrindo métricas, logs, checks sintéticos e alertas.
Conta com detecção de anomalias baseada em machine learning e fornece insights claros e acionáveis sem exigir conhecimento profundo de ciência de dados.
A descoberta automática da plataforma e os alertas pré-configurados reduzem o setup manual, permitindo um tempo até valor rápido para as equipes.
Principais recursos
- Coleta de dados em tempo real e alta resolução: Coleta métricas a cada segundo, fornecendo feedback instantâneo com baixa latência.
- Detecção de anomalias baseada em machine learning: Utiliza machine learning não supervisionado para aprender padrões de carga de trabalho e identificar anomalias automaticamente.
Prós
- Tempo até valor instantâneo: A descoberta automática de fontes de dados e alertas pré-configurados permitem uso imediato após a instalação.
- Privacidade de dados: Os dados são armazenados on-premise, garantindo que permaneçam na infraestrutura do usuário.
Contras
- Recursos ausentes: Recursos-chave como Application Performance Monitoring (APM) e gestão de logs ainda estão pendentes ou não totalmente implementados, o que pode limitar o monitoramento abrangente.
- Limitações de dados e relatórios: Usuários relataram dificuldades com informações insuficientes, particularmente em relação a relatórios detalhados e documentação para integrações.
Preço
O Netdata oferece um modelo de assinatura a $6 por mês e por nó.
Zabbix
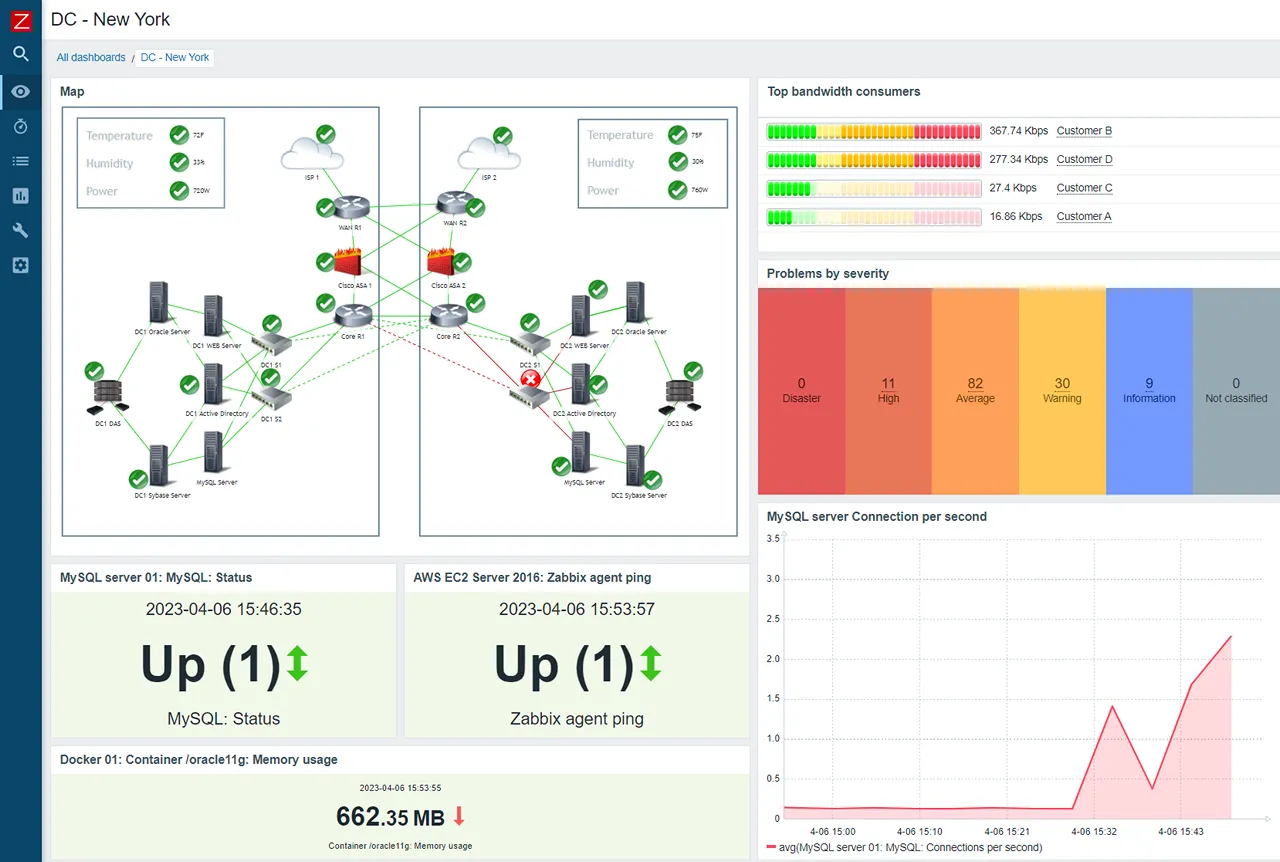
O Zabbix é um software de nível enterprise, open-source, para monitorar vários componentes de TI, incluindo redes, servidores, máquinas virtuais e serviços cloud. Feito para lidar com ambientes em grande escala.
Uma das principais forças do Zabbix é sua capacidade de coletar dados de praticamente qualquer fonte usando uma ampla gama de protocolos e métodos customizados. O robusto sistema de alerta da plataforma oferece múltiplos canais e esquemas de escalonamento, garantindo que problemas críticos sejam tratados prontamente.
Principais recursos
- Detecção avançada de problemas: Utiliza thresholds inteligentes, previsão de tendências e machine learning para detectar anomalias automaticamente e classificar problemas com múltiplos níveis de severidade.
- Alertas flexíveis: Suporta uma variedade de canais de notificação, como e-mail, SMS e mensagens instantâneas, com mensagens customizáveis e cenários de escalonamento.
Prós
- Alta escalabilidade: A arquitetura de monitoramento distribuído, apoiada por proxies do Zabbix, permite escalabilidade ilimitada para monitorar milhares de dispositivos em múltiplas localidades.
- Suporte a multi-tenancy: Fornece perfis de usuário e permissões flexíveis, tornando-o adequado para provedores de serviços que precisam oferecer monitoramento a múltiplos clientes em um ambiente isolado.
Contras
- Curva de aprendizado íngreme: A complexidade e os recursos extensos do Zabbix podem ser desafiadores para iniciantes, exigindo um investimento significativo de tempo para dominar.
- Orientação limitada: Alguns usuários relataram dificuldades com a falta de documentação abrangente e suporte da comunidade, o que pode dificultar o uso eficaz e o troubleshooting.
- Falta suporte para gestão de logs.
Preço
A oferta do Zabbix Cloud começa em $50/mês.
Nagios
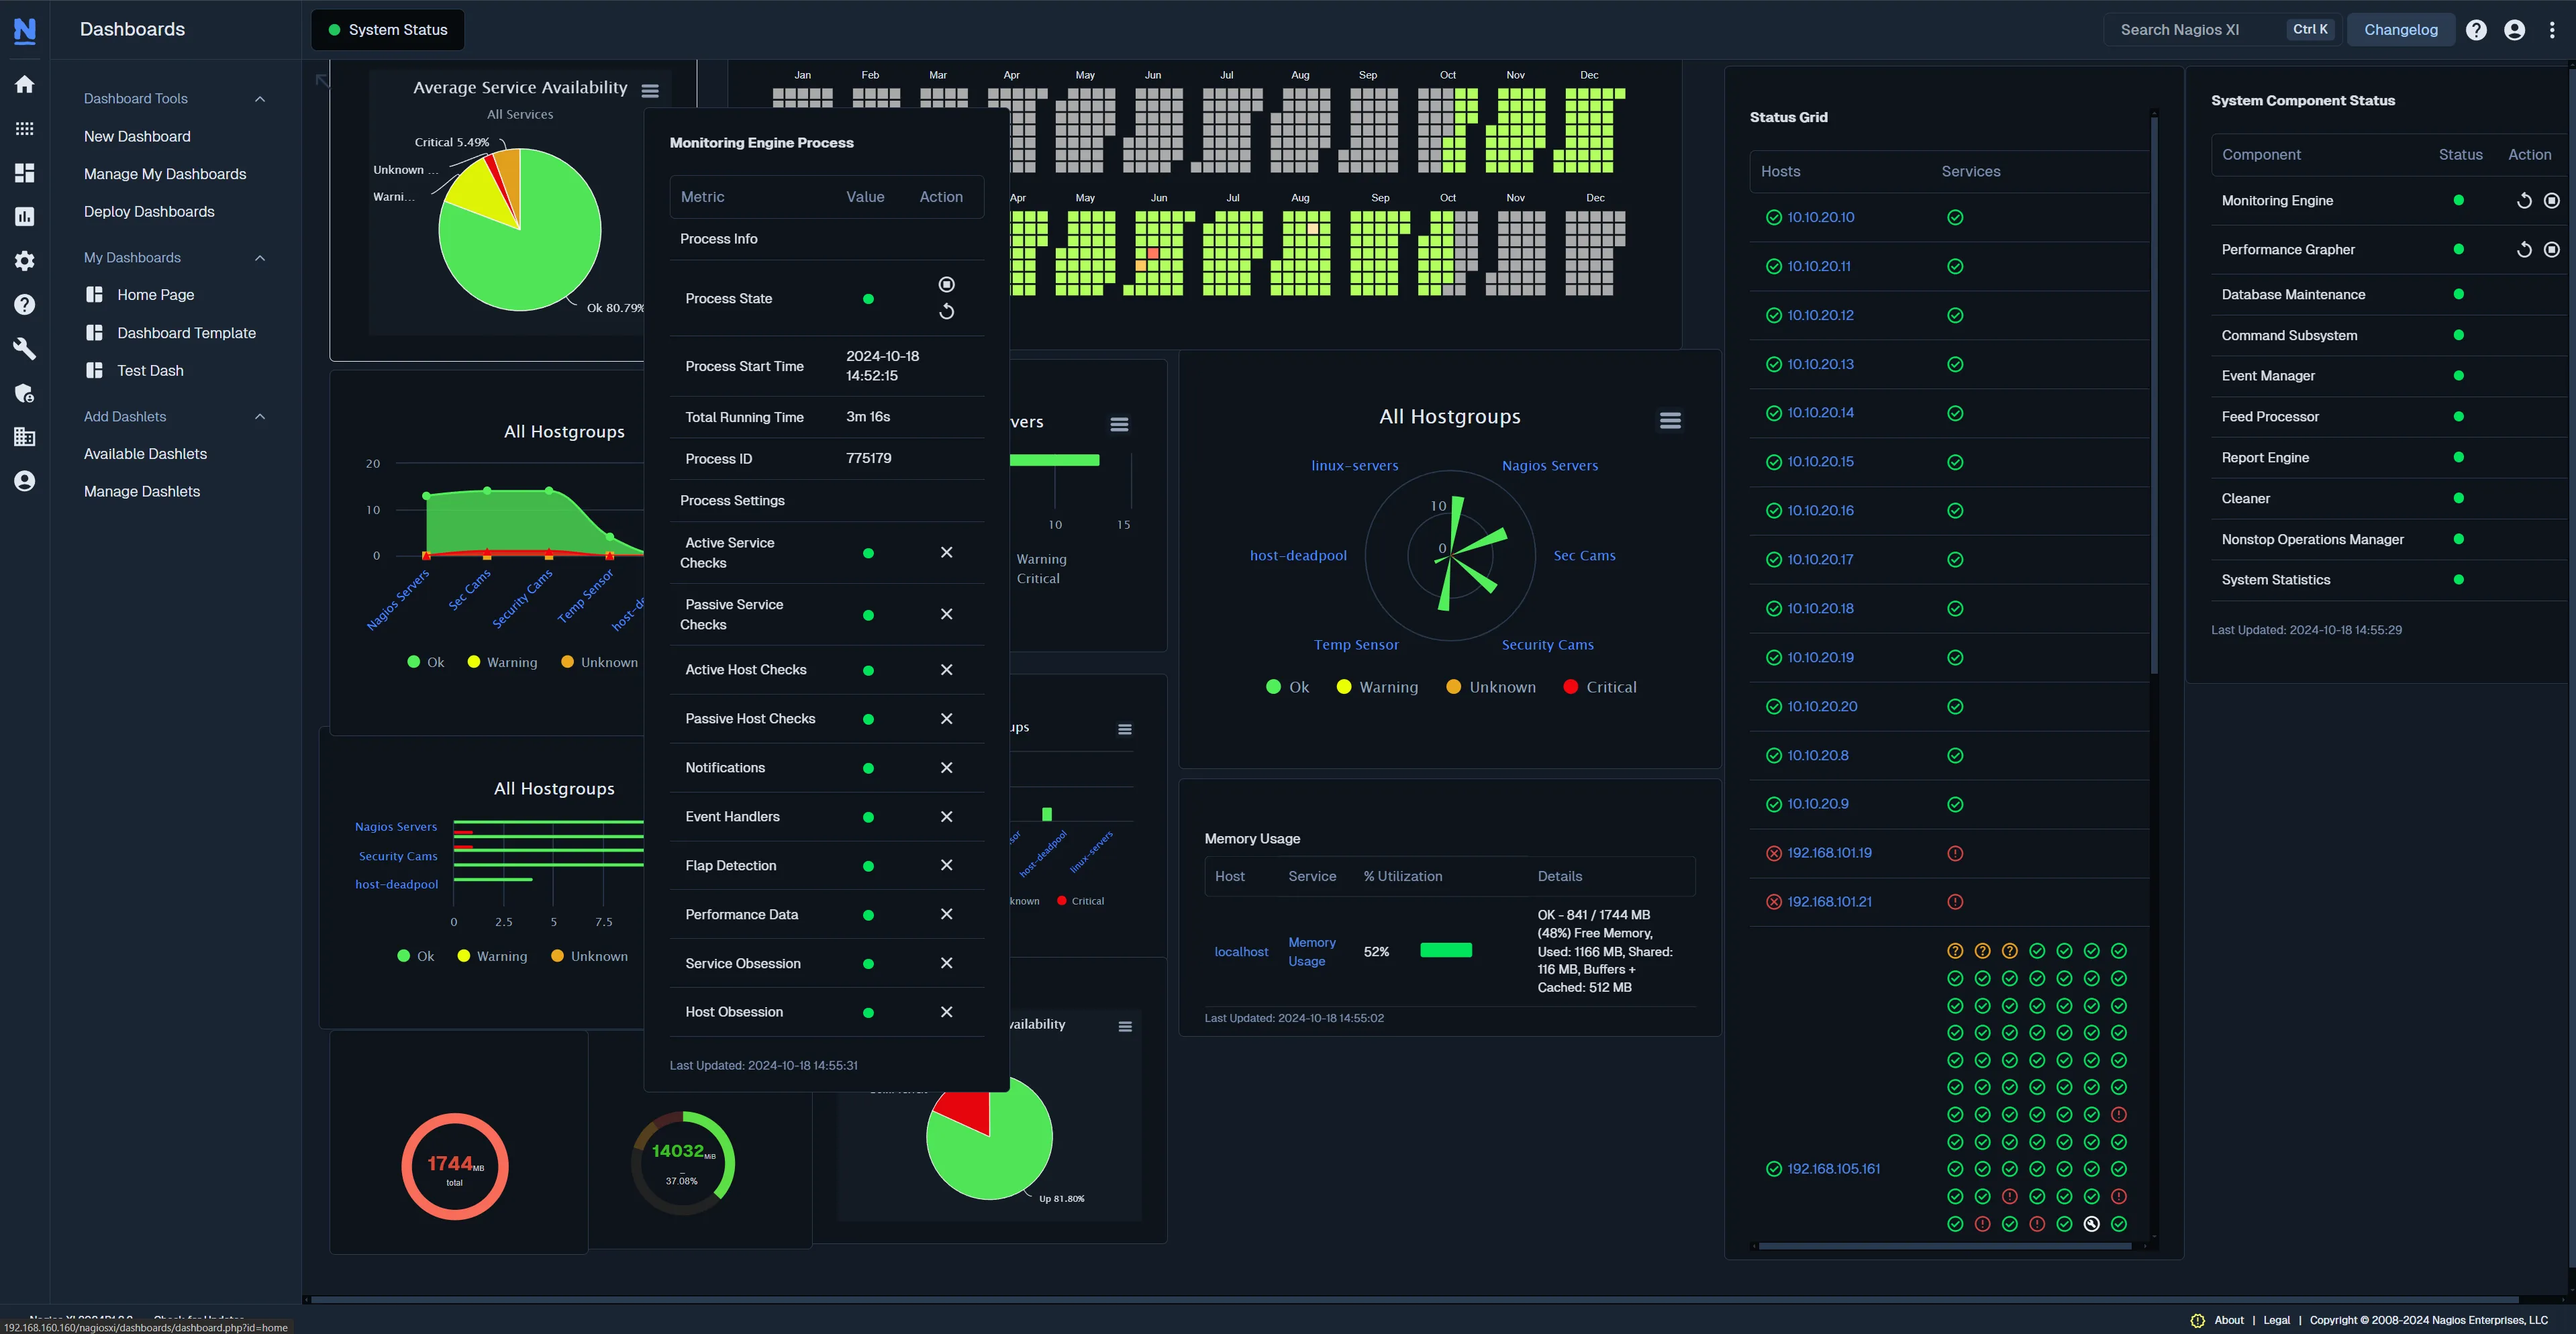
O Nagios é uma solução abrangente de monitoramento de infraestrutura de nível enterprise que fornece monitoramento extenso de componentes críticos de TI, aplicações e sistemas. Construído sobre o poderoso motor de monitoramento Nagios Core 4, é feito para ser altamente escalável e eficaz para organizações de todos os tamanhos, de pequenas empresas a grandes corporações.
A plataforma oferece uma visão centralizada dos dados de monitoramento e alertas proativos para tratar preventivamente problemas de infraestrutura. Com uma GUI customizável, assistentes de configuração e capacidades multi-tenant, é feita para simplificar a administração e fornecer uma experiência de usuário ágil e intuitiva. A funcionalidade do Nagios XI pode ser estendida com milhares de add-ons da comunidade e de terceiros, junto com APIs para integração com outras aplicações.
Principais recursos
- Customizável e extensível: Oferece uma GUI customizável e uma arquitetura aberta com add-ons da comunidade e APIs para integração.
- Assistentes de configuração: Simplifica o processo de setup para monitorar novos dispositivos e serviços.
Prós
- Extremamente flexível: A extensa estrutura de plugins e APIs da plataforma a torna altamente adaptável a várias necessidades de monitoramento.
- Escalabilidade: Construído sobre o Nagios Core 4, é feito para monitoramento eficiente e escalável de ambientes grandes e distribuídos.
Contras
- Curva de aprendizado íngreme: O setup e a configuração iniciais são frequentemente considerados complexos, tornando-o desafiador para novos usuários.
- Interface defasada: Alguns usuários consideram a web UI congestionada e menos moderna comparada a concorrentes.
- Preço: O custo pode ser considerado alto, particularmente para a edição enterprise e implantações maiores.
Preço
O preço começa em $2.495 para uma licença de 100 nós.
Conclusão
Escolher a solução certa de monitoramento de servidores depende inteiramente das suas necessidades específicas e nível de conforto técnico.
Para quem prioriza simplicidade, facilidade de uso e setup rápido, a Simple Observability se destaca.
Sua interface unificada, instalação com um comando e preço transparente a tornam uma escolha ideal para equipes que buscam começar a usar sem uma curva de aprendizado íngreme ou arquivos de configuração complexos.
Se seu ambiente é grande e complexo, dispositivos e servidores podem estar espalhados por múltiplas localidades. Checkmk e Zabbix oferecem o poder e a flexibilidade necessários para gerenciar infraestrutura extensa. Suas curvas de aprendizado íngremes são o trade-off por sua escalabilidade massiva e recursos avançados.
Para quem foca em dados em tempo real e uma abordagem proativa à detecção de problemas, o Netdata oferece uma solução única e poderosa. Por fim, o Nagios permanece uma escolha confiável e altamente customizável para grandes empresas que precisam de um sistema comprovado e escalável.
No fim das contas, escolher a ferramenta certa é encontrar o ponto ideal entre funcionalidade e usabilidade que se alinhe com seus objetivos operacionais e as habilidades da equipe.