



- Pour ceux qui veulent une solution rapide et facile à utiliser, combinant métriques et journaux sans courbe d'apprentissage abrupte, Simple Observability est le premier choix.
- Pour les utilisateurs qui ont besoin d'une flexibilité extrême et d'un vaste éventail de fonctionnalités, sans craindre une configuration complexe, Checkmk et Zabbix sont excellents.
- Netdata est parfait pour la supervision en temps réel et la détection d'anomalies, tandis que Nagios offre une solution hautement scalable et personnalisable pour les besoins de niveau entreprise, bien que son interface puisse sembler datée.
La supervision des serveurs n’est pas un luxe. Elle compte énormément, quels que soient les services que vous exploitez réellement.
C’est un filet de sécurité léger qui maintient votre application en ligne, vos données en sécurité et votre niveau de stress gérable. Pour des comparaisons outil par outil, consultez nos guides sur les alternatives à Netdata, les alternatives à Zabbix et l’alternative à Nagios.
Si vous avez déjà dû vous connecter en SSH à un serveur à 2 h du matin pour diagnostiquer la panne d’un service, vous connaissez la pression. La visibilité est cruciale dans ces moments-là.
Quels sont les meilleurs outils de supervision de serveurs disponibles ? Voici les 5 meilleurs outils du marché aujourd’hui.
Que superviser ?
Avant de plonger dans les outils, il est important de comprendre ce que vous devez réellement superviser. Les serveurs produisent une quantité considérable de données, mais se concentrer sur les bonnes métriques vous donnera une alerte précoce quand quelque chose commence à mal tourner. Voici un aperçu des aspects les plus utiles à surveiller.
Disponibilité
La métrique la plus basique mais la plus critique : votre serveur est-il en ligne ? La supervision de disponibilité garantit que vous savez immédiatement quand un serveur ou un service devient injoignable. Quelques minutes d’indisponibilité peuvent suffire à entraîner une perte de chiffre d’affaires, une confiance utilisateur érodée ou des pannes en cascade dans votre infrastructure.
Associer les vérifications de disponibilité à un système d’alerte vous garantit d’être notifié à la seconde où quelque chose tombe, et non quand vos utilisateurs le signalent.
Métriques cœur du système
Au cœur de chaque serveur se trouvent les ressources fondamentales :
- Utilisation du CPU : une consommation élevée ou soutenue peut ralentir les processus, indiquer des tâches incontrôlées, voire signaler la présence d’un logiciel malveillant.
- Utilisation de la mémoire : épuiser la RAM provoque des goulots d’étranglement et, dans les cas extrêmes, des plantages système ou du swapping qui entraîne tout vers le bas.
- Utilisation disque et E/S : un disque plein ou un pipeline d’E/S saturé peut paralyser silencieusement votre système. Superviser à la fois l’espace et le débit vous aide à prévenir les arrêts de service.
Considérez ces éléments comme les fondations de la santé de votre serveur. S’ils sont compromis, tout ce qui s’appuie dessus en souffrira.
Métriques réseau
L’activité réseau de votre serveur est une autre pièce critique du puzzle. Un pic soudain de bande passante (entrant ou sortant) peut signifier beaucoup de choses :
- Une attaque par déni de service distribué (DDoS).
- Une application mal configurée qui fait fuiter du trafic.
- Des données exfiltrées à votre insu.
En surveillant de près le volume de trafic, le nombre de connexions et la latence, vous gagnez en visibilité sur les problèmes de performance comme sur les incidents de sécurité potentiels.
Métriques du serveur web
Si votre serveur héberge des applications ou des sites web, les indicateurs de trafic web sont indispensables :
- Requêtes par seconde (RPS) : cela montre la charge que votre serveur gère à un instant T. Des sauts soudains peuvent indiquer une popularité ou un abus.
- Taux d’erreur (réponses 4xx/5xx) : une hausse du taux d’erreur pointe souvent vers du code défectueux, des ressources surchargées ou des facteurs externes comme une dépendance défaillante.
Ensemble, ces métriques vous offrent une image claire de ce qui se passe en coulisses. Elles vous aident à passer de la gestion réactive (« le site est down ! ») à une supervision proactive (« on voit les erreurs grimper, corrigeons avant que les utilisateurs se plaignent »).
Résumé des meilleurs outils de supervision de serveurs
| Avantages | Inconvénients | |
|---|---|---|
| Simple Observability | Simplicité et facilité d’utilisation, installation en une commande, métriques et journaux unifiés, tarification transparente, agent open source | Personnalisation limitée pour les utilisateurs avancés. |
| Checkmk | Solution complète avec plus de 2 000 plugins, flexible en supervision avec ou sans agent, découverte automatique des services | Courbe d’apprentissage abrupte, configuration complexe. |
| Netdata | Collecte de données en temps réel à haute résolution, détection d’anomalies par machine learning, valeur immédiate à l’installation | Des fonctionnalités clés comme l’APM et la gestion des journaux sont encore en attente, et certains utilisateurs signalent un manque de documentation détaillée. |
| Zabbix | Hautement scalable pour les grands environnements, support du multi-tenant, détection avancée des problèmes | Courbe d’apprentissage abrupte, documentation peu exhaustive, gestion des journaux problématique selon certains utilisateurs. |
| Nagios | Extrêmement flexible et personnalisable grâce à un vaste écosystème de plugins, scalable pour les environnements larges et distribués, assistants de configuration | Courbe d’apprentissage abrupte, interface datée, coût élevé de la version entreprise. |
Avis
Simple Observability
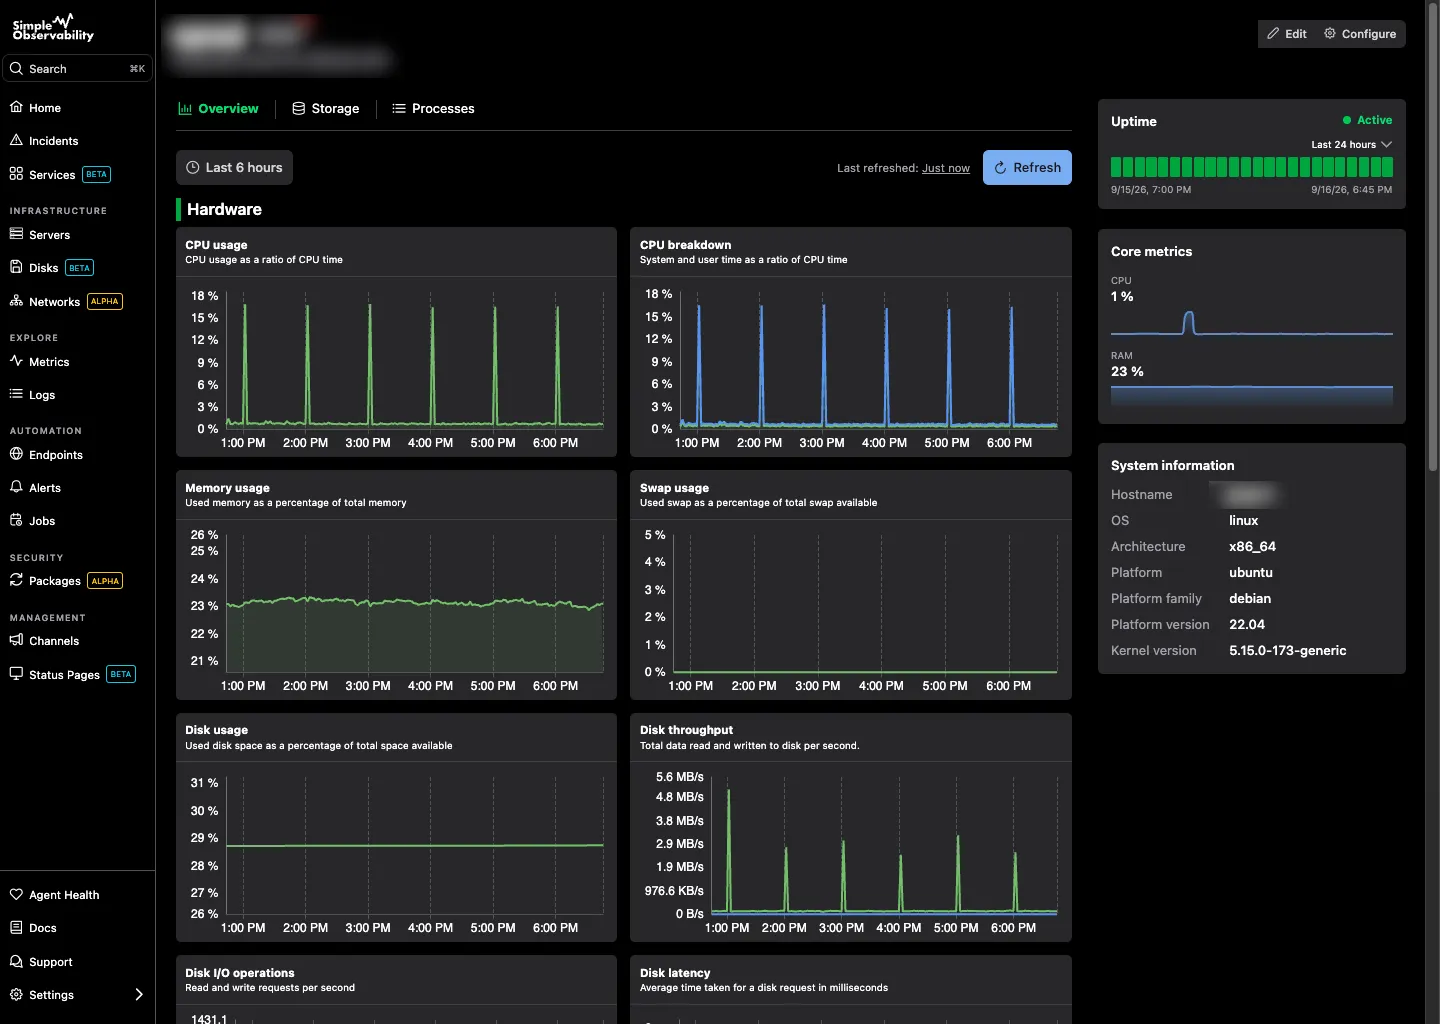
Simple Observability est une plateforme de supervision de serveurs conçue pour être une solution directe et efficace, destinée aux entreprises comme aux particuliers. Elle se distingue par une expérience « tout-en-un », combinant métriques et journaux dans une interface unifiée pour offrir aux utilisateurs une vision complète de la santé de leurs serveurs, sans la complexité souvent associée aux autres outils de supervision.
La philosophie centrale de la plateforme est la simplicité, depuis l’installation de l’agent en une commande jusqu’à la configuration via le web qui élimine l’édition manuelle des fichiers.
Elle propose des rapports et des alertes prêts à l’emploi, permettant aux utilisateurs d’obtenir des informations immédiates et de définir des conditions d’alerte en quelques secondes.
Son agent open source est transparent, auditable et conçu pour fonctionner sur un large éventail de distributions Linux.
Fonctionnalités clés
- Installation en une commande : l’agent open source s’installe avec une seule commande, réduisant considérablement le temps et la complexité de configuration.
- Supervision unifiée : combine métriques et journaux dans un système unique, offrant une vue holistique des performances du serveur.
- Configuration via interface web : toutes les configurations, des métriques aux alertes, sont gérées depuis une interface web intuitive, éliminant le besoin de fichiers de configuration complexes.
- Compatible mobile : propose une Progressive Web App (PWA) pour superviser l’infrastructure et recevoir des alertes de n’importe où.
Avantages
- Simplicité et facilité d’utilisation : la plateforme est conçue pour une adoption rapide, même par des utilisateurs aux connaissances limitées en supervision.
- Tarification transparente : Simple Observability propose un modèle à prix fixe et clair, sans surprise liée à l’usage, ce qui peut constituer un avantage décisif face à la concurrence.
- Agent open source : la nature open source de l’agent offre une transparence totale et permet aux utilisateurs d’auditer le code.
Inconvénients
- Personnalisation limitée : si la simplicité est un atout, elle peut aussi être un frein pour les utilisateurs avancés qui nécessitent un contrôle plus fin et une personnalisation au-delà des fonctionnalités intégrées.
Prix
Simple Observability propose un plan gratuit et une tarification simple par serveur :
- Gratuit : un serveur, 50 métriques, volume de journaux faible.
- Payant : 3 $ par mois et par serveur, 100 métriques par serveur, volume de journaux élevé, serveurs illimités.
- Sur mesure : remises volume et rétention personnalisée pour les grandes infrastructures.
Checkmk
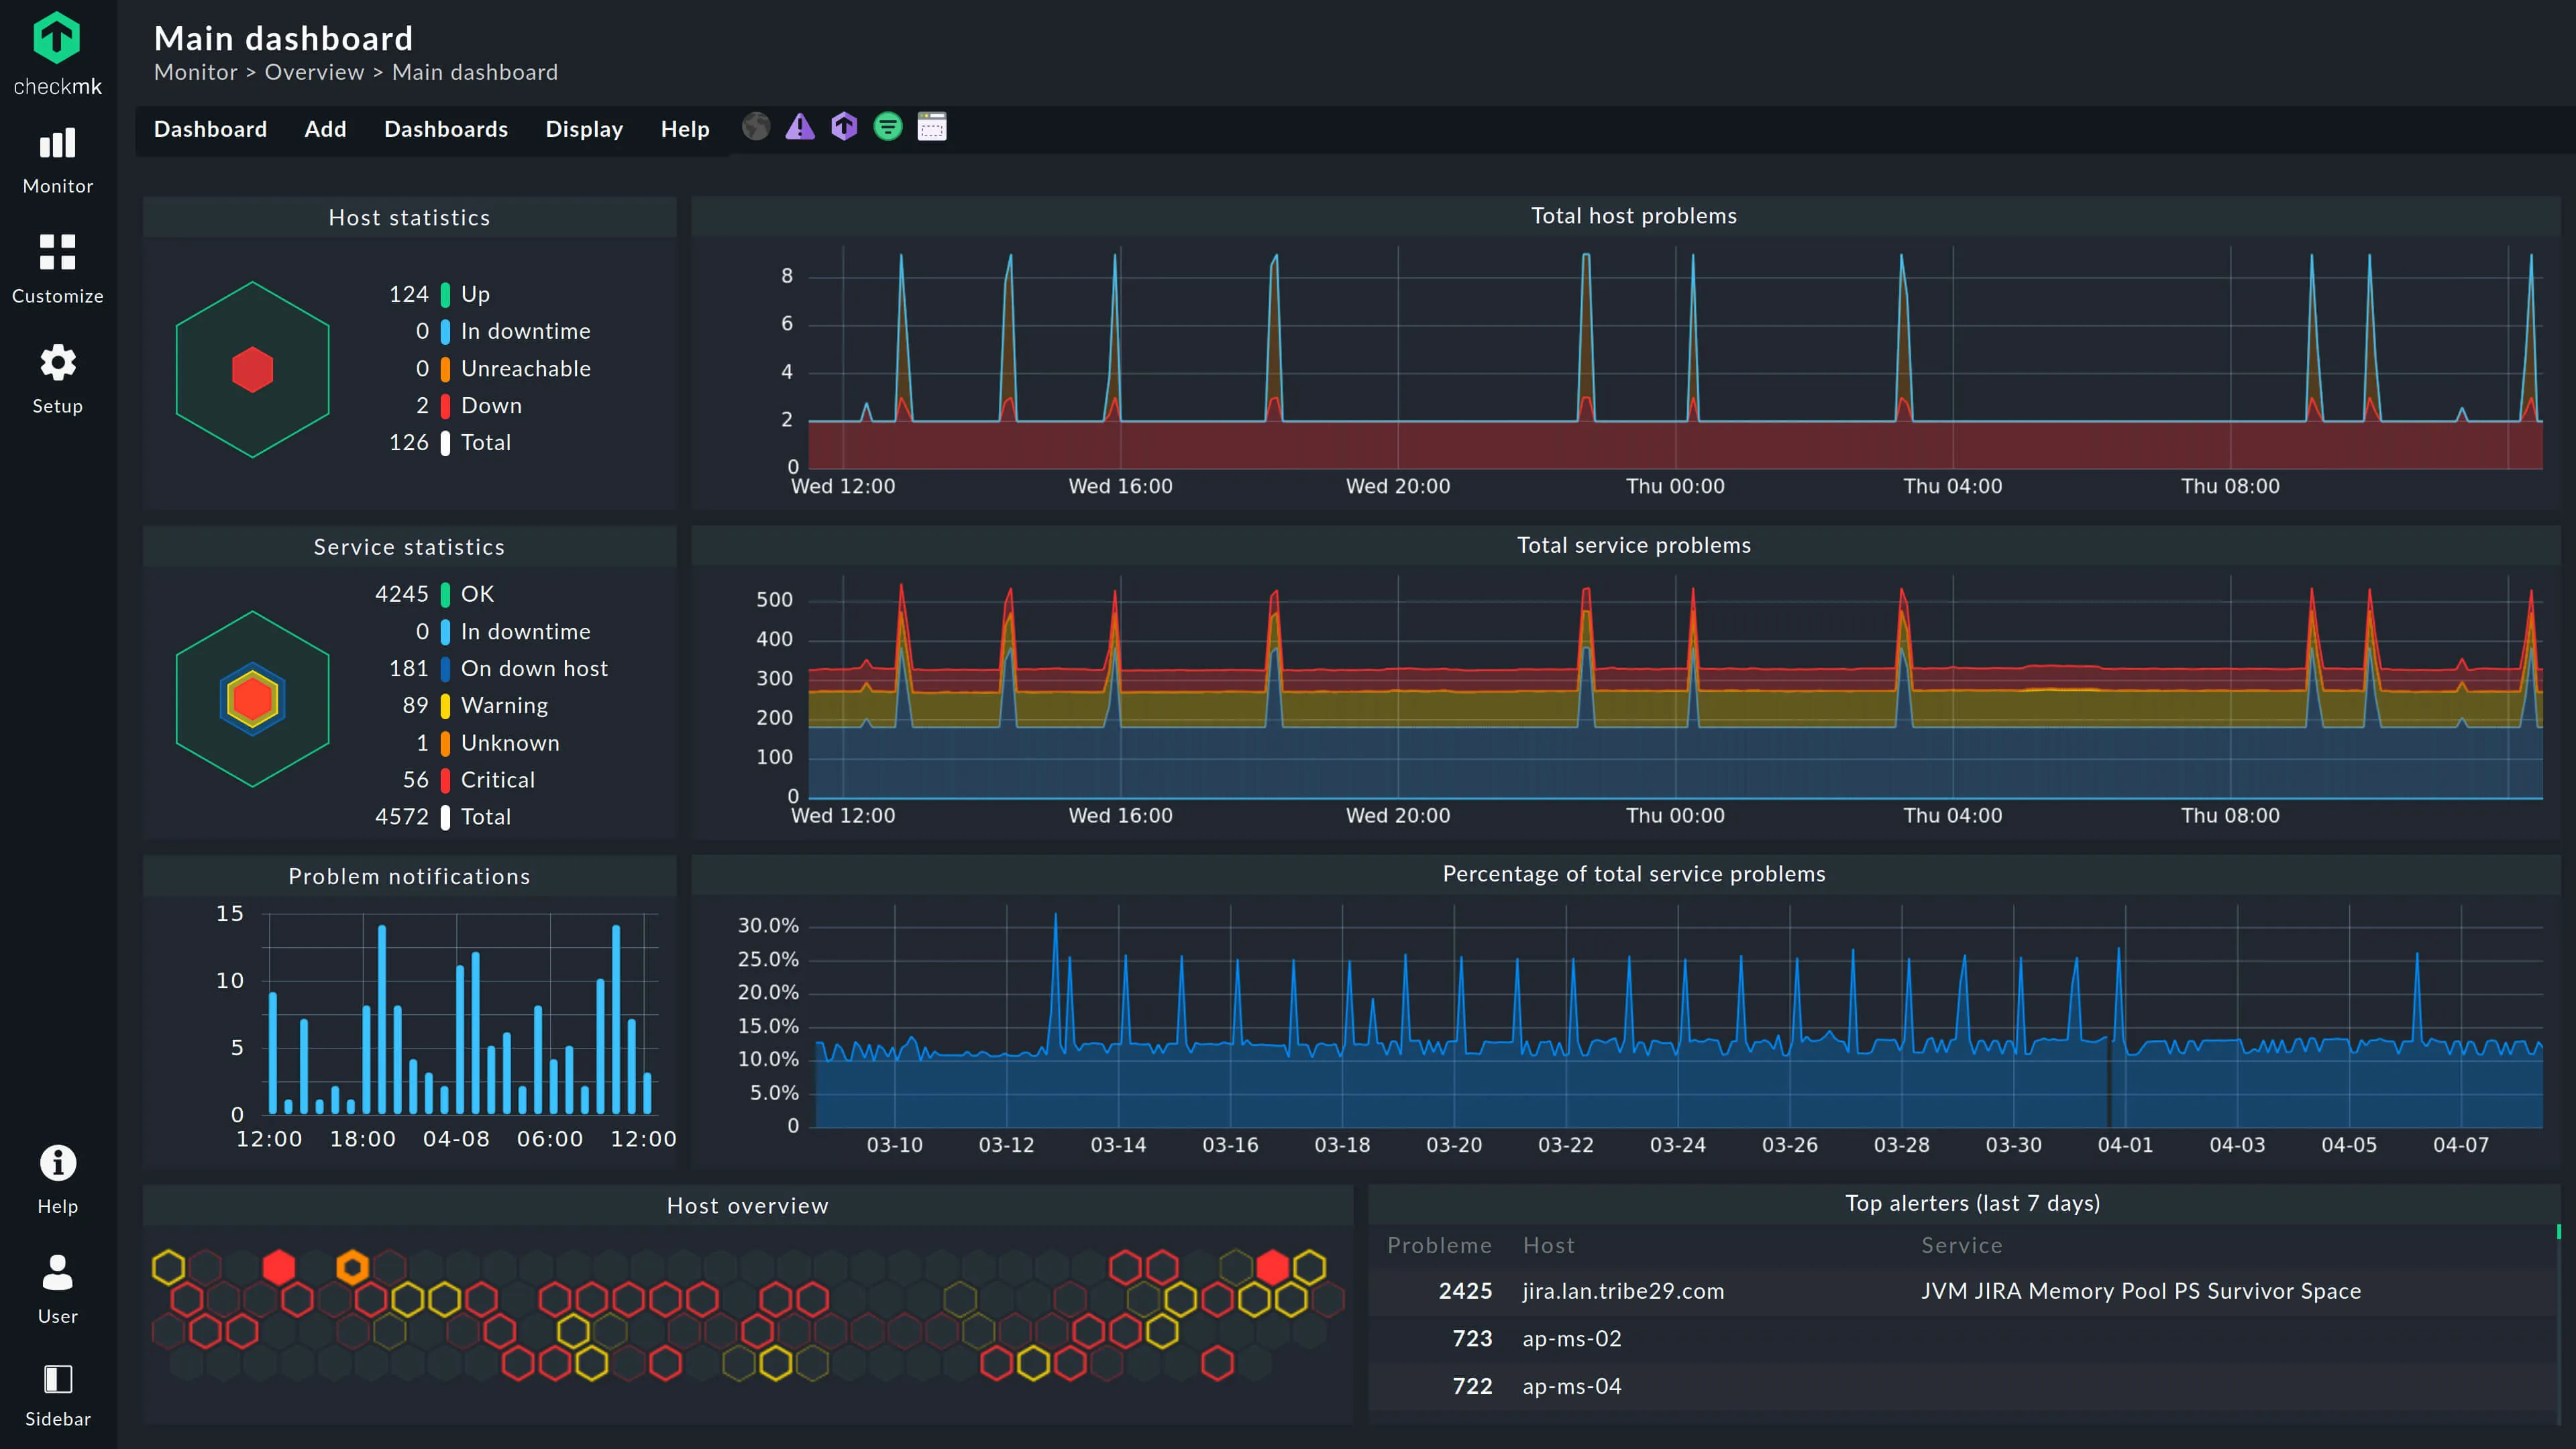
Checkmk est une plateforme de supervision open source complète pour applications, serveurs et réseaux, en local comme dans le cloud. Elle est conçue pour superviser sans effort tout, des environnements informatiques les plus simples aux plus complexes.
Checkmk dispose de plus de 2 000 plugins de supervision pour un large éventail de périphériques, notamment des serveurs, des switchs, des bases de données et des serveurs web.
L’édition communautaire gratuite est auto-hébergée avec un ensemble de fonctionnalités limité et prend en charge la supervision avec et sans agent.
Checkmk peut aussi découvrir et cartographier automatiquement votre réseau.
Fonctionnalités clés
- Découverte automatique des services : détecte automatiquement tous les composants pertinents d’un hôte et recommande les métriques et seuils appropriés pour la supervision.
- Visualisation : propose des tableaux de bord modernes et personnalisables, ainsi que des cartes graphiques.
Avantages
- Solution complète : supervise un large éventail de composants informatiques, des services cloud aux systèmes sur site, grâce à une vaste bibliothèque de plus de 2 000 plugins.
- Flexible : prend en charge la supervision avec et sans agent, et se révèle hautement personnalisable et extensible.
- Automatisé : réduit l’effort manuel grâce à des fonctionnalités comme la découverte automatique, la gestion du cycle de vie des hôtes et une API REST puissante.
Inconvénients
-
Courbe d’apprentissage et configuration difficile : bien que puissante, la plateforme peut présenter une courbe d’apprentissage abrupte.
Certains utilisateurs trouvent sa configuration complexe, en particulier pour les fonctionnalités avancées.
Prix
Checkmk propose un modèle auto-hébergé avec des licences payantes à partir d’environ 225 $ par mois, généralement pour un minimum de 100 hôtes.
Un modèle SaaS est également disponible, au prix d’environ 6 $ par hôte et par mois. La tarification est basée sur le nombre de services supervisés, où un hôte compte en moyenne environ 30 services.
Chaque groupe de 10 services est facturé environ 2 $ par mois, ce qui peut faire grimper les coûts rapidement.
Netdata
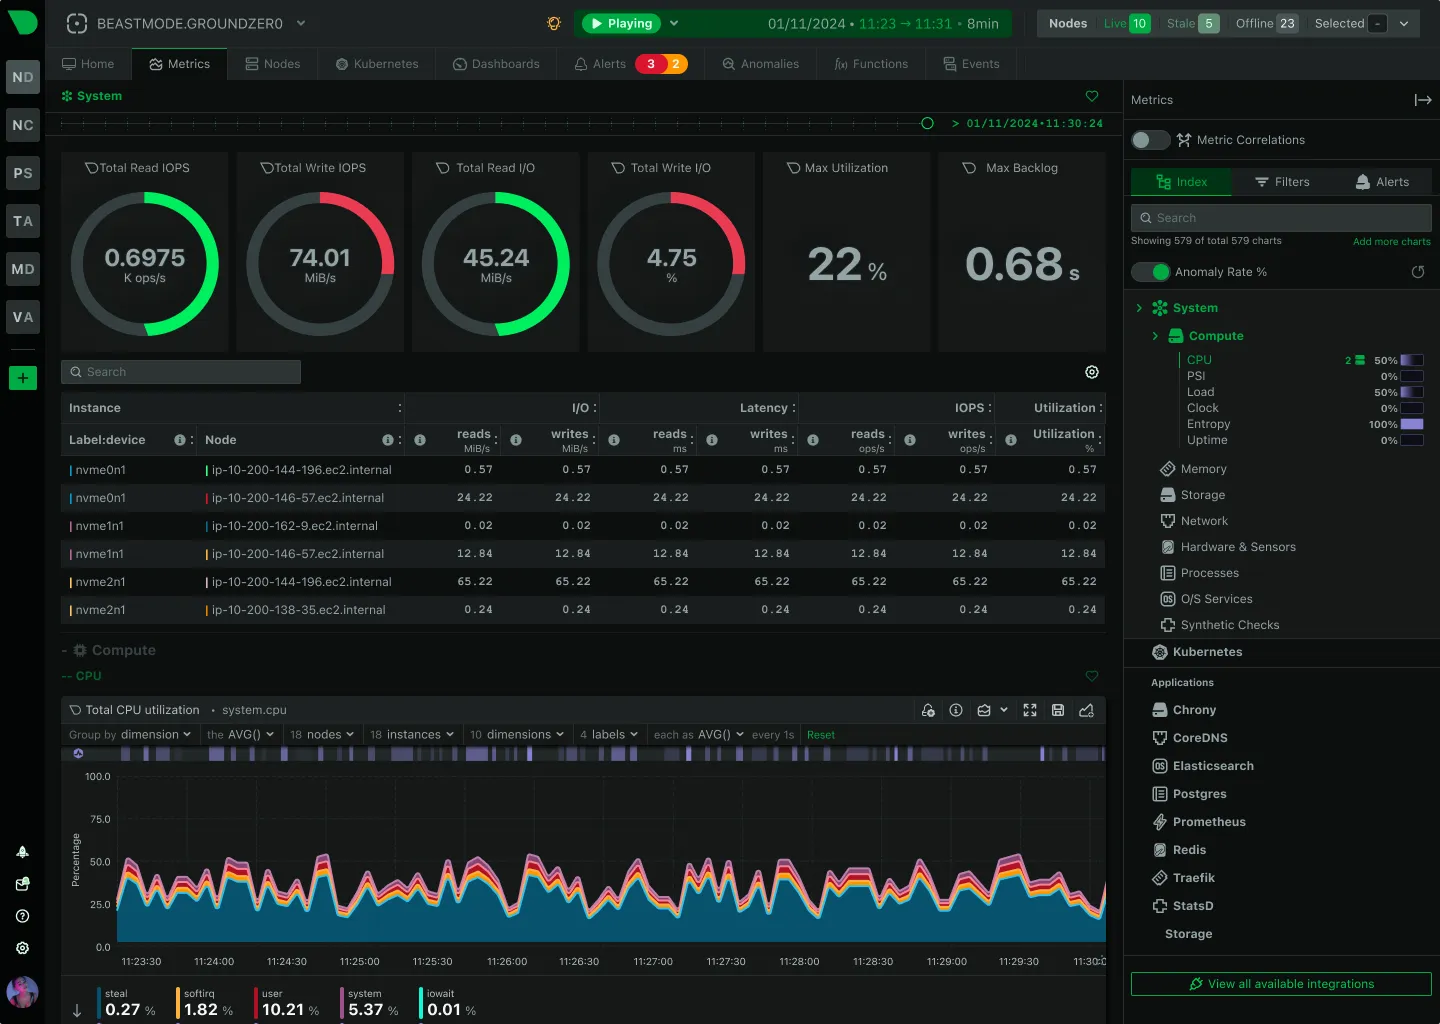
Netdata est une plateforme open source de supervision de performances et de dépannage en temps réel pour les systèmes et applications. Elle est conçue pour offrir une collecte de données haute résolution, à la seconde près, ce qui la rend idéale pour la détection immédiate et proactive des problèmes. Grâce à son architecture décentralisée, Netdata peut superviser des infrastructures entières, d’un serveur unique à des environnements distribués à grande échelle.
Netdata propose une solution d’observabilité intégrée tout-en-un, couvrant métriques, journaux, checks synthétiques et alertes.
Elle intègre une détection d’anomalies basée sur le machine learning et fournit des informations claires et exploitables sans exiger de connaissances approfondies en data science.
La découverte automatique et les alertes préconfigurées de la plateforme réduisent la configuration manuelle, permettant une mise en valeur rapide pour les équipes.
Fonctionnalités clés
- Collecte de données en temps réel à haute résolution : relève les métriques chaque seconde, offrant un retour instantané à faible latence.
- Détection d’anomalies par machine learning : utilise l’apprentissage automatique non supervisé pour apprendre automatiquement les schémas de charge et repérer les anomalies.
Avantages
- Valeur immédiate à l’installation : la découverte automatique des sources de données et les alertes préconfigurées permettent une utilisation immédiate après l’installation.
- Confidentialité des données : les données sont stockées sur site, garantissant qu’elles restent sur l’infrastructure de l’utilisateur.
Inconvénients
- Fonctionnalités manquantes : des fonctionnalités clés comme l’APM (Application Performance Monitoring) et la gestion des journaux sont encore en attente ou partiellement implémentées, ce qui peut limiter la supervision complète.
- Limites des données et du reporting : des utilisateurs ont signalé des difficultés liées à un manque d’informations, notamment concernant le reporting détaillé et la documentation des intégrations.
Prix
Netdata propose un modèle par abonnement à 6 $ par mois et par nœud.
Zabbix
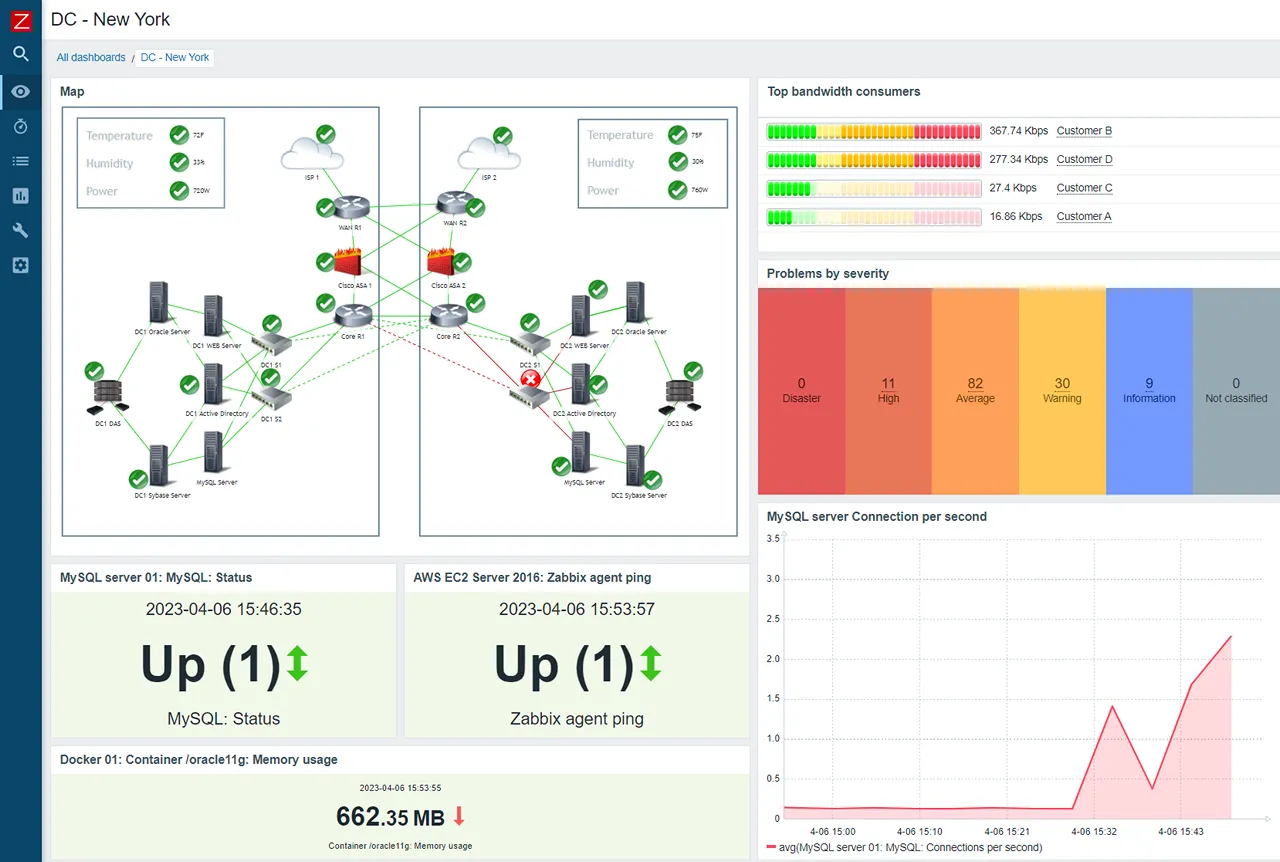
Zabbix est un logiciel open source de niveau entreprise pour superviser divers composants informatiques, notamment les réseaux, les serveurs, les machines virtuelles et les services cloud. Conçu pour gérer des environnements à grande échelle.
L’une des forces clés de Zabbix est sa capacité à collecter des données depuis pratiquement n’importe quelle source, via un large éventail de protocoles et de méthodes personnalisées. Le système d’alerte robuste de la plateforme offre plusieurs canaux et schémas d’escalade, garantissant que les problèmes critiques sont traités rapidement.
Fonctionnalités clés
- Détection avancée des problèmes : utilise des seuils intelligents, la prédiction de tendances et le machine learning pour détecter automatiquement les anomalies et classer les problèmes selon plusieurs niveaux de gravité.
- Alertes flexibles : prend en charge divers canaux de notification, tels que l’e-mail, les SMS et la messagerie instantanée, avec des messages personnalisables et des scénarios d’escalade.
Avantages
- Haute scalabilité : l’architecture de supervision distribuée, soutenue par les proxies Zabbix, permet une scalabilité illimitée pour superviser des milliers de périphériques sur plusieurs sites.
- Support du multi-tenant : propose des profils et des permissions flexibles, ce qui la rend adaptée aux fournisseurs de services devant offrir de la supervision à plusieurs clients dans un environnement isolé.
Inconvénients
- Courbe d’apprentissage abrupte : la complexité et l’étendue des fonctionnalités de Zabbix peuvent représenter un défi pour les nouveaux venus, exigeant un investissement en temps significatif pour la maîtriser.
- Accompagnement limité : certains utilisateurs ont signalé des difficultés liées à un manque de documentation exhaustive et de support communautaire, ce qui peut entraver une utilisation efficace et le dépannage.
- Pas de prise en charge de la gestion des journaux.
Prix
L’offre cloud de Zabbix démarre à 50 $/mois.
Nagios
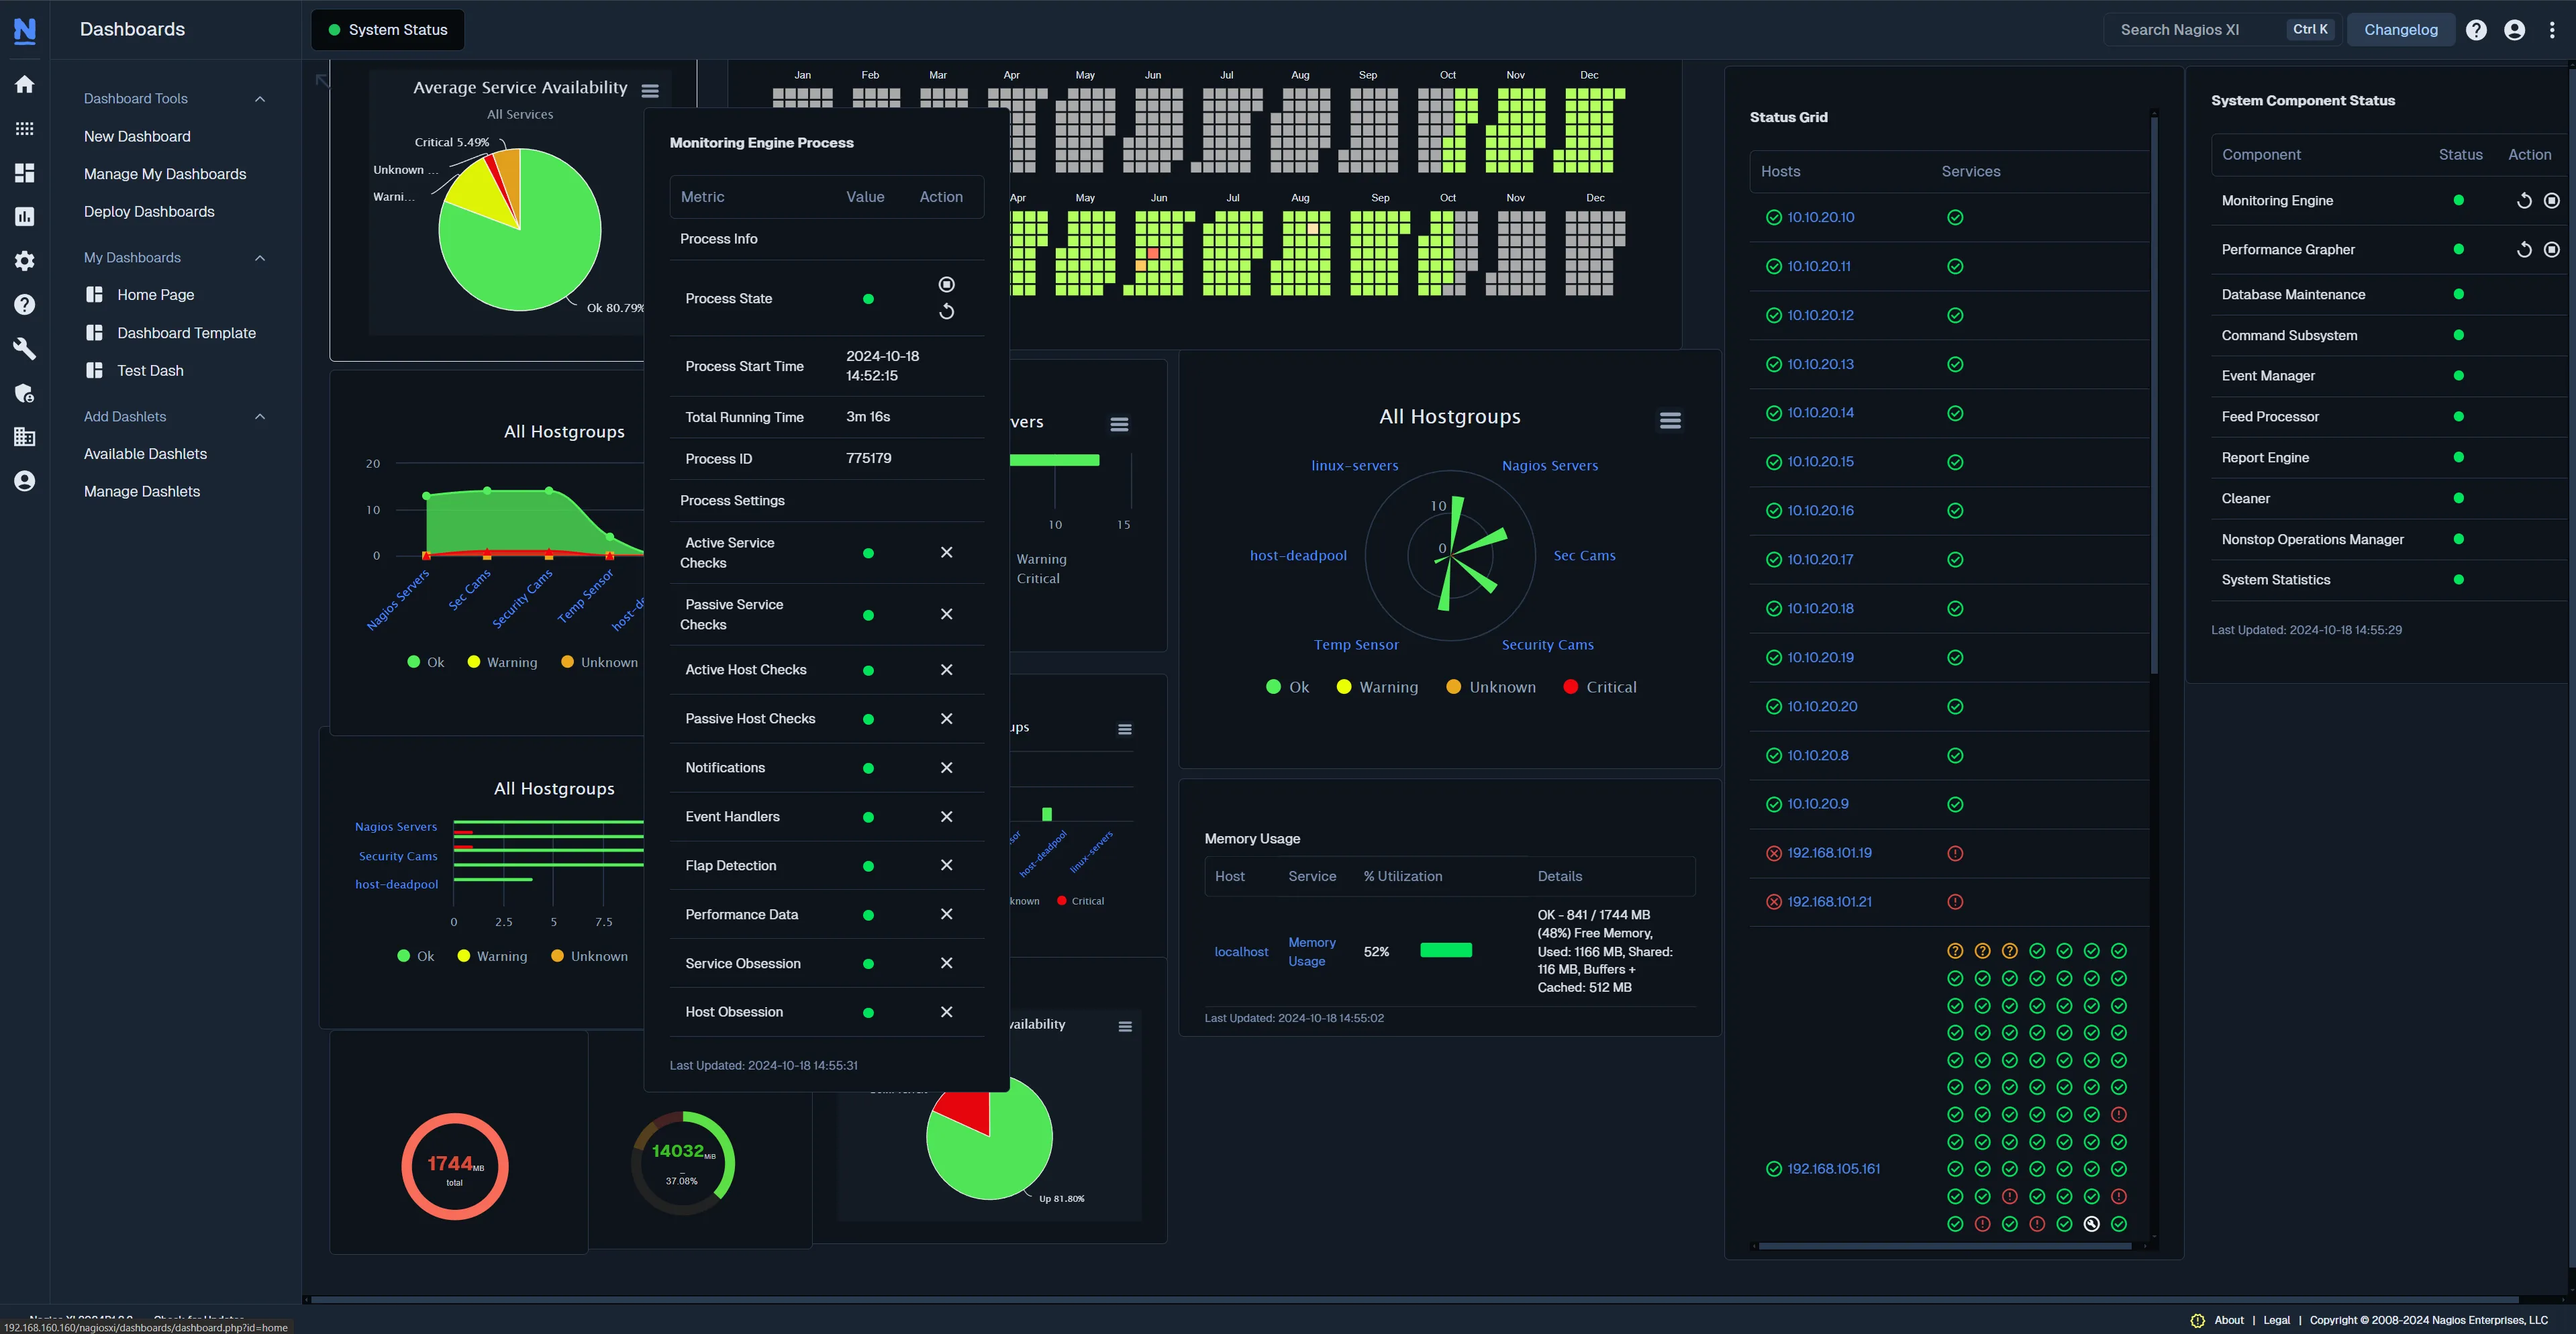
Nagios est une solution complète de supervision d’infrastructure de niveau entreprise qui offre une supervision étendue des composants informatiques critiques, des applications et des systèmes. Construit sur le puissant moteur de supervision Nagios Core 4, il est conçu pour être hautement scalable et efficace pour les organisations de toutes tailles, des petites entreprises aux grandes entreprises.
La plateforme offre une vue centralisée des données de supervision et des alertes proactives pour anticiper les problèmes d’infrastructure. Avec une interface graphique personnalisable, des assistants de configuration et des capacités multi-tenant, elle est conçue pour simplifier l’administration et offrir une expérience utilisateur fluide et intuitive. Les fonctionnalités de Nagios XI peuvent être étendues avec des milliers d’extensions développées par la communauté et par des tiers, ainsi que des API pour l’intégration avec d’autres applications.
Fonctionnalités clés
- Personnalisable et extensible : propose une interface graphique personnalisable et une architecture ouverte avec des extensions communautaires et des API d’intégration.
- Assistants de configuration : simplifient la configuration pour superviser de nouveaux périphériques et services.
Avantages
- Extrêmement flexible : le vaste écosystème de plugins et les API de la plateforme la rendent hautement adaptable à divers besoins de supervision.
- Scalabilité : construit sur Nagios Core 4, il est conçu pour une supervision efficace et scalable des environnements larges et distribués.
Inconvénients
- Courbe d’apprentissage abrupte : la configuration et l’installation initiales sont souvent considérées comme complexes, ce qui les rend ardues pour les nouveaux utilisateurs.
- Interface datée : certains utilisateurs trouvent l’interface web encombrée et moins moderne que celles des concurrents.
- Tarification : le coût peut être considéré comme élevé, en particulier pour l’édition entreprise et les déploiements de grande ampleur.
Prix
La tarification démarre à 2 495 $ pour une licence de 100 nœuds.
Conclusion
Choisir la bonne solution de supervision de serveurs dépend entièrement de vos besoins spécifiques et de votre aisance technique.
Pour ceux qui privilégient la simplicité, la facilité d’utilisation et une configuration rapide, Simple Observability se distingue.
Son interface unifiée, son installation en une commande et sa tarification transparente en font un choix idéal pour les équipes cherchant à être opérationnelles rapidement, sans courbe d’apprentissage abrupte ni fichiers de configuration complexes.
Si votre environnement est vaste et complexe, avec des périphériques et des serveurs répartis sur plusieurs sites, Checkmk et Zabbix offrent la puissance et la flexibilité nécessaires pour gérer une infrastructure étendue. Leurs courbes d’apprentissage abruptes sont le compromis à accepter pour leur scalabilité massive et leurs fonctionnalités avancées.
Pour ceux centrés sur les données en temps réel et une approche proactive de la détection des problèmes, Netdata offre une solution unique et puissante. Enfin, Nagios reste un choix fiable et hautement personnalisable pour les grandes entreprises qui ont besoin d’un système éprouvé et scalable.
Au final, choisir le bon outil revient à trouver le point d’équilibre entre fonctionnalité et utilisabilité, en adéquation avec vos objectifs opérationnels et les compétences de votre équipe.